

私有、本地与自托管AI
本地模型、私有化部署模式、自托管推理和混合架构。
18 项内容 (12 篇文章 · 6 个视频)
从这里开始
浏览完整内容之前,先阅读几篇推荐文章。
 10 分钟阅读
在Mac上运行本地AI:Ollama、LM Studio,以及7B模型究竟能做什么
本地运行AI已日趋成熟。借助Ollama或LM Studio和一台现代Mac,你可以离线、免费且私密地运行能力不俗的模型。本文将介绍哪些方法可行、哪些不可行,以及真正能从中受益的使用场景。
中级 10 分钟阅读
私有 AI 部署模式:本地、VPC、自托管和混合
私有 AI 并非单一架构。本文面向重视隐私和控制权的中小企业,对比本地模型、企业 SaaS、VPC 部署、自托管推理和混合模式。
高级 11 分钟阅读
自托管与托管式推理:一个可审计的盈亏平衡模型
自托管要达到什么规模才会比 API 调用更划算?本文介绍实际计算、运维现实,以及区分哪些团队应该自托管、哪些团队应该继续为托管推理付费的模式。
高级此主题下的更多内容
 8 分钟阅读
连接两台 DGX Spark:QSFP、SSH、RoCE 与 Cluster Assistant
用 QSFP 与 ConnectX-7 连接两台 NVIDIA DGX Spark 的实用指南:相同用户名、免密 SSH、面向分布式工作负载的 RoCE、NVIDIA Sync Cluster Assistant,以及回滚。
高级 8 分钟阅读
DGX Spark 本地推理的现实:内存、技术栈,以及云端何时仍占优势
DGX Spark 的 128 GB 相干统一内存实际意味着什么、如何理解 NVIDIA 约 200B 单节点主张、如何筛选服务技术栈,以及如何设计决定本地推理是否适用的硬件测试。
高级 9 分钟阅读
DGX Spark:是什么、为谁而设,以及对本地智能体改变了什么
对 NVIDIA DGX Spark 的务实解读:NVIDIA 公布的 Grace Blackwell GB10 规格、相干统一内存、ConnectX-7 集群能力,以及何时桌边智能体计算机适合作为私有 AI 方案。
高级 7 分钟阅读
Hermes Agent:它是什么、不是什么,何时该用
清晰梳理 Nous Research 的 Hermes Agent:持久记忆、技能、工具与消息网关,并说明何时聊天机器人已经够用,何时需要智能体运行时。
中级 8 分钟阅读
从 n8n 调用 vLLM 及其他 OpenAI 兼容端点
通过 n8n 的 HTTP Request 节点调用本地 OpenAI 兼容的 /v1/chat/completions 端点,并明确配置身份验证、超时预算、base URL 检查和私有网络边界。
中级 10 分钟阅读
DGX Spark 上的 NemoClaw:部署与安全计划
规划并评估如何在 DGX Spark 的 NVIDIA OpenShell 中运行 OpenClaw、Hermes 或 Deep Agents Code:当前上手流程、策略层、路由推理,以及上线前必须取得的验收证据。
高级 9 分钟阅读
OpenClaw 个人网关设置:安装、初始配置与控制台
OpenClaw 是什么、如何安装并完成自托管多渠道网关的初始配置、在 18789 端口打开 Control UI,以及支持哪些 Node 版本,同时不跳过安全基线。
中级 10 分钟阅读
实验性双 DGX Spark + DeepSeek-V4-Flash + n8n + Hermes 栈
如何评估面向 DeepSeek-V4-Flash 的实验性社区双 DGX Spark 路径:用 n8n 处理确定性流程,用 Hermes 处理需要判断的流程。
高级 37 分钟
Broadcom介绍VMware Private AI Foundation的能力与功能更新
Tech Field Day. 视频将私有AI呈现为分层基础设施:受控算力、隔离环境、Kubernetes、推理容器、模型治理、自助式资源配置、GPU共享和监控。这与文章的提醒直接对应:隐私取决于部署边界、日志、访问控制和运营,而不是“本地”这一个词。
高级 13 分钟阅读
2026 年的微调:以证据为先的 LoRA 和 QLoRA 实验
判断参数高效微调是否合理,治理数据,固定可复现实验,对比留出集与安全结果,并在部署前对服务性能做基准测试。
高级 157 分钟
LLM模型微调:生成式AI课程
freeCodeCamp.org. 这是一门先讲理论、再写代码的长课程,涵盖量化、LoRA、QLoRA,以及在Llama 2和Gemma上进行完整的PEFT,并使用大多数开发者实际拥有的硬件。它几乎是YouTube上最接近“跟着有实战经验的人从头做一遍”的内容,还通过具体的显存预算印证了文章中“你不需要集群”的观点。
高级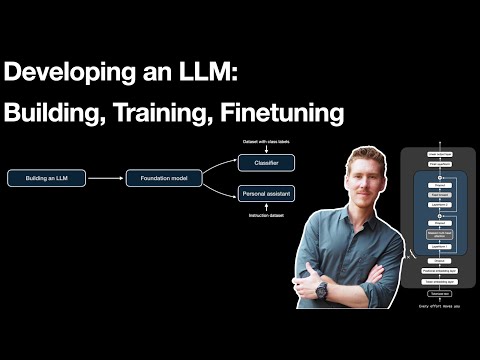 59 分钟
开发LLM:构建、训练与微调
Sebastian Raschka. Sebastian Raschka以较慢的节奏讲解微调在更广泛LLM训练流程中的位置,包括指令微调、分类微调、参数高效方法,以及文章在推荐LoRA前指出的各种权衡。它适合在开始前校准认知,尤其适合仍在讨论微调是否真是正确下一步的团队。
高级 14 分钟
15分钟学会Ollama——免费在本地运行大语言模型
Tech With Tim. 简洁直接的Ollama实操教程——安装、拉取模型、对话,然后用Python调用本地HTTP API,并通过Modelfile创建自定义模型。内容恰好覆盖文章所述的Mac日常使用流程,也讲解了如何根据机器的RAM考虑模型大小。
中级 6 分钟
LM Studio教程:在笔记本电脑上运行大语言模型
Kevin Stratvert. 通过图形界面完成与Ollama相同的工作流:下载LM Studio、拉取Llama或Gemma模型、进行对话,以及放入PDF并就其内容提问。适合不想一直使用终端的读者,也有助于直观比较1B–3B模型与更大模型的实际表现。
中级 32 分钟
使用vLLM与PagedAttention实现高速LLM推理服务
Anyscale. 视频讲解了为什么朴素的LLM推理服务会浪费60–80%的GPU内存、PagedAttention如何借鉴操作系统式分页来解决这一问题,以及连续批处理为何能实现文章在计算中采用的24×吞吐量。看完后,文章中“利用率能达到50%就算幸运”这句话就不再抽象。
高级