

Yksityinen, paikallinen ja itse ylläpidetty tekoäly
Paikalliset mallit, yksityiset käyttöönottomallit, itse ylläpidetty inferenssi ja hybridiarkkitehtuurit.
15 sisältöä (11 artikkelia · 4 videota)
Aloita tästä
Muutama hyvä aloitussisältö ennen koko sisältövirran selaamista.
 10 min lukemista
Yksityisen tekoälyn käyttöönottomallit: paikallinen, VPC, itseisännöity ja hybridi
Yksityinen tekoäly ei tarkoita yhtä arkkitehtuuria. Käytännön vertailu paikallisista malleista, yritystason SaaS-palveluista, VPC-toteutuksista, itseisännöidystä päättelystä ja hybridimalleista pk-yrityksille, jotka arvostavat tietosuojaa ja hallintaa.
Edistynyt 11 min lukemista
Itseisännöity vai hallinnoitu päättely: auditoitava kannattavuusmalli
Missä mittakaavassa itseisännöinti voittaa API-kutsut? Käy läpi todellinen laskelma, käytännön vastuut ja ne piirteet, jotka ratkaisevat, sopiiko tiimille itseisännöinti vai hallinnoitu päättely.
EdistynytLisää tässä aiheessa
 8 min lukemista
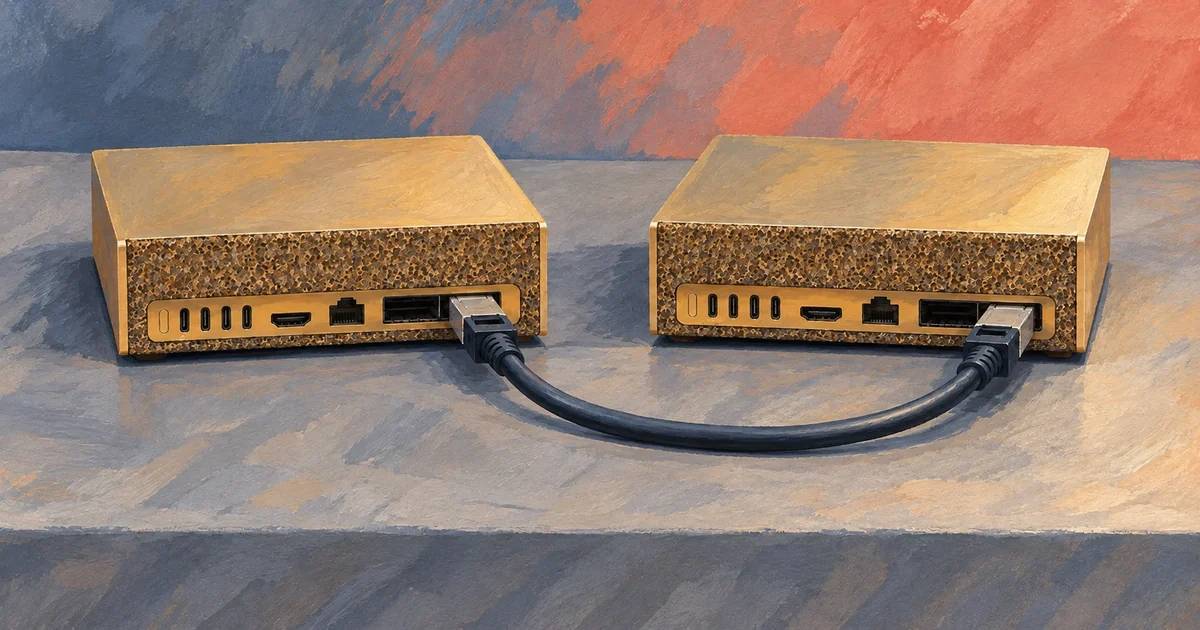
Yhdistä kaksi DGX Sparkia: QSFP, SSH, RoCE ja Cluster Assistant
Käytännön opas kahden NVIDIA DGX Spark -laitteen yhdistämiseen QSFP:n ja ConnectX-7:n avulla: sama käyttäjänimi, salasanaton SSH, hajautettujen työkuormien RoCE-yhteys, NVIDIA Sync Cluster Assistant ja turvallinen palautus.
Edistynyt 8 min lukemista
DGX Sparkin paikallinen inferenssi käytännössä: muisti, ohjelmistopino ja milloin pilvi voittaa
Näin tulkitset NVIDIAn väitteitä 128 Gt:n koherentista muistista ja ~200B-parametriluokan yhden solmun malleista, valitset arvioitavat mallipalvelupinot ja suunnittelet laitetestit, jotka ratkaisevat paikallisen inferenssin sopivuuden.
Edistynyt 9 min lukemista
DGX Spark: mikä se on, kenelle se sopii ja mitä se muuttaa paikallisten agenttien ajamisessa
Realistinen arvio NVIDIA DGX Sparkista: NVIDIAn ilmoittamat Grace Blackwell GB10 -tekniset tiedot, koherentti yhtenäismuisti, ConnectX-7-klusterointi ja tilanteet, joissa työpöydälle sijoitettava agenttipalvelin on perusteltu yksityisen tekoälyn valinta.
Edistynyt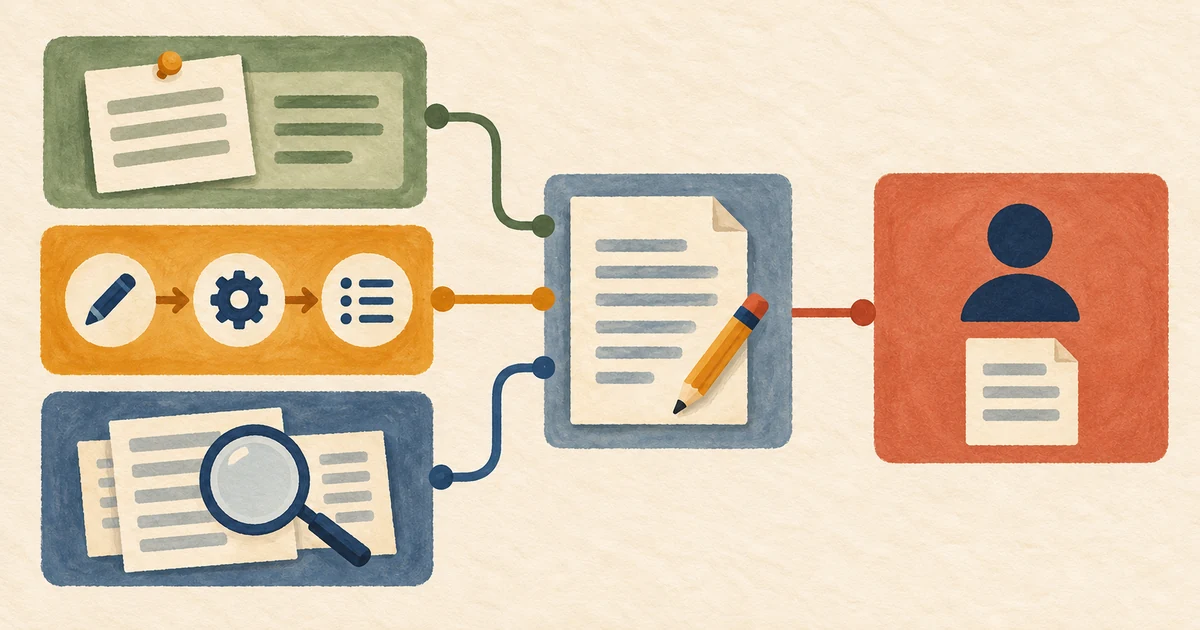 7 min lukemista
Hermes Agent: mitä se on, mitä se ei ole ja milloin sitä kannattaa käyttää
Selkeä yleiskuva Nous Researchin Hermes Agentista: pysyvä muisti, Skills-paketit, työkalut ja viestiyhdyskäytävät sekä perusteet sille, milloin keskustelubotti riittää ja milloin agentin ajoympäristö on oikea ratkaisu.
Keskitaso 8 min lukemista
Kutsu vLLM:ää ja muita OpenAI-yhteensopivia päätepisteitä n8n:stä
Kutsu paikallista OpenAI-yhteensopivaa /v1/chat/completions-päätepistettä n8n:n HTTP Request -solmusta. Määritä todennus, aikakatkaisubudjetti ja perusosoite täsmällisesti ja pidä palvelu yksityisen verkkorajan sisällä.
Keskitaso 10 min lukemista
NemoClaw DGX Sparkissa: käyttöönotto- ja tietoturvasuunnitelma
Suunnittele ja arvioi OpenClaw-, Hermes- tai Deep Agents Code -agentin käyttöä NVIDIA OpenShellissä DGX Sparkissa: nykyinen käyttöönotto, suojauskerrokset, reititetty inferenssi ja vaadittava hyväksyntänäyttö.
Edistynyt 9 min lukemista
Henkilökohtaisen OpenClaw-yhdyskäytävän käyttöönotto: asennus, ohjattu aloitus ja hallintapaneeli
Mikä OpenClaw on, miten itse ylläpidettävä monikanavainen yhdyskäytävä asennetaan ja otetaan käyttöön, miten Control UI avataan portissa 18789 ja mitkä Node-versiot ovat tuettuja tietoturvan perustasosta tinkimättä.
Keskitaso 10 min lukemista
Kokeellinen kahden DGX Sparkin, DeepSeek-V4-Flashin, n8n:n ja Hermeksen kokonaisuus
Näin arvioit yhteisön kokeellista kahden DGX Sparkin DeepSeek-V4-Flash-ratkaisua, jossa n8n hoitaa deterministiset vaiheet ja Hermes harkintaa vaativat tehtävät.
Edistynyt 37 minuuttia
VMware Private AI Foundationin ominaisuudet ja toiminnot – päivitys Broadcomilta
Tech Field Day. Näyttää yksityisen tekoälyn kerroksellisena infrastruktuurina: kontrolloitu laskenta, eristetyt ympäristöt, Kubernetes, inferenssikontit, mallinhallinta, self-service-provisionointi, GPU:n jakaminen ja valvonta. Se kartoittuu suoraan artikkelin varoitukseen, että tietosuoja riippuu käyttöönoton rajoista, lokeista, pääsystä ja operaatioista, ei sanasta ”paikallinen”.
Edistynyt 13 min lukemista
Hienosäätö vuonna 2026: näyttöön perustuva LoRA- ja QLoRA-koe
Päätä, onko parametritehokas hienosäätö perusteltua, hallitse aineistoa, määritä toistettava koe, vertaa erillisen testijoukon tuloksia ja turvallisuustuloksia sekä mittaa palvelun suorituskyky ennen käyttöönottoa.
Edistynyt 157 minuuttia
LLM-mallien fine-tuning – generatiivisen tekoälyn kurssi
freeCodeCamp.org. Kurssi käsittelee kvantisointia, LoRA:a, QLoRA:a ja PEFT:iä Llama 2:n ja Gemman avulla. Kurssi näyttää kokoonpanokohtaisia VRAM-esimerkkejä. Artikkeli edellyttää valitun mallin ja laitteiston mittauksia; esimerkit eivät osoita, että kaikki soveltuvat tehtävät onnistuvat ilman klusteria.
Edistynyt 59 minuuttia
LLM:n kehittäminen: rakentaminen, koulutus, fine-tuning
Sebastian Raschka. Raschkan yleiskatsaus sijoittaa hienosäädön mallin koulutusprosessiin. Artikkeli perustelee LoRA-kokeen tehtävässä mitatulla puutteella suhteessa perusratkaisuun ja edellyttää resurssien tarkistamista sekä sovittimen arviointia ennen julkaisua.
Edistynyt 32 minuuttia
Nopea LLM-palvelu vLLM:llä ja PagedAttentionilla
Anyscale. Esitys käy läpi vLLM-tutkimuksessa raportoidun muistin hukkakäytön, PagedAttentionin käyttöjärjestelmistä lainaaman sivutusidean ja jatkuvan eräkäsittelyn vaikutuksen läpäisykykyyn. Videon luvut koskevat sen omia vertailuasetelmia, mutta mekanismit auttavat ymmärtämään artikkelin käyttöastelaskelmaa.
Edistynyt