

Private, lokale und selbst gehostete KI
Lokale Modelle, private Bereitstellungsmuster, selbst gehostete Inferenz und hybride Architekturen.
15 Beiträge (11 Artikel · 4 Videos)
Hier beginnen
Einige gute Beiträge für den Einstieg, bevor Sie die vollständige Übersicht durchsuchen.
 10 Min. Lesezeit
Bereitstellungsmuster für private KI: lokal, in der VPC, selbst gehostet und hybrid
Private KI ist keine einzelne Architektur. Ein praktischer Vergleich lokaler Modelle, Enterprise-SaaS, VPC-Bereitstellungen, selbst gehosteter Inferenz und hybrider Muster für KMU, denen Datenschutz und Kontrolle wichtig sind.
Fortgeschritten 11 Min. Lesezeit
Self-Hosting oder gehostete Inferenz: ein überprüfbares Break-even-Modell
Ab welchem Umfang ist Self-Hosting günstiger als API-Aufrufe? Die tatsächliche Kostenrechnung, die betrieblichen Anforderungen und die Merkmale, anhand derer Teams zwischen Eigenbetrieb und verwalteter Inferenz entscheiden können.
FortgeschrittenWeitere in diesem Thema
 8 Min. Lesezeit
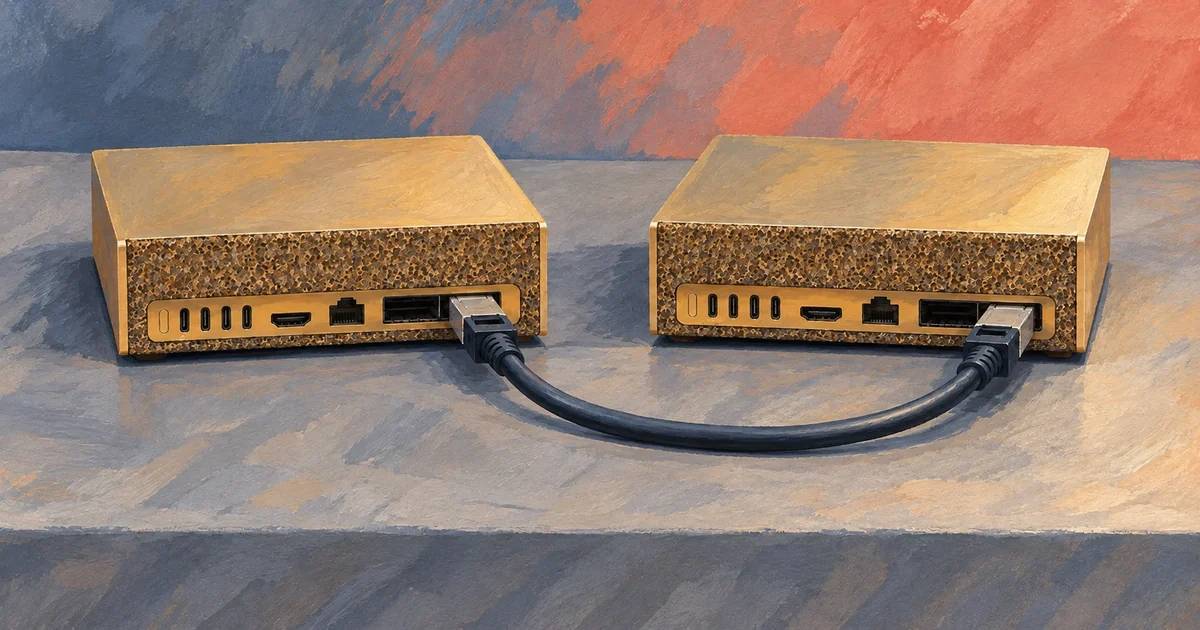
Zwei DGX Sparks verbinden: QSFP, SSH, RoCE und Cluster Assistant
Ein praktischer Leitfaden zum Verbinden zweier NVIDIA DGX Sparks mit QSFP und ConnectX-7: gleicher Benutzername, passwortloses SSH, RoCE für verteilte Workloads, NVIDIA Sync Cluster Assistant und Rollback.
Fortgeschritten 8 Min. Lesezeit
Lokale Inferenz auf DGX Spark: Speicher, Stack und wann die Cloud weiterhin gewinnt
So ordnen Sie NVIDIAs Angaben zu 128 GB kohärentem Speicher und zur ~200B-Klasse auf einem Knoten ein, wählen Serving-Stacks aus und entwerfen die Hardwaretests, die über den Einsatz lokaler Inferenz entscheiden.
Fortgeschritten 9 Min. Lesezeit
DGX Spark: was es ist, für wen es gedacht ist und was sich für lokale Agenten geändert hat
Eine sachliche Einordnung von NVIDIA DGX Spark: die Grace-Blackwell-GB10-Spezifikationen von NVIDIA, kohärenter Unified Memory, ConnectX-7-Clustering und die Frage, wann ein Agentenrechner am Schreibtisch die richtige Wahl für private KI ist.
Fortgeschritten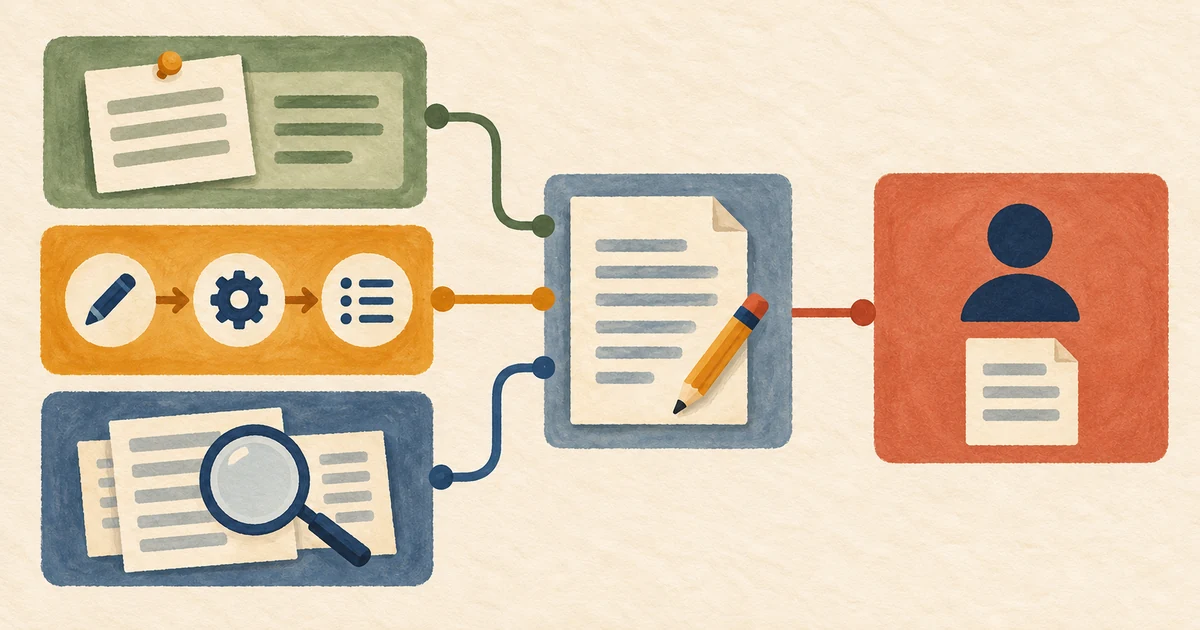 7 Min. Lesezeit
Hermes Agent: Was er ist, was er nicht ist und wann Sie ihn einsetzen sollten
Ein klarer Überblick über Hermes Agent von Nous Research: persistentes Gedächtnis, Skills, Tools und Messaging-Gateways sowie eine Entscheidungshilfe, wann ein Chatbot ausreicht und wann eine Agent-Runtime das richtige Werkzeug ist.
Mittelstufe 8 Min. Lesezeit
vLLM und andere OpenAI-kompatible Endpunkte aus n8n aufrufen
Rufen Sie einen lokalen OpenAI-kompatiblen /v1/chat/completions-Endpunkt über den HTTP Request-Node von n8n auf, mit expliziter Authentifizierung, gemessenen Zeitlimits, geprüfter Basis-URL und einer privaten Netzwerkgrenze.
Mittelstufe 10 Min. Lesezeit
NemoClaw auf DGX Spark: Deployment- und Sicherheitsplan
OpenClaw, Hermes oder Deep Agents Code in NVIDIA OpenShell auf DGX Spark planen und bewerten: aktuelles Onboarding, Policy-Schichten, geroutete Inferenz und die erforderlichen Abnahmenachweise.
Fortgeschritten 9 Min. Lesezeit
Persönliches OpenClaw-Gateway einrichten: Installation, Onboarding und Dashboard
Was OpenClaw ist, wie Sie das selbst gehostete Multikanal-Gateway installieren und einrichten, die Control UI auf Port 18789 öffnen und unterstützte Node-Versionen wählen, ohne die grundlegenden Sicherheitsmaßnahmen zu überspringen.
Mittelstufe 10 Min. Lesezeit
Experimenteller Stack aus zwei DGX Sparks, DeepSeek-V4-Flash, n8n und Hermes
So bewerten Sie einen experimentellen Community-Pfad für DeepSeek-V4-Flash auf zwei DGX-Spark-Systemen, mit n8n für die deterministische Automatisierung und Hermes für Urteilsaufgaben.
Fortgeschritten 37 Minuten
Update von Broadcom zu Funktionen und Möglichkeiten der VMware Private AI Foundation
Tech Field Day. Das Video zeigt private KI als mehrschichtige Infrastruktur: kontrollierte Rechenressourcen, isolierte Umgebungen, Kubernetes, Inferenzcontainer, Modell-Governance, Self-Service-Bereitstellung, gemeinsame GPU-Nutzung und Monitoring. Das entspricht direkt der Warnung des Artikels, dass Datenschutz von Bereitstellungsgrenzen, Logs, Zugriffen und Betriebsprozessen abhängt und nicht vom Etikett „lokal“.
Fortgeschritten 13 Min. Lesezeit
Fine-Tuning 2026: ein evidenzgeleitetes LoRA- und QLoRA-Experiment
Prüfen Sie, ob parametereffizientes Fine-Tuning gerechtfertigt ist, verwalten Sie die Daten, legen Sie ein reproduzierbares Experiment fest, vergleichen Sie Ergebnisse mit zurückgehaltenen Daten und Sicherheitstests und benchmarken Sie den Serving-Betrieb vor dem Deployment.
Fortgeschritten
LLM-Modelle feinabstimmen – Kurs zu generativer KI
freeCodeCamp.org. Der Kurs behandelt Quantisierung, LoRA, QLoRA und PEFT anhand von Llama 2 und Gemma. Der Kurs zeigt konkrete Beispiele für den VRAM-Bedarf einzelner Konfigurationen. Der Artikel verlangt Messungen für das gewählte Modell und die gewählte Hardware; die Beispiele belegen nicht, dass jede geeignete Aufgabe ohne Cluster auskommt.
Fortgeschritten
Ein LLM entwickeln: Aufbau, Training und Fine-Tuning
Sebastian Raschka. Raschkas Überblick ordnet Fine-Tuning in die Modelltrainingspipeline ein. Der Artikel begründet ein LoRA-Experiment anhand einer gemessenen Lücke gegenüber der Ausgangslösung auf der konkreten Aufgabe und verlangt Ressourcenprüfungen sowie die Evaluation des Adapters vor der Veröffentlichung.
Fortgeschritten 32 Minuten
Schnelle LLM-Bereitstellung mit vLLM und PagedAttention
Anyscale. Das Video erläutert ein Beispiel mit 60–80% verschwendetem GPU-Speicher, PagedAttention und Batching. Es ergänzt das Kostenmodell des Artikels bei gleichwertiger Qualität; messen Sie Kapazität und Auslastung für Ihre eigene Last.
Fortgeschritten