

Privat och lokal AI i egen drift
Lokala modeller, mönster för privat driftsättning, inferens i egen drift och hybridarkitekturer.
15 innehållsposter (11 artiklar · 4 videor)
Börja här
Börja med några rekommenderade innehållsposter innan du går igenom hela flödet.
 10 min läsning
Mönster för privat AI-driftsättning: lokal, VPC, egen drift och hybrid
Privat AI är inte en enda arkitektur. En praktisk jämförelse av lokala modeller, SaaS för företag, drift i VPC, inferens i egen regi och hybridmönster för små och medelstora företag som värdesätter integritet och kontroll.
Avancerad 11 min läsning
Egen drift jämfört med hanterad inferens: en granskningsbar brytpunktsmodell
Vid vilken skala blir egen drift billigare än API-anrop? Den faktiska matematiken, de operativa realiteterna och mönstren som skiljer team som bör driva i egen regi från team som bör fortsätta betala för hanterad inferens.
AvanceradMer i detta ämne
 8 min läsning
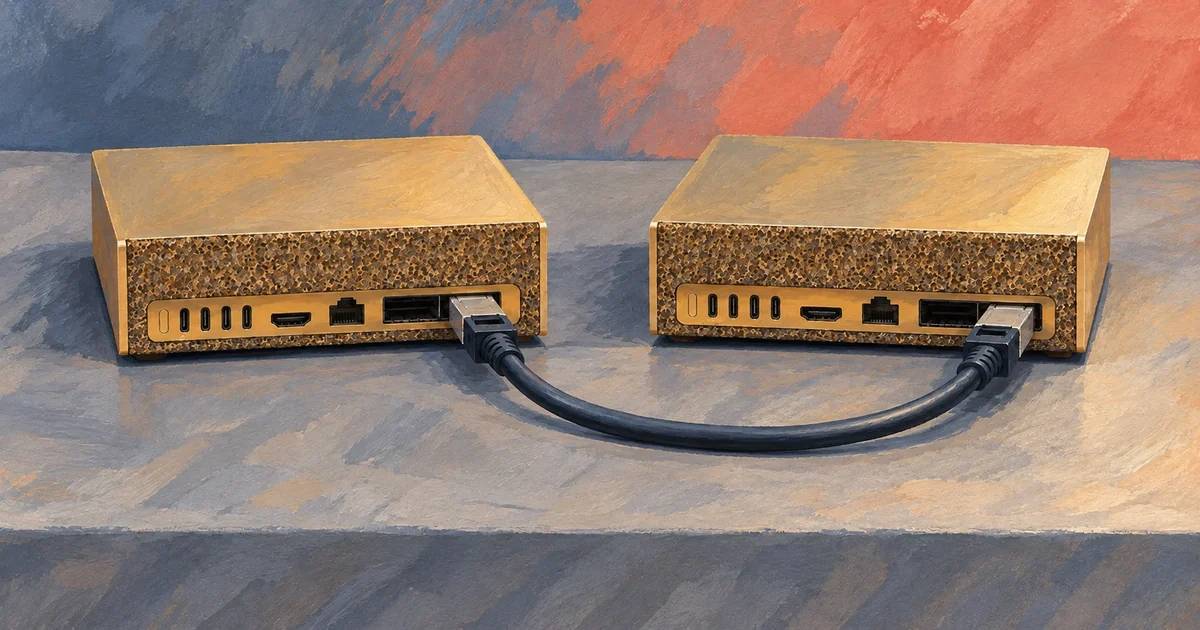
Koppla samman två DGX Spark-enheter: QSFP, SSH, RoCE och Cluster Assistant
En praktisk guide till att länka två NVIDIA DGX Spark-enheter med QSFP och ConnectX-7: samma användarnamn, lösenordsfri SSH, RoCE för distribuerade arbetsbelastningar, NVIDIA Sync Cluster Assistant och återställning.
Avancerad 8 min läsning
Lokal inferens på DGX Spark: minne, programvarustack och när molnet fortfarande vinner
Så tolkar du NVIDIA:s uppgifter om 128 GB koherent minne och cirka 200 miljarder parametrar på en enda nod, väljer en programvarustack och utformar de tester som avgör om lokal inferens passar.
Avancerad 9 min läsning
DGX Spark: vad det är, vem det är till för och vad som ändrats för lokala agenter
En saklig genomgång av NVIDIA DGX Spark: Grace Blackwell GB10-specifikationer från NVIDIA, koherent enhetligt minne, ConnectX-7-klustring och när en agentdator för skrivbordet är rätt satsning på privat AI.
Avancerad 7 min läsning
Hermes Agent: vad det är, vad det inte är och när du ska använda det
En tydlig översikt över Hermes Agent från Nous Research: beständigt minne, färdigheter, verktyg och meddelandegateways, samt hur du avgör när en chattbot räcker och när en agentkörmiljö är rätt verktyg.
Mellannivå 8 min läsning
Anropa vLLM och andra OpenAI-kompatibla slutpunkter från n8n
Anropa en lokal OpenAI-kompatibel /v1/chat/completions-slutpunkt från n8n-noden HTTP Request, med tydlig autentisering, väl avvägda tidsgränser, kontroll av bas-URL och en privat nätverksgräns.
Mellannivå 10 min läsning
NemoClaw på DGX Spark: plan för driftsättning och säkerhet
Planera och utvärdera OpenClaw, Hermes eller Deep Agents Code i NVIDIA OpenShell på DGX Spark: aktuell introduktion, policylager, dirigerad inferens och det acceptansunderlag som krävs.
Avancerad 9 min läsning
Konfigurera en personlig OpenClaw-gateway: installation, introduktion och kontrollpanel
Vad OpenClaw är, hur du installerar och konfigurerar flerkanalsgatewayen i egen drift, öppnar Control UI på port 18789 och vilka Node-versioner som stöds utan att hoppa över säkerhetsbaslinjen.
Mellannivå 10 min läsning
Experimentell stack med två DGX Spark-enheter, DeepSeek-V4-Flash, n8n och Hermes
Så utvärderar du en experimentell väg från användargemenskapen för DeepSeek-V4-Flash på två DGX Spark-enheter, med n8n för den deterministiska delen och Hermes för bedömningsuppgifter.
Avancerad 37 minuter
Uppdatering om funktionerna i VMware Private AI Foundation från Broadcom
Tech Field Day. Visar privat AI som en infrastruktur i flera lager: kontrollerad beräkningskapacitet, isolerade miljöer, Kubernetes, inferenscontainrar, modellstyrning, självbetjäningsbaserad provisionering, delning av GPU-resurser och övervakning. Det motsvarar direkt artikelns varning om att integritet beror på gränserna för driftsättningen, loggar, åtkomst och drift – inte på ordet ”lokal”.
Avancerad 13 min läsning
Finjustering 2026: ett evidensbaserat experiment med LoRA och QLoRA
Avgör om parametereffektiv finjustering är motiverad, styr datahanteringen, lås ett reproducerbart experiment, jämför resultat på undanhållna data och säkerhetstester samt mät serveringen före driftsättning.
Avancerad 157 minuter
Finjustering av LLM-modeller – kurs i generativ AI
freeCodeCamp.org. Kursen behandlar kvantisering, LoRA, QLoRA och PEFT med Llama 2 och Gemma. Kursen visar VRAM-exempel för specifika konfigurationer. Artikeln kräver mätningar för vald modell och hårdvara; exemplen visar inte att varje lämplig uppgift kan klaras utan kluster.
Avancerad 59 minuter
Utveckla en LLM: bygga, träna och finjustera
Sebastian Raschka. Raschkas översikt placerar finjustering i modellens träningsprocess. Artikeln motiverar ett LoRA-experiment med en uppmätt brist jämfört med grundlösningen på uppgiften och kräver resurskontroll samt utvärdering av adaptern före publicering.
Avancerad 32 minuter
Snabb LLM-servering med vLLM och PagedAttention
Anyscale. Videon förklarar ett exempel med 60–80% slöseri med GPU-minne, PagedAttention och batchning. Den ger bakgrund till kostnadsmodellen vid likvärdig kvalitet; mät kapacitet och utnyttjande för din egen belastning.
Avancerad