

IA privada, local y alojada en infraestructura propia
Modelos locales, patrones de despliegue privado, inferencia alojada en infraestructura propia y arquitecturas híbridas.
15 contenidos (11 artículos · 4 vídeos)
Comienza aquí
Una selección inicial antes de explorar todo el contenido.
 10 min de lectura
Patrones de despliegue de IA privada: local, VPC, en infraestructura propia e híbrido
La IA privada no es una única arquitectura. Una comparación práctica de modelos locales, SaaS empresarial, despliegues en VPC, inferencia alojada en infraestructura propia y patrones híbridos para pymes que priorizan la privacidad y el control.
Avanzado 11 min de lectura
Inferencia en infraestructura propia frente a gestionada: un modelo de punto de equilibrio auditable
¿A partir de qué escala sale más rentable operar infraestructura propia que usar API? El cálculo real, las condiciones operativas y los patrones que distinguen a los equipos que deberían gestionar sus modelos de los que deberían seguir pagando por inferencia gestionada.
AvanzadoMás sobre este tema
 8 min de lectura
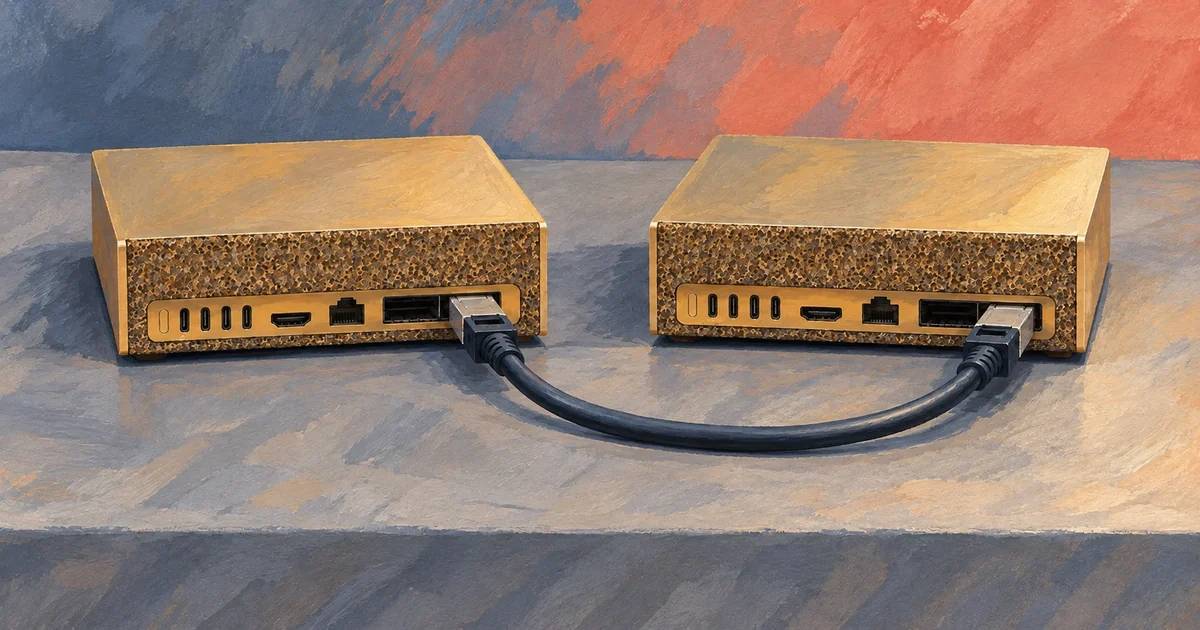
Conectar dos DGX Spark: QSFP, SSH, RoCE y Cluster Assistant
Una guía práctica para enlazar dos unidades NVIDIA DGX Spark con QSFP y ConnectX-7: mismo nombre de usuario, SSH sin contraseña, RoCE para cargas distribuidas, NVIDIA Sync Cluster Assistant y rollback.
Avanzado 8 min de lectura
Realidad de la inferencia local en DGX Spark: memoria, stack y cuándo la nube sigue ganando
Cómo interpretar las afirmaciones de NVIDIA sobre la memoria coherente de 128 GB y los ~200B en un solo nodo, cómo preseleccionar stacks de serving y cómo diseñar las pruebas de hardware que deciden si la inferencia local encaja.
Avanzado 9 min de lectura
DGX Spark: qué es, para quién es y qué cambió para los agentes locales
Una lectura fundamentada de NVIDIA DGX Spark: especificaciones Grace Blackwell GB10 de NVIDIA, memoria unificada coherente, clustering ConnectX-7 y cuándo un ordenador de agentes en el escritorio es la apuesta correcta de IA privada.
Avanzado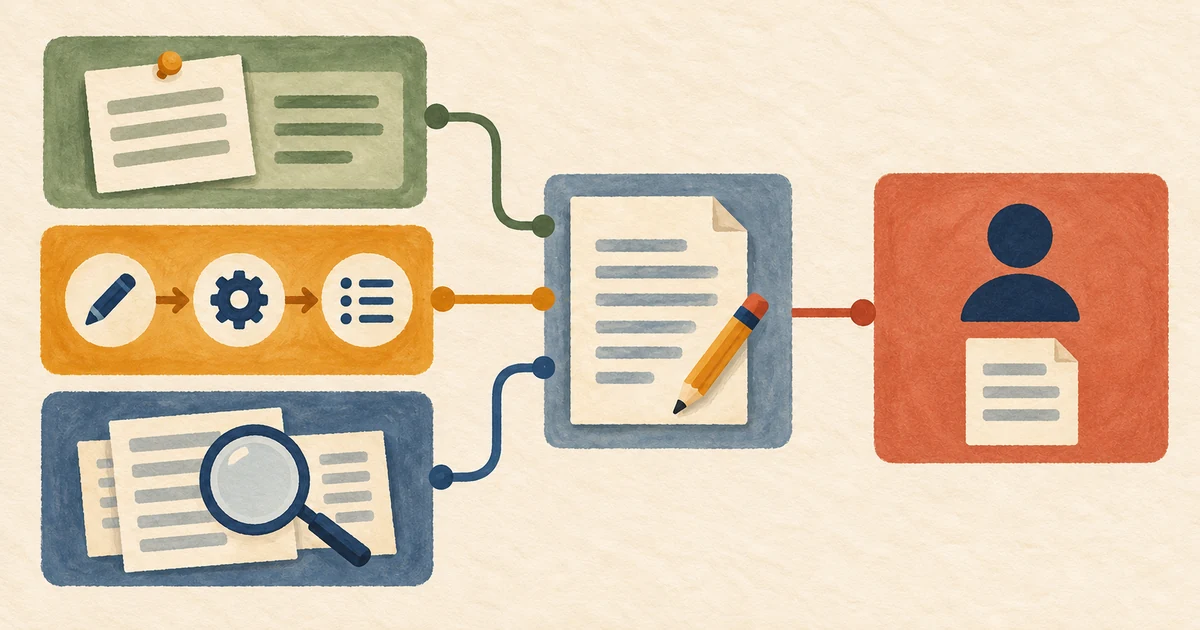 7 min de lectura
Hermes Agent: qué es, qué no es y cuándo usarlo
Una guía clara de Hermes Agent de Nous Research: memoria persistente, skills, herramientas y pasarelas de mensajería, además de criterios para decidir cuándo basta un chatbot y cuándo conviene un entorno de ejecución de agentes.
Intermedio 8 min de lectura
Llama a vLLM y otros endpoints compatibles con OpenAI desde n8n
Llama a un endpoint local /v1/chat/completions compatible con OpenAI desde el nodo HTTP Request de n8n, con autenticación explícita, presupuestos de tiempo de espera, comprobaciones de la URL base y un límite de red privada.
Intermedio 10 min de lectura
NemoClaw en DGX Spark: plan de despliegue y seguridad
Planifica y evalúa OpenClaw, Hermes o Deep Agents Code dentro de NVIDIA OpenShell en DGX Spark: puesta en marcha actual, capas de políticas, inferencia enrutada y evidencia de aceptación necesaria.
Avanzado 9 min de lectura
Configuración del gateway personal de OpenClaw: instalación, onboarding y panel de control
Qué es OpenClaw, cómo instalar y configurar la pasarela multicanal autoalojada, abrir la UI de control en el puerto 18789 y qué versiones de Node son compatibles sin omitir las bases de seguridad.
Intermedio 10 min de lectura
Pila experimental con dos DGX Spark, DeepSeek-V4-Flash, n8n y Hermes
Cómo evaluar una ruta experimental de la comunidad con dos DGX Spark para DeepSeek-V4-Flash, con n8n en el borde determinista y Hermes en la ruta de juicio.
Avanzado 37 minutos
Actualización de capacidades y características de la infraestructura de IA privada de VMware de Broadcom
Tech Field Day. Presenta la IA privada como infraestructura por capas: cómputo controlado, entornos aislados, Kubernetes, contenedores de inferencia, gobernanza de modelos, aprovisionamiento de autoservicio, uso compartido de GPU y monitorización. Se corresponde directamente con la advertencia del artículo: la privacidad depende de los límites del despliegue, los registros, el acceso y las operaciones, no de la palabra «local».
Avanzado 13 min de lectura
Ajuste fino en 2026: un experimento de LoRA y QLoRA basado en evidencia
Decide si el ajuste eficiente en parámetros está justificado, gobierna los datos, fija un experimento reproducible, compara resultados en conjuntos retenidos y pruebas de seguridad, y realiza benchmarks del servicio antes del despliegue.
Avanzado 157 minutos
Fine-tuning de modelos LLM: curso de IA generativa
freeCodeCamp.org. El curso presenta cuantización, LoRA, QLoRA y PEFT con Llama 2 y Gemma. El curso ofrece ejemplos de consumo de VRAM para configuraciones concretas. El artículo exige mediciones del modelo y hardware elegidos; los ejemplos no prueban que cualquier tarea adecuada pueda ejecutarse sin un clúster.
Avanzado 59 minutos
Desarrollo de un LLM: creación, entrenamiento y fine-tuning
Sebastian Raschka. El panorama de Raschka sitúa el ajuste fino en el proceso de entrenamiento. El artículo plantea un experimento de LoRA cuando lo justifica una carencia medida respecto a la solución de referencia, con comprobación de recursos y evaluación del adaptador antes de publicarlo.
Avanzado 32 minutos
Serving rápido de LLM con vLLM y PagedAttention
Anyscale. El vídeo explica un ejemplo de desperdicio del 60–80% de memoria GPU, PagedAttention y procesamiento por lotes. Aporta contexto al modelo de costes con calidad equivalente; mide la capacidad y utilización para tu propia carga.
Avanzado