

Private, Local & Self-hosted AI
Local models, private deployment patterns, self-hosted inference, and hybrid architectures.
18 historier (12 artikler · 6 videoer)
Start her
Et par gode steder at begynde, før du går på opdagelse i hele oversigten.
 10 min læsning
Lokal AI på din Mac: Ollama, LM Studio, og hvad 7B-modeller reelt kan
Lokal AI er blevet moden. Med Ollama eller LM Studio og en moderne Mac kan du køre kompetente modeller offline, gratis og privat. Her er, hvad der virker, hvad der ikke gør, og hvilke anvendelser der reelt har gavn af det.
Let øvet 10 min læsning
Udrulningsmønstre for privat AI: lokalt, i VPC, selvhostet eller hybrid
Privat AI er ikke én enkelt arkitektur. En praktisk sammenligning af lokale modeller, SaaS til virksomheder, VPC-udrulninger, selvhostet inferens og hybride mønstre for SMV'er, der prioriterer databeskyttelse og kontrol.
Avanceret 11 min læsning
Selvhostet eller administreret inferens: en efterprøvbar nulpunktsmodel
Hvornår slår selvhosting API-kald? Beregningerne, de praktiske driftsforhold og de mønstre, der adskiller teams, der bør selvhoste, fra dem, der bør fortsætte med at betale for administreret inferens.
AvanceretFlere i dette emne
 8 min læsning
Forbind to DGX Sparks: QSFP, SSH, RoCE og Cluster Assistant
En praktisk vejledning i at forbinde to NVIDIA DGX Spark-enheder med QSFP og ConnectX-7: samme brugernavn, SSH uden adgangskode, RoCE til distribuerede arbejdsbelastninger, NVIDIA Sync Cluster Assistant og tilbagerulning.
Avanceret 8 min læsning
Lokal inferens på DGX Spark i praksis: hukommelse, softwarestak og hvornår cloud stadig er bedst
Sådan fortolker du NVIDIAs udsagn om 128 GB kohærent hukommelse og cirka 200 milliarder parametre på én node, udvælger serveringsstakke og designer de hardwaretests, der afgør, om lokal inferens passer til opgaven.
Avanceret 9 min læsning
DGX Spark: hvad det er, hvem det er til, og hvad der ændrede sig for lokale agenter
En nøgtern gennemgang af NVIDIA DGX Spark: NVIDIAs specifikationer for Grace Blackwell GB10, kohærent samlet hukommelse, klyngedannelse med ConnectX-7, og hvornår en lokal agentcomputer er et fornuftigt valg til privat AI.
Avanceret 7 min læsning
Hermes Agent: hvad det er, hvad det ikke er, og hvornår du skal bruge det
Et klart overblik over Hermes Agent fra Nous Research: vedvarende hukommelse, færdigheder, værktøjer og beskedgateways samt valget mellem en chatbot og et agentkørselsmiljø.
Let øvet 8 min læsning
Kald vLLM og andre OpenAI-kompatible slutpunkter fra n8n
Kald et lokalt OpenAI-kompatibelt /v1/chat/completions-slutpunkt fra n8ns HTTP Request-node med eksplicit autentificering, målte tidsgrænser, kontrol af base-URL og en privat netværksgrænse.
Let øvet 10 min læsning
NemoClaw på DGX Spark: plan for implementering og sikkerhed
Planlæg og evaluér OpenClaw, Hermes eller Deep Agents Code i NVIDIA OpenShell på DGX Spark: aktuel opsætning, politiklag, styret inferens og den nødvendige dokumentation for godkendelse.
Avanceret 9 min læsning
Opsætning af personlig OpenClaw-gateway: installation, klargøring og kontrolpanel
Hvad OpenClaw er, hvordan du installerer og klargør flerkanalsgatewayen i egen drift, åbner Control UI på port 18789, og hvilke Node-versioner der understøttes, uden at springe sikkerhedsgrundlaget over.
Let øvet 10 min læsning
Eksperimentel stak med to DGX Spark-enheder, DeepSeek-V4-Flash, n8n og Hermes
Sådan evaluerer du en eksperimentel fællesskabsudviklet løsning med to DGX Spark-systemer til DeepSeek-V4-Flash, hvor n8n håndterer den deterministiske del og Hermes vurderingsopgaverne.
Avanceret 37 minutter
Opdatering om funktioner i VMware Private AI Foundation fra Broadcom
Tech Field Day. Videoen viser privat AI som lagdelt infrastruktur med kontrollerede beregningsressourcer, isolerede miljøer, Kubernetes, inferenscontainere, styring af modeller, selvbetjent klargøring, deling af GPU'er og overvågning. Det understøtter artiklens pointe om, at databeskyttelsen afhænger af udrulningsgrænser, logning, adgangskontrol og drift, ikke blot af betegnelsen "lokal".
Avanceret 13 min læsning
Finjustering i 2026: et LoRA- og QLoRA-eksperiment med dokumentationen i centrum
Afgør, om parametereffektiv finjustering er berettiget, styr dataene, fastlås et reproducerbart eksperiment, sammenlign resultater på et adskilt testsæt og i sikkerhedstests, og mål modeldriften før idriftsættelse.
Avanceret 157 minutter
Fine-tuning af LLM-modeller – kursus i generativ AI
freeCodeCamp.org. Det lange kursus går fra teori til kode og dækker kvantisering, LoRA, QLoRA og PEFT med Llama 2 og Gemma. Det viser et konkret hardwaremiljø og konkrete VRAM-budgetter, som gør artiklens diskussion af eksperimenter uden en klynge mere håndgribelig. Resultaterne gælder det viste miljø og er ikke et generelt løfte om, hvad almindelig udviklerhardware kan klare.
Avanceret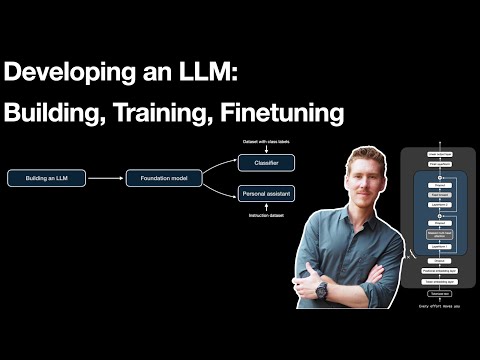 59 minutter
Udvikling af en LLM: opbygning, træning og finjustering
Sebastian Raschka. Sebastian Raschka gennemgår finjusteringens placering i den bredere proces for træning af LLM'er, herunder instruktionsfinjustering, klassifikationsfinjustering, parametereffektive metoder og de afvejninger, artiklen beskriver før en eventuel anbefaling af LoRA. Videoen er nyttig som fagligt overblik, når et team skal vurdere, om finjustering overhovedet er det rigtige næste skridt.
Avanceret 14 minutter
Lær Ollama på 15 minutter — kør LLM-modeller lokalt GRATIS
Tech With Tim. En stram, no-nonsense Ollama-gennemgang — installer, pull en model, chat, poke derefter på den lokale HTTP-API fra Python, og opret en custom model med en Modelfile. Dækker præcis den arbejdsgang, artiklen beskriver til daglig brug på en Mac, inklusive hvordan du tænker om modelstørrelse kontra din maskines RAM.
Let øvet 6 minutter
LM Studio-tutorial: Kør store sprogmodeller (LLM) på din laptop
Kevin Stratvert. Samme arbejdsgang som Ollama, men i en GUI: download LM Studio, pull en Llama- eller Gemma-model, chat, drop en PDF ind, og stil spørgsmål om den. God til læsere, der helst ikke vil leve i terminalen — også nyttig til at få en fornemmelse af, hvordan en 1B–3B-model faktisk performerer op imod en tungere.
Let øvet 32 minutter
Hurtig LLM-inferens med vLLM og PagedAttention
Anyscale. Præsentationen rapporterer, at en enkel LLM-server i det viste miljø spilder 60–80 % af GPU-hukommelsen, forklarer hvordan PagedAttention bruger en sideinddeling inspireret af operativsystemer, og viser de 24×-tal for gennemløb, som artiklen omtaler. Tallene stammer fra den beskrevne opsætning og udgør ikke et generelt sammenligningsgrundlag. De giver kontekst til artiklens forsigtige antagelse om 50 % udnyttelse.
Avanceret