

IA privée, locale et auto-hébergée
Modèles locaux, modes de déploiement privé, inférence auto-hébergée et architectures hybrides.
15 contenus (11 articles · 4 vidéos)
Commencez ici
Quelques bons contenus pour débuter avant de parcourir l’ensemble du flux.
 10 min de lecture
Modes de déploiement de l’IA privée : local, VPC, auto-hébergé et hybride
L’IA privée ne se résume pas à une seule architecture. Cette comparaison concrète couvre les modèles locaux, le SaaS d’entreprise, les déploiements dans un VPC, l’inférence auto-hébergée et les architectures hybrides pour les PME soucieuses de la confidentialité et du contrôle.
Avancé 11 min de lecture
Inférence auto-hébergée ou gérée : un seuil de rentabilité vérifiable
À partir de quel volume l’auto-hébergement devient-il plus avantageux que les appels d’API ? Les calculs, les réalités opérationnelles et les critères qui distinguent les équipes qui devraient auto-héberger de celles qui devraient conserver une offre d’inférence gérée.
AvancéPlus de contenus sur ce thème
 8 min de lecture
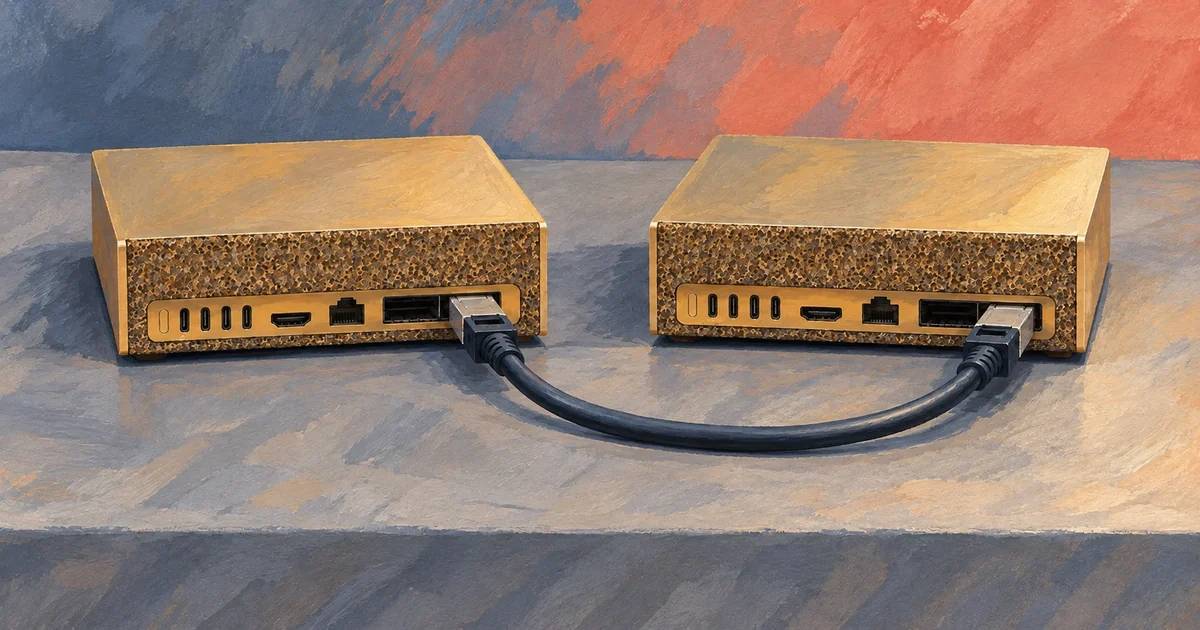
Relier deux DGX Sparks : QSFP, SSH, RoCE et Cluster Assistant
Guide pratique pour relier deux unités NVIDIA DGX Spark avec QSFP et ConnectX-7 : même nom d'utilisateur, SSH sans mot de passe, RoCE pour charges distribuées, NVIDIA Sync Cluster Assistant, et rollback.
Avancé 8 min de lecture
Inférence locale sur DGX Spark : mémoire, pile logicielle et cas où le cloud reste préférable
Comment interpréter les annonces de NVIDIA concernant les 128 Go de mémoire cohérente et les modèles d’environ 200B sur un seul nœud, sélectionner une pile de service et concevoir les essais matériels qui déterminent si l’inférence locale convient.
Avancé 9 min de lecture
DGX Spark : ce que c’est, à qui il s’adresse et ce qu’il change pour les agents exécutés localement
Une analyse factuelle du NVIDIA DGX Spark : caractéristiques du Grace Blackwell GB10 publiées par NVIDIA, mémoire unifiée cohérente, interconnexion de plusieurs systèmes par ConnectX-7 et situations où une machine de bureau dédiée aux agents constitue un choix pertinent pour l’IA privée.
Avancé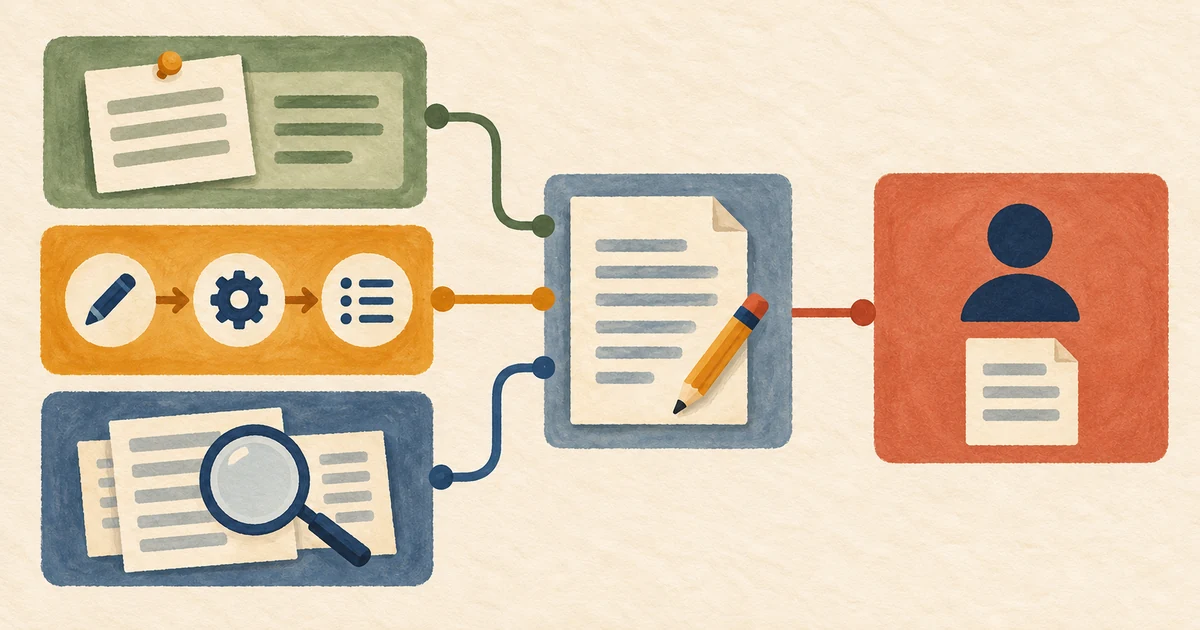 7 min de lecture
Hermes Agent : ce que c’est, ce que ce n’est pas et quand l’utiliser
Une présentation claire de Hermes Agent de Nous Research : mémoire persistante, skills, outils et passerelles de messagerie, avec les critères pour décider quand un chatbot suffit et quand un environnement d’exécution d’agents est plus adapté.
Intermédiaire 8 min de lecture
Appeler vLLM et d’autres points de terminaison compatibles avec OpenAI depuis n8n
Appelez un point de terminaison local /v1/chat/completions compatible avec OpenAI depuis le nœud HTTP Request de n8n, avec une authentification explicite, des budgets de délai d’attente, des contrôles de l’URL de base et une limite réseau privée.
Intermédiaire 10 min de lecture
NemoClaw sur DGX Spark : plan de déploiement et de sécurité
Planifier et évaluer OpenClaw, Hermes ou Deep Agents Code dans NVIDIA OpenShell sur DGX Spark : procédure d’installation actuelle, couches de règles, inférence routée et preuves de réception indispensables.
Avancé 9 min de lecture
Configurer une passerelle OpenClaw personnelle : installation, configuration initiale et tableau de bord
Comprendre OpenClaw, installer et configurer sa passerelle multicanal auto-hébergée, ouvrir le Control UI sur le port 18789 et utiliser une version de Node prise en charge sans négliger les bases de la sécurité.
Intermédiaire 10 min de lecture
Architecture expérimentale : deux DGX Spark, DeepSeek-V4-Flash, n8n et Hermes
Comment évaluer une solution communautaire expérimentale qui exécute DeepSeek-V4-Flash sur deux DGX Spark, avec n8n pour les opérations déterministes et Hermes pour les tâches qui exigent du jugement.
Avancé 37 minutes
Mises à jour des fonctionnalités et capacités de la fondation VMware Private AI par Broadcom
Tech Field Day. Elle présente l'IA privée comme une infrastructure en couches : ressources de calcul contrôlées, environnements isolés, Kubernetes, conteneurs d'inférence, gouvernance des modèles, mise à disposition en libre-service, partage des GPU et supervision. Cette architecture illustre directement l'avertissement de l'article : la confidentialité dépend des frontières de déploiement, des journaux, des droits d'accès et de l'exploitation, pas de la simple étiquette « local ».
Avancé 13 min de lecture
Ajustement fin en 2026 : une expérience fondée sur les preuves autour de LoRA et QLoRA
Décidez si l’ajustement fin efficace en paramètres est justifié, gouvernez les données, figez une expérience reproductible, comparez les résultats sur les données de test et ceux liés à la sécurité, puis effectuez un benchmark du déploiement avant la mise en production.
Avancé 157 minutes
Ajustement fin des modèles LLM – Cours sur l'IA générative
freeCodeCamp.org. Le cours présente la quantification, LoRA, QLoRA et PEFT avec Llama 2 et Gemma. Le cours donne des exemples de consommation de VRAM propres à certaines configurations. L’article exige des mesures pour le modèle et le matériel choisis ; ces exemples ne prouvent pas que toute tâche adaptée peut se passer de cluster.
Avancé 59 minutes
Développer un LLM : Construction, entraînement, ajustement fin
Sebastian Raschka. Le panorama de Raschka situe l’ajustement fin dans le processus d’entraînement. L’article envisage une expérience LoRA si un écart mesuré par rapport à la référence le justifie, avec des contrôles de ressources et une évaluation de l’adaptateur avant publication.
Avancé 32 minutes
Servir rapidement des LLM avec vLLM et PagedAttention
Anyscale. La vidéo explique un exemple de gaspillage de 60–80% de la mémoire GPU, PagedAttention et le traitement par lots. Elle complète le modèle de coûts à qualité équivalente de l’article ; mesurez la capacité et l’utilisation pour votre propre charge.
Avancé