

 7 minutes
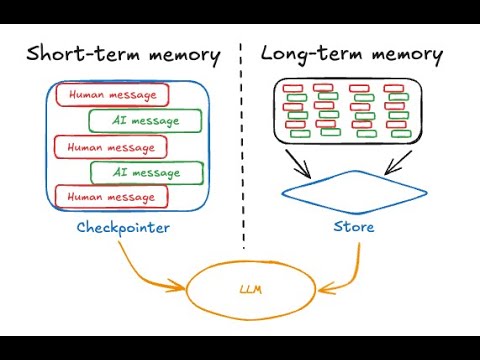
Mémoire pour agents (vidéo conceptuelle)
Séparer les décisions concernant la mémoire à court terme et à long terme, et décider quand la mémoire de l'agent doit être écrite.
AvancéAutomatisations
 Lire la vidéo
Sebastian Raschka. Le panorama de Raschka situe l’ajustement fin dans le processus d’entraînement. L’article envisage une expérience LoRA si un écart mesuré par rapport à la référence le justifie, avec des contrôles de ressources et une évaluation de l’adaptateur avant publication.
Les noms, les tarifs et les capacités des modèles évoluent rapidement. Utilisez cette vidéo pour son schéma de décision, puis vérifiez le comportement actuel des modèles avant de les adopter.
Situer le fine-tuning dans le pipeline global d’entraînement et déterminer quand il convient mieux que le prompting ou le RAG.
Une culture générale de l’apprentissage automatique ; il s’agit d’une présentation conceptuelle, sans environnement de code à préparer.
Dernière révision : 18 mai 2026
Continuez dans le même parcours d’apprentissage avec les prochaines vidéos d’accompagnement sélectionnées.
7 minutesSéparer les décisions concernant la mémoire à court terme et à long terme, et décider quand la mémoire de l'agent doit être écrite.
 13 minutes
Modéliser l'injection de prompt comme un mélange de données non fiables et définir des limites de conception autour de l'utilisation des outils.
 19 minutes
Vous pouvez estimer quand la mise en cache des prompts est rentable en pesant les surcoûts de mise en cache en écriture par rapport aux économies en lecture pour vos charges de travail réelles.