

 7 minutes
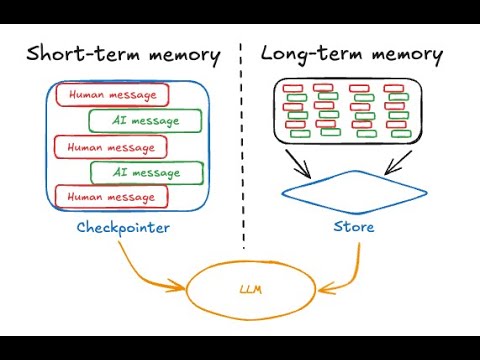
Mémoire pour agents (vidéo conceptuelle)
Séparer les décisions concernant la mémoire à court terme et à long terme, et décider quand la mémoire de l'agent doit être écrite.
AvancéAutomations
Chroma. Kelly Hong présente les recherches de Chroma sur 18 modèles : pourquoi les scores aux tests de « l'aiguille dans une botte de foin » sont trompeurs, comment les performances diminuent face à l'ambiguïté et aux éléments parasites, et pourquoi même de simples tâches de répétition de chaînes se dégradent au-delà de 500 tokens. Courte et étayée par des données, cette vidéo montre précisément le risque qu'il faut prendre au sérieux avant d'aborder les solutions techniques de l'article.
Les modèles, leurs tarifs et leurs capacités évoluent rapidement. Retenez ici la méthode de décision, puis vérifiez le comportement des modèles actuels avant de l'adopter.
Comprendre comment le contexte long peut échouer en présence d'ambiguïté et d'éléments perturbateurs, puis concevoir des tests autour de ce risque.
Seul le vocabulaire de base des grands modèles de langage est nécessaire ; il s'agit d'une brève présentation de recherche.
Dernière révision : 18 mai 2026
Continuez dans le même parcours d’apprentissage avec les prochaines vidéos d’accompagnement sélectionnées.
7 minutesSéparer les décisions concernant la mémoire à court terme et à long terme, et décider quand la mémoire de l'agent doit être écrite.
 5 minutes
Comprendre pourquoi le pilotage d'un ordinateur par captures d'écran est puissant, mais aussi lent, coûteux et fragile par rapport à une automatisation fondée directement sur des API.
 13 minutes
Modéliser l'injection de prompt comme un mélange de données non fiables et définir des limites de conception autour de l'utilisation des outils.
Des cours externes sélectionnés pour approfondir ce sujet.
 DeepLearning.AI
Isa Fulford · Andrew Ng
Quinze minutes de cours peuvent remplacer une année d'intuition. Si vous avez commencé à écrire du code qui appelle un grand modèle de langage (LLM), ou prévoyez de le faire, c'est le cours en ligne le plus efficace pour passer de « jouer avec ChatGPT » à « déployer une fonctionnalité qui appelle un LLM ».
 Microsoft Learn
Prompt engineering, but for the tool most office workers will actually touch first. Microsoft's own four-part prompting framework (goal, context, source, expectation) is a genuinely useful mental model, and unlike the generic ChatGPT prompting courses already in our catalog, this one is grounded entirely in Microsoft 365 Copilot's specific quirks and grounding behavior.