Vidéos complémentaires

Fine-tuning en 2026 : quand LoRA surpasse le RAG et comment le faire sans cluster — vidéos complémentaires

L’article explique que la plupart des projets de fine-tuning résolvent encore le mauvais problème, mais que LoRA appliqué à une tâche ciblée appropriée constitue l’un des leviers les plus puissants dont dispose un ingénieur en 2026 — et qu’un cluster n’est plus nécessaire. Associez-lui un long tutoriel pratique et la présentation conceptuelle plus progressive d’un pédagogue reconnu en apprentissage automatique : vous pourrez décider à la fois s’il faut procéder à un fine-tuning et comment le réaliser.

Choix principal

2:37:05
Ajustement fin des modèles LLM – Cours sur l'IA générative

freeCodeCamp.org

Ce long cours passe de la théorie au code et couvre la quantification, LoRA, QLoRA et l’ensemble des techniques PEFT sur Llama 2 et Gemma, avec du matériel dont disposent réellement la plupart des développeurs. C’est sur YouTube ce qui se rapproche le plus de l’expérience consistant à suivre pas à pas une personne qui l’a déjà fait. Il étaye concrètement l’affirmation de l’article selon laquelle « vous n’avez pas besoin d’un cluster », avec des budgets de VRAM précis.

Ce que vous en retirerez: Réaliser de bout en bout une quantification et des fine-tunings LoRA et QLoRA sur du matériel dont disposent déjà la plupart des développeurs.

À voir ou à connaître au préalable: Connaître Python et être à l’aise avec les outils élémentaires d’apprentissage automatique ; le cours vise le matériel que la plupart des développeurs possèdent déjà.

Note d’AI Expert: Les noms, les tarifs et les capacités des modèles évoluent rapidement. Les modèles de base du cours — Llama 2 et Gemma — ont vieilli, mais les techniques LoRA, QLoRA et de quantification enseignées se transfèrent directement aux modèles actuels à poids ouverts. Utilisez le cours pour son schéma de décision, puis vérifiez le comportement des modèles actuels avant de les adopter.
Ouvrir la page vidéo

À voir également

58:45
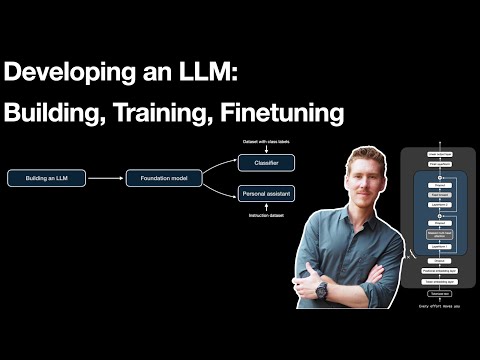
Développer un LLM : Construction, entraînement, ajustement fin

Sebastian Raschka

Sebastian Raschka présente progressivement la place du fine-tuning dans le pipeline global d’entraînement des LLM — ajustement par instructions, fine-tuning de classification, méthodes économes en paramètres et compromis relevés dans l’article avant de recommander LoRA. C’est un bon étalonnage avant de commencer, surtout si votre équipe se demande encore si le fine-tuning constitue la bonne étape.

Ce que vous en retirerez: Situer le fine-tuning dans le pipeline global d’entraînement et déterminer quand il convient mieux que le prompting ou le RAG.

À voir ou à connaître au préalable: Une culture générale de l’apprentissage automatique ; il s’agit d’une présentation conceptuelle, sans environnement de code à préparer.

Note d’AI Expert: Les noms, les tarifs et les capacités des modèles évoluent rapidement. Utilisez cette vidéo pour son schéma de décision, puis vérifiez le comportement actuel des modèles avant de les adopter.

Ouvrir la page vidéo