

 7 minutes
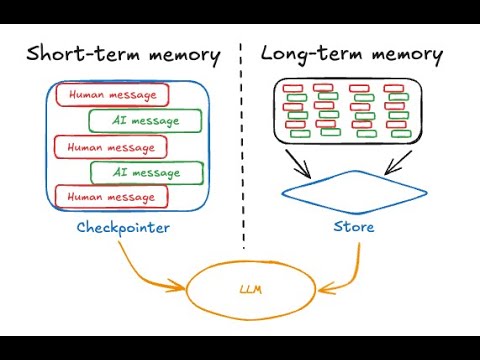
Mémoire pour agents (vidéo conceptuelle)
Séparer les décisions concernant la mémoire à court terme et à long terme, et décider quand la mémoire de l'agent doit être écrite.
AvancéAutomatisations
 Lire la vidéo
freeCodeCamp.org. Le cours présente la quantification, LoRA, QLoRA et PEFT avec Llama 2 et Gemma. Le cours donne des exemples de consommation de VRAM propres à certaines configurations. L’article exige des mesures pour le modèle et le matériel choisis ; ces exemples ne prouvent pas que toute tâche adaptée peut se passer de cluster.
Les modèles de base du cours (Llama 2, Gemma) sont des exemples datés. Utilisez les méthodes comme contexte et vérifiez la prise en charge du modèle, les versions des bibliothèques, les ressources et les résultats de votre configuration ; leur transfert direct n’est pas garanti.
Utiliser le cours comme exemple pour préparer une expérimentation LoRA ou QLoRA, puis mesurer les ressources et les résultats de la configuration choisie.
Connaître Python et les outils élémentaires d’apprentissage automatique ; vérifiez les ressources nécessaires au modèle et au matériel choisis avant l’expérience.
Dernière révision : 18 mai 2026
Continuez dans le même parcours d’apprentissage avec les prochaines vidéos d’accompagnement sélectionnées.
7 minutesSéparer les décisions concernant la mémoire à court terme et à long terme, et décider quand la mémoire de l'agent doit être écrite.
 13 minutes
Modéliser l'injection de prompt comme un mélange de données non fiables et définir des limites de conception autour de l'utilisation des outils.
 19 minutes
Vous pouvez estimer quand la mise en cache des prompts est rentable en pesant les surcoûts de mise en cache en écriture par rapport aux économies en lecture pour vos charges de travail réelles.