

プライベートAI、ローカルAI、自社運用AI
ローカルモデル、プライベート環境への導入パターン、自社運用の推論、ハイブリッドアーキテクチャ。
18件のコンテンツ (記事12件 · 動画6件)
ここから開始
一覧を見る前に、まずおすすめのコンテンツをいくつかご覧ください。
 10 分の読書
Macで動かすローカルAI:Ollama、LM Studio、そして7Bモデルで本当にできること
ローカルでのAI実行は成熟しました。OllamaまたはLM Studioと最新のMacがあれば、高性能なモデルをオフラインで、無料かつプライベートに実行できます。何ができ、何ができないのか、そして実際に恩恵を受けるユースケースを解説します。
中級者 10 分の読書
プライベートAIの導入パターン:ローカル、VPC、自社運用、ハイブリッド
プライベートAIは一つのアーキテクチャではありません。プライバシーと制御を重視する中小企業向けに、ローカルモデル、法人向けSaaS、VPCへの導入、自社運用の推論、ハイブリッド構成を実践的に比較します。
上級者 11 分の読書
自社運用とマネージド推論:監査可能な損益分岐点モデル
どの程度の規模になれば、自社運用がAPI利用より有利になるのでしょうか。実際のコスト計算と運用上の現実を踏まえ、自社運用に向くチームとマネージド推論を使い続けるべきチームの違いを解説します。
上級者このトピックの他の記事
 8 分の読書
2台のDGX Sparkを接続する:QSFP、SSH、RoCE、Cluster Assistant
QSFPとConnectX-7で2台のNVIDIA DGX Sparkを接続する実践ガイドです。同一ユーザー名、パスワードレスSSH、分散ワークロード向けのRoCE、NVIDIA Sync Cluster Assistant、ロールバックを扱います。
上級者 8 分の読書
DGX Sparkのローカル推論の実情:メモリー、サービングスタック、クラウドが依然として優位な場面
NVIDIAによる128 GBコヒーレントメモリーと単一ノードで約200Bパラメーターという主張を解釈し、サービングスタックの候補を絞り、ローカル推論が適するか判断するハードウェアテストを設計します。
上級者 9 分の読書
DGX Sparkとは何か:誰に向き、ローカルエージェントをどう変えたのか
NVIDIA DGX Sparkを根拠に即して読み解きます。NVIDIA公表のGrace Blackwell GB10仕様、コヒーレント統合メモリー、ConnectX-7によるクラスタリング、そしてデスクサイドのエージェント用コンピューターがプライベートAIに適する条件を検討します。
上級者 7 分の読書
Hermes Agentとは何か、何ではないか、いつ使うべきか
Nous ResearchによるHermes Agentの見取り図です。永続メモリ、スキル、ツール、メッセージングゲートウェイに加え、チャットボットで足りる場面と、エージェントランタイムが適する場面の判断を扱います。
中級者 8 分の読書
n8nからvLLMなどのOpenAI互換エンドポイントを呼び出す
n8nのHTTP RequestノードからローカルのOpenAI互換/v1/chat/completionsエンドポイントを呼び出します。認証、タイムアウト予算、ベースURLの確認、非公開ネットワーク境界を明示的に設定します。
中級者 10 分の読書
DGX Spark上のNemoClaw:導入・セキュリティ計画
DGX Spark上のNVIDIA OpenShell内でOpenClaw、Hermes、またはDeep Agents Codeを評価するための計画です。現行のオンボーディング、ポリシー層、推論ルーティング、必要な受け入れ証拠を扱います。
上級者 9 分の読書
OpenClawパーソナルゲートウェイの設定:インストール、初期設定、ダッシュボード
OpenClawの概要、セルフホスト型マルチチャネルゲートウェイのインストールと初期設定、ポート18789でのControl UIの開き方、セキュリティー基準を省略せずに使えるNodeバージョンを説明します。
中級者 10 分の読書
実験的なデュアルDGX Spark+DeepSeek-V4-Flash+n8n+Hermesスタック
DeepSeek-V4-Flashを2台のDGX Sparkで動かす実験的なコミュニティ経路を評価する方法です。決定論的な処理をn8nに、判断が必要な処理をHermesに担当させます。
上級者 37 分
Broadcomが解説するVMware Private AI Foundationの機能更新
Tech Field Day. プライベートAIを、統制されたコンピューティング、分離環境、Kubernetes、推論コンテナ、モデルガバナンス、セルフサービス型プロビジョニング、GPU共有、監視から成る多層インフラとして示します。これは、プライバシーは「ローカル」という言葉ではなく、導入境界、ログ、アクセス、運用によって決まるという記事の警告に直接対応します。
上級者 13 分の読書
2026年のファインチューニング:根拠を先に置くLoRA・QLoRA実験
パラメーター効率の高いチューニングが妥当かを判断し、データを統制し、再現可能な実験を固定し、ホールドアウトと安全性の結果を比較し、導入前に推論提供を測定します。
上級者 157 分
LLMのファインチューニング:生成AI講座
freeCodeCamp.org. 量子化、LoRA、QLoRA、包括的なPEFTをLlama 2とGemmaで扱う、理論からコードへ進む長編コースです。しかも、ほとんどの開発者が実際に所有するハードウェアを使用します。YouTube上で「経験者の仕事をそばで見ながら学ぶ」体験に最も近く、具体的なVRAM要件を通じて、記事の「クラスターは不要」という主張を裏付けています。
上級者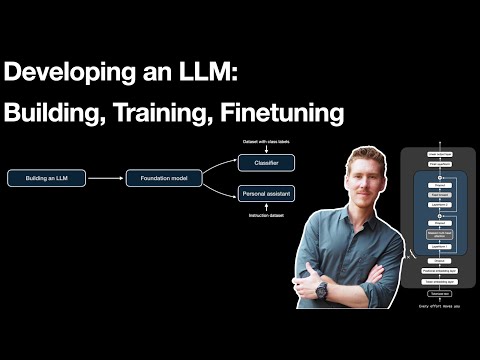 59 分
LLMの開発:構築、学習、ファインチューニング
Sebastian Raschka. Sebastian Raschkaが、LLMの学習パイプライン全体におけるファインチューニングの位置付けをじっくり解説します。インストラクションチューニング、分類タスク向けファインチューニング、パラメーター効率の高い手法、そして記事がLoRAを推奨する前に取り上げるトレードオフを扱います。着手前に判断軸を整えるのに適しており、ファインチューニングが本当に正しい選択なのかをチームで検討している場合には特に有用です。
上級者 14 分
Ollamaを15分で学ぶ:LLMを無料でローカル実行
Tech With Tim. Ollamaの要点を簡潔に解説しています。インストール、モデルの取得、チャットに続き、PythonからローカルHTTP APIを試し、Modelfileでカスタムモデルを作成します。モデルのサイズとMacのRAMの関係も含め、記事で説明する日常的な利用ワークフローを正確に網羅しています。
中級者 6 分
LM Studioチュートリアル:ノートPCでLLMを実行する
Kevin Stratvert. Ollamaと同じワークフローをGUIで行います。LM Studioをダウンロードし、LlamaまたはGemmaモデルを取得してチャットし、PDFを追加して内容について質問します。ターミナルを常用したくない読者に適しており、1B~3Bモデルがより大規模なモデルと比べて実際にどう動作するかを体感するのにも役立ちます。
中級者 32 分
vLLMとPagedAttentionによる高速なLLM推論配信
Anyscale. 単純なLLMサービングがGPUメモリの60~80%を無駄にする理由、PagedAttentionがOSのようなページングを応用してそれを解決する仕組み、継続的バッチ処理によって記事の計算で使う24倍のスループットが実現する理由を解説します。視聴後は、記事にある「稼働率が50%に達すれば幸運」という一節が抽象的な話ではなくなります。
上級者