

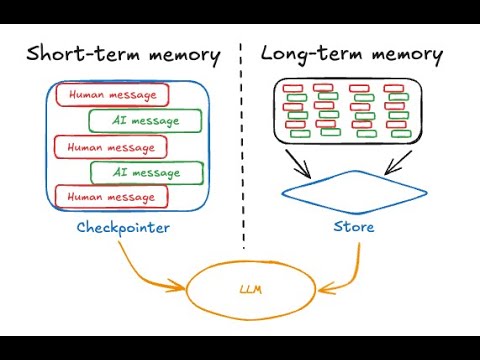
 7 minutos
Memoria para agentes (vídeo conceptual)
Separarás las decisiones sobre memoria a corto y largo plazo y decidirás cuándo debe escribir memoria el agente.
AvanzadoAutomatizaciones
 Reproducir vídeo
Sebastian Raschka. El panorama de Raschka sitúa el ajuste fino en el proceso de entrenamiento. El artículo plantea un experimento de LoRA cuando lo justifica una carencia medida respecto a la solución de referencia, con comprobación de recursos y evaluación del adaptador antes de publicarlo.
Los nombres de modelos, precios y capacidades cambian rápidamente. Usa este curso para el patrón de decisión, luego verifica el comportamiento actual del modelo antes de adoptarlo.
Situarás el fine-tuning dentro del pipeline general de entrenamiento y decidirás cuándo resulta preferible al prompting o a RAG.
Conocimiento general de ML; es un recorrido conceptual, por lo que no se requiere configuración para seguir el código.
Última revisión: 18 may 2026
Continúa por el mismo itinerario de aprendizaje con los siguientes vídeos complementarios seleccionados.
7 minutosSepararás las decisiones sobre memoria a corto y largo plazo y decidirás cuándo debe escribir memoria el agente.
 13 minutos
Modelarás la inyección de prompts como una mezcla de datos no fiables y diseñarás límites para el uso de herramientas.
 19 minutos
Podrás estimar cuándo compensa la caché de prompts comparando el recargo de escritura con el ahorro de lectura para tus cargas reales.