

 7 Minuten
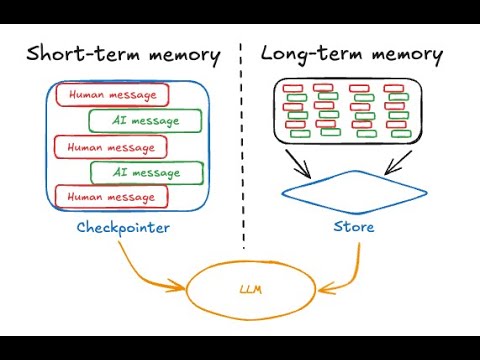
Gedächtnis für Agenten (Konzeptvideo)
Entscheidungen zu Kurzzeit- und Langzeitgedächtnis trennen und festlegen, wann der Agent Informationen speichern soll.
FortgeschrittenAutomatisierungen
 Video abspielen
Sebastian Raschka. Raschkas Überblick ordnet Fine-Tuning in die Modelltrainingspipeline ein. Der Artikel begründet ein LoRA-Experiment anhand einer gemessenen Lücke gegenüber der Ausgangslösung auf der konkreten Aufgabe und verlangt Ressourcenprüfungen sowie die Evaluation des Adapters vor der Veröffentlichung.
Modellnamen, Preise und Fähigkeiten ändern sich schnell. Nutzen Sie das Video für das Entscheidungsmuster und prüfen Sie vor dem Einsatz das aktuelle Modellverhalten.
Fine-Tuning in die umfassendere Trainingspipeline einordnen und entscheiden, wann es Prompting oder RAG überlegen ist.
Allgemeine ML-Kenntnisse; da es sich um einen konzeptionellen Überblick handelt, ist keine Umgebung zum Mitprogrammieren erforderlich.
Zuletzt geprüft: 18. Mai 2026
Fahren Sie mit demselben Lernpfad fort und sehen Sie die nächsten kuratierten Begleitvideos.
7 MinutenEntscheidungen zu Kurzzeit- und Langzeitgedächtnis trennen und festlegen, wann der Agent Informationen speichern soll.
 13 Minuten
Prompt-Injection als Vermischung nicht vertrauenswürdiger Daten modellieren und Sicherheitsgrenzen für die Werkzeugnutzung entwerfen.
 19 Minuten
Abschätzen, wann sich Prompt-Caching für reale Workloads lohnt, indem Schreibaufschläge und Einsparungen beim Lesen gegeneinander abgewogen werden.