17 MinutenConductor-CEO Charlie Holtz stellt sein KI-Coding-Setup vor
Einen Multi-Agenten-Entwicklungsworkflow mit klaren Review-Grenzen einrichten, damit generierte Änderungen klein, getestet und eindeutig verantwortet bleiben.
Tiefe im Produktivbetrieb. Systementwurf, Evaluierungen und die schwierigen architektonischen Entscheidungen.
26 Ergebnisse
Nichts passt zu diesen FilternVersuchen Sie eine andere Kategorie oder ein anderes Niveau oder setzen Sie die Filter zurück, um alle Inhalte anzuzeigen.
17 MinutenEinen Multi-Agenten-Entwicklungsworkflow mit klaren Review-Grenzen einrichten, damit generierte Änderungen klein, getestet und eindeutig verantwortet bleiben.
56 MinutenEinen ROI-Nachweis für einen KI-Workflow mit Ausgangswert, direkten und indirekten Vorteilen, Qualitätsprüfungen und einer expliziten Abbruchentscheidung entwickeln.
41 MinutenMake-or-Buy-Entscheidungen für KI anhand von Ergebnis, Datenkontrolle, Workload-Wirtschaftlichkeit, Infrastrukturreife und betrieblicher Verantwortung treffen.
20 MinutenPraktische Zugriffskontrollmuster für RAG mit Unternehmenswissen bewerten, bevor sensible interne Dokumente indexiert werden.
30 MinutenDen historischen Zeitplan des Videos mit dem geltenden EU-Recht vergleichen und die aktuellen Fristen anschließend den Aufgaben zu Anbieternachweisen und Zuständigkeiten zuordnen, die ein KMU einplanen muss.
37 MinutenPrivate KI als Infrastruktur- und Governance-Entscheidung bewerten, statt sich reflexartig für SaaS oder Selbstbetrieb zu entscheiden.
69 MinutenDie wahrscheinlich ersten Fehlermodi eigener Agenten erkennen und Tests, Rückfallmechanismen sowie Abschaltkriterien für jeden davon im Voraus planen.
7 MinutenVerstehen, weshalb Dokumentenparsing, Strukturerhalt und Qualitätsprüfungen bei der Aufnahme erforderlich sind, bevor RAG über PDFs und gemischte Dateiformate aufgebaut wird.
6 MinutenDie Kernarchitektur eines Sprachagenten und die Fehlerpunkte erkennen, die das Kundenvertrauen in realen Anrufen beeinträchtigen.
19 MinutenAbschätzen, wann sich Prompt-Caching für reale Workloads lohnt, indem Schreibaufschläge und Einsparungen beim Lesen gegeneinander abgewogen werden.
56 MinutenPrompt-Caching nur einsetzen, wenn stabile Präfixe sowie Latenz- und Kostenverhalten zum Workload passen.

Den Kurs als Beispiel für ein LoRA- oder QLoRA-Experiment nutzen und Ressourcenbedarf sowie Ergebnisse für die gewählte Konfiguration selbst prüfen.

Fine-Tuning in die umfassendere Trainingspipeline einordnen und entscheiden, wann es Prompting oder RAG überlegen ist.
19 MinutenWerkzeuge so gestalten, dass Agenten die richtige Aktion mit den richtigen Parametern auswählen.
29 MinutenEntscheiden können, welches Verhalten in den System-Prompt, die Werkzeugbeschreibung oder die Vorbedingungen des Werkzeugs gehört.
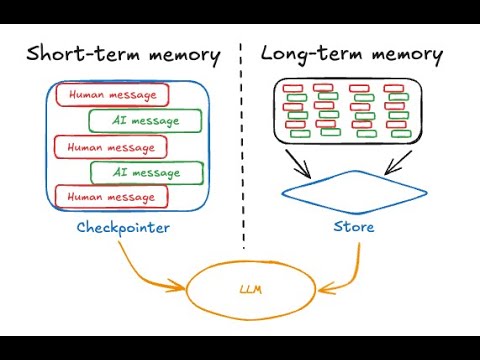
7 MinutenEntscheidungen zu Kurzzeit- und Langzeitgedächtnis trennen und festlegen, wann der Agent Informationen speichern soll.
44 MinutenEpisodisches, semantisches, Arbeits- und prozedurales Gedächtnis in einem Agenten implementieren, statt die Kategorien nur benennen zu können.
9 MinutenTraces, Projekte und Datensätze in LangSmith navigieren sowie Tokenkosten, Latenz, Fehlerrate und Details einzelner Spans ablesen können.
154 MinutenTracing, Evaluation, Feedback und Produktionsprüfung zu einem Betriebszyklus für LLM-Systeme verbinden.
13 MinutenPrompt-Injection als Vermischung nicht vertrauenswürdiger Daten modellieren und Sicherheitsgrenzen für die Werkzeugnutzung entwerfen.
17 MinutenAbwehrmaßnahmen gegen Prompt-Injection prüfen, darunter Taint-Analyse, eingeschränkte Ausgabeformen, Nutzerisolation, deterministische Einstellungen und redundante Kontrollen für kritische Pfade.
9 MinutenErklären, wann Retrieval die richtige Lösung ist und wann Fine-Tuning tatsächlich helfen kann.
13 MinutenAuf Grundlage des tatsächlichen Fehlermusters zwischen Prompt Engineering, RAG, Fine-Tuning oder einer Kombination wählen.
77 MinutenNachvollziehen, wie Fachleute für produktive Prompts Anweisungen, Beispiele und Verhaltensgrenzen unter realem Zeitdruck überarbeiten, statt Prompts als einmalig geschriebenen Text zu behandeln.
25 MinutenBeobachten, wie aus einem vagen Prompt für Versicherungsansprüche ein strukturierter, testbarer Prompt mit klareren Beispielen, Ausgaberegeln und definiertem Ablehnungsverhalten wird.
32 MinutenVerstehen, warum Serving-Engines, Batching und der Speicherbedarf des KV-Caches die Wirtschaftlichkeit selbst betriebener Inferenz bestimmen.