

 7 Minuten
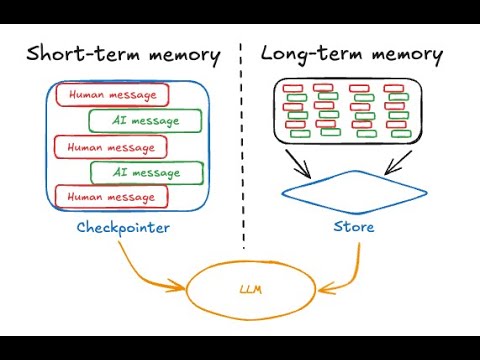
Gedächtnis für Agenten (Konzeptvideo)
Entscheidungen zu Kurzzeit- und Langzeitgedächtnis trennen und festlegen, wann der Agent Informationen speichern soll.
FortgeschrittenAutomatisierungen
Chroma. Kelly Hong stellt Chromas Untersuchung von 18 Modellen vor: weshalb Needle-in-a-Haystack-Ergebnisse irreführend sein können, wie die Leistung bei Mehrdeutigkeit und Ablenkungen nachlässt und warum selbst einfache Aufgaben zur Wiederholung von Zeichenketten jenseits von 500 Tokens schlechter werden. Der Vortrag ist kurz, evidenzbasiert und liefert genau den Befund, den Sie ernst nehmen sollten, bevor der Artikel zu technischen Maßnahmen übergeht.
Modellnamen, Preise und Fähigkeiten ändern sich schnell. Nutzen Sie das Video für das Entscheidungsmuster und prüfen Sie vor dem Einsatz das aktuelle Modellverhalten.
Verstehen, wie lange Kontexte unter Mehrdeutigkeit und Ablenkungen versagen können, und Tests für dieses Risiko entwerfen.
Lediglich grundlegendes LLM-Vokabular; dies ist ein kurzer Forschungsvortrag.
Zuletzt geprüft: 18. Mai 2026
Fahren Sie mit demselben Lernpfad fort und sehen Sie die nächsten kuratierten Begleitvideos.
7 MinutenEntscheidungen zu Kurzzeit- und Langzeitgedächtnis trennen und festlegen, wann der Agent Informationen speichern soll.
 5 Minuten
Verstehen, weshalb screenshotbasierte Computersteuerung gegenüber API-nativer Automatisierung leistungsfähig, aber langsam, teuer und fragil ist.
 13 Minuten
Prompt-Injection als Vermischung nicht vertrauenswürdiger Daten modellieren und Sicherheitsgrenzen für die Werkzeugnutzung entwerfen.
Sorgfältig ausgewählte externe Kurse, die dieses Thema vertiefen.
 DeepLearning.AI
Isa Fulford · Andrew Ng
Neunzig Minuten für die Intuition eines ganzen Jahres. Wenn Sie begonnen haben, Code zu schreiben, der ein LLM aufruft – oder kurz davorstehen –, ist dies der effizienteste Online-Kurs, um die Lücke zwischen „mit ChatGPT experimentieren“ und „eine Funktion mit LLM-Aufruf produktiv bereitstellen“ zu schließen.
 Microsoft Learn
Prompt engineering, but for the tool most office workers will actually touch first. Microsoft's own four-part prompting framework (goal, context, source, expectation) is a genuinely useful mental model, and unlike the generic ChatGPT prompting courses already in our catalog, this one is grounded entirely in Microsoft 365 Copilot's specific quirks and grounding behavior.