

 17 minutter
Conductor-CEO Charlie Holtz viser sin AI-kodemiljøopsætning
Sæt et multi-agent coding-workflow op med eksplicitte review-grænser, så genererede ændringer forbliver små, testede og ejede.
AvanceretAI til virksomheder
Gå i dybden med produktion. Systemdesign, evaluering og de svære arkitekturvalg.
48 resultater
Intet matcher disse filtrePrøv en anden kategori eller et andet niveau, eller fjern filtrene for at se alt.
17 minutterSæt et multi-agent coding-workflow op med eksplicitte review-grænser, så genererede ændringer forbliver små, testede og ejede.
 56 minutter
Byg en ROI-sag for én AI-arbejdsgang med baseline, direkte og indirekte fordele, kvalitetsporte og en eksplicit stopbeslutning.
 41 minutter
Træf AI byg-eller-køb-beslutninger omkring outcome, datakontrol, workload-økonomi, infrastrukturparathed og operationelt ejerskab.
 20 minutter
Evaluér praktiske adgangskontrolmønstre for virksomhedsviden-RAG, før du indekserer følsomme interne dokumenter.
 30 minutter
Sammenlign videoens historiske tidslinje med gældende EU-ret, og omsæt derefter de aktuelle frister til de opgaver om leverandørdokumentation og ejerskab, som en SMV skal planlægge.
 37 minutter
Vurdér privat AI som en beslutning om infrastruktur og styring frem for automatisk at vælge enten SaaS eller selvhosting.
 69 minutter
Genkend de fejltilstande, dine egne agenter rammer først, og forudplanlæg tests, reserveløsninger og kill-kriterier for hver.
 7 minutter
Forstå, hvorfor dokumentparsing, strukturbevarelse og ingestion-kvalitetsporte betyder noget, før du bygger RAG over PDF'er og blandede filformater.
 6 minutter
Genkend kernearkitekturen i en voice-agent og de fejltilstande, der påvirker kundetillid i rigtige opkald.
 211 minutter
Forstå den moderne LLM-stack godt nok til at ræsonnere om tokens, træning, værktøjer og fejl.
 40 minutter
Evaluér produktidéer med partial autonomy, hvor mennesker beholder kontrollen over high-risk-beslutninger.
 190 minutter
Du kan bygge en LangGraph-agent med typed state, conditional routing, checkpoints og tool use og mærke, hvor eksplicitheden betaler sig.
 66 minutter
Du kan stille et CrewAI-crew op i role-goal-backstory-stilen og vurdere, hvordan dens skjulte eksekveringssløjfe sammenlignes med eksplicitte grafer.
 15 minutter
Design enklere agentsløjfer med klare stopregler, opgavegrænser og menneskelige kontrolpunkter.
 18 minutter
Genkend almindelige agentbygge-faldgruber, før du tilføjer flere agenter, komplekse prompts eller skjult tilstand.
 5 minutter
Forstå, hvorfor screenshot-baseret computer use er kraftfuld, langsom, dyr og skrøbelig sammenlignet med API-native automatisering.
 8 minutter
Beslut, hvor browser- eller computer-use-agenter kan være kommercielt nyttige trods deres operationelle risiko.
 22 minutter
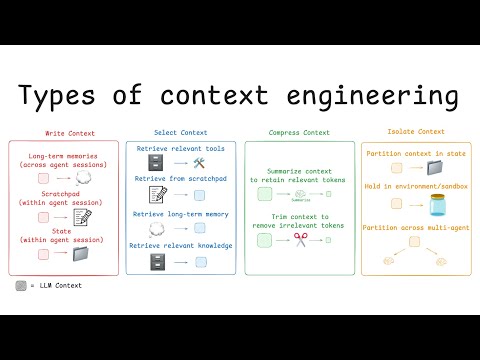
Anvend write-, select-, compress- og isolate-mønstre til at håndtere agentkontekst bevidst.
 8 minutter
Forstå, hvordan lang kontekst kan fejle under ambiguitet og distractors, og design derefter tests omkring den risiko.
 19 minutter
Du kan estimere, hvornår promptcaching betaler sig, ved at veje cache-write-tillæg op mod read-besparelser for dine reelle workloads.
 56 minutter
Brug kun promptcaching, når stabile præfikser, latenstid og omkostningsadfærd matcher workloaden.
 55 minutter
Design en eval-stige, der fanger regressioner, før prompt- eller modelændringer når brugerne.
 19 minutter
Se, hvordan et produktionsteam lægger assertions, menneskelig gennemgang og LLM-judges i lag, så regressioner dukker op før release.
 157 minutter
Få et grundlag for at gennemføre eksperimenter med kvantisering, LoRA og QLoRA fra start til slut på passende hardware.
 59 minutter
Placér finjustering i den bredere træningsproces, og vurdér, hvornår den kan være mere relevant end udformning af prompts eller RAG.
 104 minutter
Forstå, hvordan MCP passer ind i agentiske systemer ud over en lokal demo-server.
 75 minutter
Byg en første MCP-server, og forstå, hvordan tools, schemas, prompts, resources og transports hænger sammen.
 19 minutter
Forbedr værktøjsdesign, så agenter vælger den rigtige handling med de rigtige parametre.
 29 minutter
Beslut, hvilken adfærd der hører hjemme i systemprompten, værktøjsbeskrivelsen eller værktøjsforudsætningen.
 7 minutter
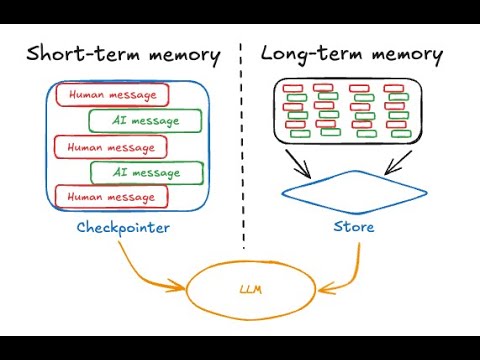
Skeln mellem beslutninger om kortvarig og langvarig hukommelse, og vurdér, hvornår en AI-agent bør skrive til sin hukommelse.
 44 minutter
Få et grundlag for at implementere episodisk, semantisk, arbejdende og proceduremæssig hukommelse i en AI-agent frem for blot at navngive kategorierne.
 9 minutter
Du kan navigere traces, projects og datasets i LangSmith og aflæse token-omkostning, latenstid, fejlrate og per-span-detalje.
 154 minutter
Forbind tracing, evaluering, feedback og produktionsgennemgang til en driftsløkke for LLM-systemer.
 17 minutter
Forstå, hvad der går i stykker, når RAG flytter ind i reguleret, high-stakes enterprise-brug.
 19 minutter
Identificér de produktions-RAG-kontroller, der mangler i naive document-chat-demoer.
 13 minutter
Modellér promptinjektion som blanding af utroværdige data, og design grænser omkring tool use.
 17 minutter
Gennemgå forsvar mod promptinjektion såsom taint analysis, begrænsninger af outputform, brugerisolation, deterministiske indstillinger og redundante tjek for kritiske stier.
 9 minutter
Forklar, hvornår retrieval er den rigtige fix, og hvornår finjustering faktisk kan hjælpe.
 13 minutter
Vælg mellem prompt engineering, RAG, finjustering eller en kombination baseret på den faktiske fejltilstand.
 77 minutter
Hør, hvordan produktions-prompt engineers reviderer instruktioner, eksempler og adfærdsbegrænsninger under reelt pres i stedet for at behandle prompts som engangstext.
 25 minutter
Se en vag forsikringsclaims-prompt blive til en struktureret, testbar prompt med klarere eksempler, outputregler og refusal-adfærd.
 39 minutter
Sammenlign agentisk retrieval og graph retrieval i en konkret implementering.
 16 minutter
Forstå Microsoft-stil GraphRAG-flowet: entity extraction, communities, summaries og query-focused synthesis.
 32 minutter
Forstå, hvorfor inferensmotorer, batchbehandling og hukommelse til KV-cache har stor betydning for økonomien i selvhostet inferens.
 42 minutter
Vurdér, hvornår vertikale AI-agenter skaber reel forsvarlighed, og hvornår de kun er tynde wrappers.
 34 minutter
Evaluér AI-produktprissætning og specialisering omkring målbare outcomes frem for antal sæder.
 41 minutter
Du kan forklare, hvad strict mode garanterer, hvordan det adskiller sig fra gammel JSON-mode, og hvordan refusal-håndtering passer til structured-output-kontrakten.
 18 minutter
Lær, hvorfor schema-first LLM-kald behøver typede objekter, validators, retries og eksplicit håndtering af malformerede eller hallucinerede felter.