

 7 minutter
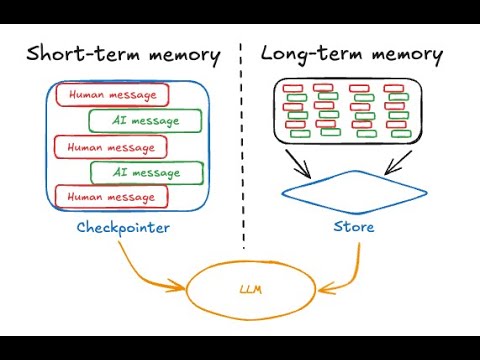
Hukommelse til agenter (konceptuel video)
Skeln mellem beslutninger om kortvarig og langvarig hukommelse, og vurdér, hvornår en AI-agent bør skrive til sin hukommelse.
AvanceretAutomatiseringer
Chroma. Kelly Hong gennemgår Chromas research på 18 modeller — hvorfor needle-in-haystack-scores er misvisende, hvordan performance degraderer med ambiguitet og distractors, hvorfor selv simple string-repetition-opgaver degraderer forbi 500 tokens. Kort, evidensbaseret og præcis den sag, artiklen behøver, at du tager alvorligt, før du kommer til engineering-grebene.
Modelnavne, priser og kapaciteter ændrer sig hurtigt. Brug den til beslutningsmønsteret, og verificér derefter aktuel modeladfærd, før du adopterer det.
Forstå, hvordan lang kontekst kan fejle under ambiguitet og distractors, og design derefter tests omkring den risiko.
Intet ud over grundlæggende LLM-vocabular — det er et kort research-talk.
Senest gennemgået: 18. maj 2026
Fortsæt ad den samme læringsvej med de næste kuraterede videoer.
7 minutterSkeln mellem beslutninger om kortvarig og langvarig hukommelse, og vurdér, hvornår en AI-agent bør skrive til sin hukommelse.
 5 minutter
Forstå, hvorfor screenshot-baseret computer use er kraftfuld, langsom, dyr og skrøbelig sammenlignet med API-native automatisering.
 13 minutter
Modellér promptinjektion som blanding af utroværdige data, og design grænser omkring tool use.
Håndplukkede eksterne kurser, der går i dybden med dette emne.
 DeepLearning.AI
Isa Fulford · Andrew Ng
Halvfems minutter, der giver dig et års praktisk intuition. Hvis du er begyndt at skrive kode, som kalder en LLM — eller står foran at gøre det — er dette det mest effektive onlinekursus til at lukke hullet mellem "at lege med ChatGPT" og "at sætte en funktion, der kalder en LLM, i produktion."
 Microsoft Learn
Prompt engineering, but for the tool most office workers will actually touch first. Microsoft's own four-part prompting framework (goal, context, source, expectation) is a genuinely useful mental model, and unlike the generic ChatGPT prompting courses already in our catalog, this one is grounded entirely in Microsoft 365 Copilot's specific quirks and grounding behavior.