17 minuterConductor-vd:n Charlie Holtz visar sin AI-baserade utvecklingsmiljö
Skapa ett arbetsflöde med flera kodningsagenter och uttryckliga granskningsgränser så att genererade ändringar förblir små, testade och har en tydlig ansvarig.
Produktionsdjup. Systemdesign, utvärderingar och de svåra arkitektoniska besluten.
26 resultat
Inget matchar dessa filterFörsök med en annan kategori eller nivå, eller rensa filtren för att se allt.
17 minuterSkapa ett arbetsflöde med flera kodningsagenter och uttryckliga granskningsgränser så att genererade ändringar förblir små, testade och har en tydlig ansvarig.
56 minuterTa fram ett avkastningsunderlag för ett AI-arbetsflöde med ett utgångsläge, direkta och indirekta fördelar, kvalitetsgrindar och ett uttryckligt beslut om att avbryta.
41 minuterFatta beslut om att bygga eller köpa AI utifrån resultat, kontroll över data, arbetsbelastningens ekonomi, infrastrukturens beredskap och operativt ansvar.
20 minuterBedöm praktiska mönster för åtkomstkontroll i RAG för företagskunskap innan känsliga interna dokument indexeras.
30 minuterJämför videons historiska tidsplan med gällande EU-rätt och koppla sedan de aktuella tidsfristerna till de uppgifter kring leverantörsunderlag och ansvar som ett litet eller medelstort företag måste planera in.
37 minuterBedöm privat AI som ett beslut om infrastruktur och styrning i stället för att instinktivt välja antingen SaaS eller egen drift.
69 minuterIdentifiera vilka fellägen dina egna agenter sannolikt kommer att drabbas av först och planera tester, reservlösningar och avvecklingskriterier för vart och ett.
7 minuterFörstå varför dokumenttolkning, bevarande av struktur och kvalitetsgrindar vid inläsning är viktiga innan RAG byggs för PDF-filer och blandade filformat.
6 minuterKänn igen en röstassistents centrala arkitektur och de felkällor som påverkar kundernas förtroende under verkliga samtal.
19 minuterDu kan uppskatta när promptcachelagring lönar sig genom att väga pristillägget för cacheskrivningar mot besparingen vid läsning för dina verkliga arbetsbelastningar.
56 minuterAnvänd promptcachelagring endast när stabila prefix, latens och kostnadsbeteende passar arbetsbelastningen.
157 minuterAnvänd kursen som exempel för att planera ett LoRA- eller QLoRA-experiment och mät själv resursbehov och resultat för vald konfiguration.
59 minuterPlacera finjustering i den bredare träningsprocessen och avgör när den är bättre än promptning eller RAG.
19 minuterFörbättra verktygsdesignen så att agenter väljer rätt åtgärd med rätt parametrar.
29 minuterAvgör vilket beteende som hör hemma i systemprompten, verktygsbeskrivningen eller verktygets förvillkor.
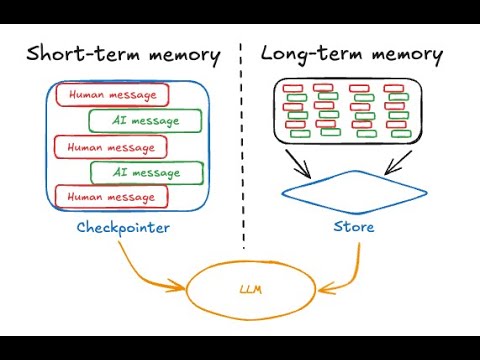
7 minuterSkilj beslut om korttidsminne från beslut om långtidsminne och avgör när agentens minne ska skrivas.
44 minuterDu kan koppla episodiskt, semantiskt, arbets- och procedurminne till en agent i kod, inte bara namnge kategorierna.
9 minuterDu kan navigera bland spår, projekt och datamängder i LangSmith och läsa av tokenkostnad, latens, felfrekvens och detaljer per spann.
154 minuterKoppla samman spårning, utvärdering, återkoppling och produktionsgranskning till en operativ återkopplingsloop för LLM-system.
13 minuterModellera promptinjektion som en sammanblandning av data som inte är betrodda och utforma gränser kring verktygsanvändningen.
17 minuterGranska försvar mot promptinjektion, till exempel taintanalys, begränsningar av utdataformat, användarisolering, deterministiska inställningar och redundanta kontroller för kritiska flöden.
9 minuterFörklara när informationshämtning är rätt lösning och när finjustering faktiskt kan vara till hjälp.
13 minuterVälj promptutformning, RAG, finjustering eller en kombination utifrån det faktiska felläget.
77 minuterHör hur promptingenjörer i produktion omarbetar instruktioner, exempel och beteendemässiga begränsningar under verklig press i stället för att behandla prompter som engångstexter.
25 minuterSe hur en vag prompt för försäkringsanspråk blir en strukturerad, testbar prompt med tydligare exempel, regler för utdata och beteende vid vägran.
32 minuterFörstå varför serveringsmotorer, batchning och minne för KV-cache dominerar ekonomin för inferens i egen drift.