

AI ettevõttes
Ettevõtte AI-süsteemid, kasutuselevõtu valikud, klienditöövood ja mõõdetavad tulemused.
34 lugu (17 artiklit · 17 videot)
Alusta siit
Mõned head esimesed materjalid enne kogu voo sirvimist.
 11 min lugemist
Kuidas kavandada AI kasutuselevõttu meeskonnas
Praktiline AI kasutuselevõtu mängukava: vali piiritletud kasutusjuhud, kaasa mõjutatud töötajad, määra andme- ja otsustusreeglid, koolita päristöö põhjal ning võrdle mõju lähteolukorraga.
Edasijõudnud 9 min lugemist
Kuidas hinnata AI tasuvust ja valmisolekut laiemaks kasutuselevõtuks
AI kasutuselevõttu ei tohiks mõõta selle järgi, mitu inimest proovis ChatGPT-d. Praktiline raamistik töövoo ROI, kvaliteedi, riski, küpsuse ja skaleerimisvalmiduse mõõtmiseks.
Ekspert 9 min lugemist
Kas AI-süsteem osta või ise arendada?
Võrdle ostu, konfigureerimise, laiendamise, ehitamise ja isehostimise variante samade nõuete, vetoportaalide, esindusliku katse ja kogukulu mudeliga.
EkspertVeel selles teemas
 9 min lugemist
DGX Spark: kellele see sobib ja kuidas toetab kohalikke AI-agente
Faktipõhine ülevaade NVIDIA DGX Sparkist: Grace Blackwell GB10 tehnilised näitajad, koherentne ühtmälu, ConnectX-7 klasterdamine ja olukorrad, kus lauaarvuti mõõtu agentserver on privaatse AI jaoks õige valik.
Ekspert 12 min lugemist
Codex, Claude Code ja Cursor ühises käsureatöövoos
Kasuta faile AGENTS.md ja CLAUDE.md, Cursori reegleid ning CLI väljundirežiime nii, et Codex kavandab, Claude vaatab üle ja Cursor teostab — ilma eraldi orkestreerimisplatvormita.
Ekspert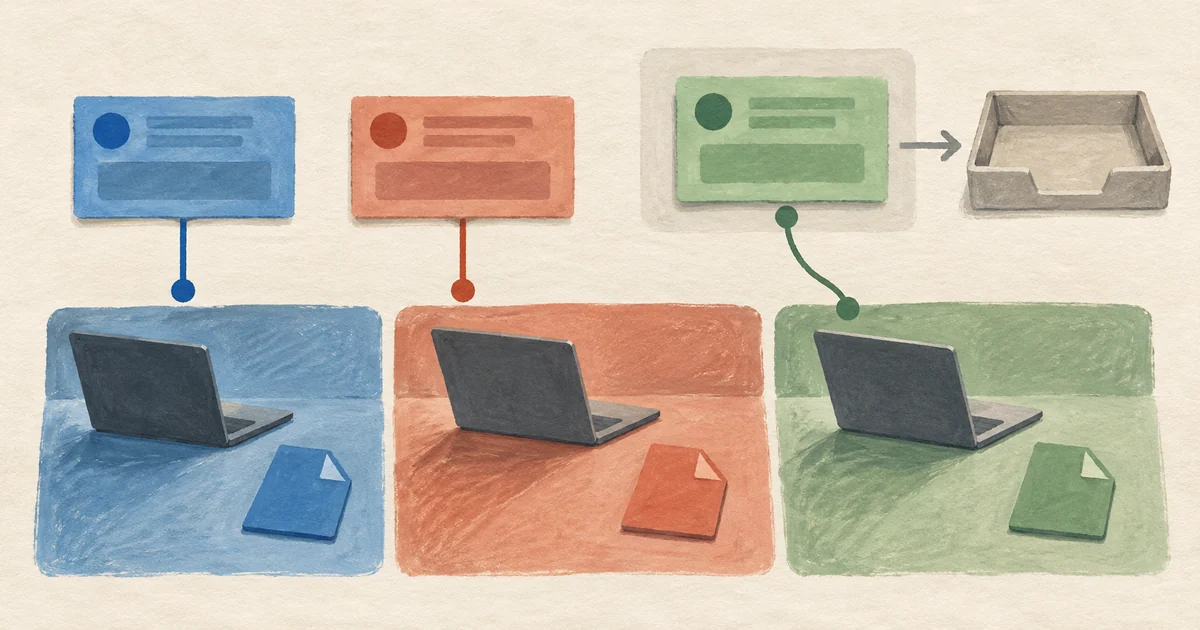 15 min lugemist
Claude, Cursor ja Codex ühes Lineari projektis: ülesannete ja ülevaatuse korraldamine
Jooksuta Claude Code'i, Cursorit ja Codexit sama Lineari projekti kallal nagu päris inseneritiimi: võta töö endale, märgi edenemist, anna ülevaatus üle, paranda leiud ja sulge issue'd nii, et agendid üksteisele jalgu ei jää.
Ekspert 8 min lugemist
Töö väärikus: kuidas arvestada inimestega tööd automatiseerides
Praktiline töö ümberkujundamise hinnang VKE-de juhtidele: vaata enne automatiseerimise edukaks kuulutamist üle töötajate hääl, säilinud otsustusõigus, oskuste arengutee, töökoormus, jälgimine ja vaidlustamine.
Edasijõudnud 8 min lugemist
Mida öelda meeskonnale, kui automatiseerid osa nende tööst
Praktiline suhtluse järjestus automatiseerimisprojektidele: mida öelda enne otsuse kinnistumist, millised lubadused loovad usaldust ja milliseid lubadusi juhid ei tohiks anda.
Edasijõudnud 32 minutit
Kuidas ehitada inimkeskseid AI-töövooge lokaliseerimises — Shashi Bhushaniga
Crowdin. Shashi Bhushan alustab töövoo kaardistamisest, mitte tööriista valimisest, ning räägib lähtekeele kvaliteedist, inimese ülevaatusest, AI-korrektuurist, terminisõnastiku kontrollidest, tootetiimi kaasamisest, pilootidest ja privaatsuspiirangutest. See on väga lähedal töökorraldusele, mida artikkel soovitab Eesti tiimidele, kes töötavad eesti, inglise, vene, soome ja kliendispetsiifilise terminoloogiaga.
Edasijõudnud 4 minutit
Tutvustame EmbeddingGemmat: oma klassi parim avatud mudel seadmesisesteks embedding'uteks
Google for Developers. Video tutvustab mitmekeelseid tekstivektoreid, mis saavad töötada lokaalselt ning toetada semantilist otsingut ja RAG-i ilma iga dokumenti majutatud API-sse saatmata. Eesti ettevõtetele on see tehniline täiendus artikli siseteadmiste otsingu mustrile: mitmekeelne otsing on kasulik ainult siis, kui see austab ka andmete asukohta, ligipääsuõigusi ja allika autoriteeti.
Edasijõudnud 17 minutit
Conductori tegevjuht Charlie Holtz näitab oma AI-kodeerimise töövoogu
Y Combinator. Konkreetne senior-inseneri töövoog, mitte paneel: Holtz võrdleb Claude Code'i ja Codexit, orkestreerib mitut koodiagenti paralleelselt ning märgib ära "slop-vabad tsoonid", kuhu genereeritud kood ei tohi ilma ülevaatuseta jõuda. See töökorraldus kehastab artikli reegleid — repo kontekst, väikesed ülevaadatavad muudatused ja inimene, kes jääb arhitektiks, kui agendid trükivad.
Ekspert 56 minutit
AI-agendid rahanduses HPE finantsjuhiga (CFO)
CXOTalk. HPE finantsjuht Marie Myers kirjeldab agentse AI (nende "Alfredi" platvormi) juurutamist 3600 inimesega finantsorganisatsioonis just selle distsipliiniga, mida artikkel nõuab: otsese ja kaudse ROI raamistik, etapiväravad, mis otsustavad iga kasutusjuhu jätkamise või peatamise, kohustuslik inimkontroll kvaliteedile ning töövoo tasemel mõõdikud, näiteks iganädalane ülevaatusprotsess, mille käsitsitööst kadus umbes 90%. Kasutuselevõttu mõõdetakse muutunud tööna, mitte tööriista sisselogimistena.
Ekspert 41 minutit
Privaatne AI vs pilv: kuidas juhid saavad teha targemaid build-or-buy otsuseid
World Wide Technology. Seob build-or-buy valikud äritulemuste, töökoormuse paigutuse, pilveökonoomika, andmesuveräänsuse, turbe, infrastruktuuri valmisoleku ja hübriidsete töökorraldustega. See aitab otsustada, millal osta tööriist, laiendada platvormi, ehitada õhuke kohandatud kiht või omada suuremat osa juurutusest.
Ekspert 10 min lugemist
Mitmekeelsed AI-töövood Eesti ettevõtetele
Praktiline töövoomudel Eesti ettevõtetele, kes töötavad eesti, inglise, vene, soome ja teiste kliendikeeltega ilma tooni, terminoloogiat, privaatsust või vastutust kaotamata.
Edasijõudnud 9 min lugemist
AI-ga arendamine: IDE-d, koodibaasi kontekst ja töökorraldus
Cursor, Copilot, Claude Code ja repositooriumit tundvad agendid muudavad tarkvaratööd ainult siis, kui tiimid lisavad piirid. Praktiline töövoog koodibaasi konteksti, planeerimise, testide, ülevaatuse, saladuste ja tootmisohutuse jaoks.
Ekspert 9 min lugemist
EU AI Act for SMEs: a practical governance plan
The EU AI Act is not just a legal problem for large vendors. A practical SME plan for inventory, risk classification, human oversight, transparency, vendor records, and rollout discipline.
Ekspert 10 min lugemist
Privaatse AI lahendused: kohalik seade, VPC, oma server või hübriid
Privaatne AI ei ole üks arhitektuur. Praktiline võrdlus kohalike mudelite, ettevõtte SaaS-i, VPC-juurutuste, isehostitud inferentsi ja hübriidmustrite vahel privaatsust ja kontrolli vajavatele VKE-dele.
Ekspert 12 min lugemist
Inferentsikulude vähendamine: promptide vahemälu, mudelivalik ja väljundi piiramine
Koosta jälitusandmetel põhinev tehisintellekti väljundkulu mudel, optimeeri suurimad mõõdetud panustajad ja tõesta, et iga muudatus säilitab ülesande kvaliteedi.
Ekspert 10 min lugemist
AI-töövoo kvaliteedi hindamine ilma programmeerimiseta
Hindamisi — AI-väljundi kvaliteedi süsteemset mõõtmist — käsitletakse tavaliselt inseneride mureks. Aga iga AI-töövooge jooksutav tiim vajab neid, ja põhitõed on koodita kättesaadavad. Kuidas-juhend.
Edasijõudnud 12 min lugemist
Kuidas kavandada MCP-tööriistu, mida keelemudel oskab kasutada
Enamik MCP tööriistu, mida me näeme, on tehniliselt korrektsed ja praktiliselt kasutud. LLM-id ignoreerivad neid, kasutavad valesti või kutsuvad neid kasututel viisidel. Põhimõtted tööriistade kujundamiseks, mida LLM-id loomulikult omaks võtavad, koos näidetega levinud läbikukkumistest ja nende parandustest.
Ekspert 12 min lugemist
LLM-rakenduste seire: päringujäljed, kulud, viiteajad ja kvaliteedi muutused
Laienda tavalist jälgitavust mitmesammuliste jälgimisvoogude, atribuutitava kulu, prompti ja mudeli versioonide, hinnatud kvaliteedisignaalide, privaatsuskontrollide ja töökoormusest tulenevate hoiatustega.
Ekspert 12 min lugemist
Promptimine, RAG või peenhäälestus: mida valida ja millal kombineerida?
Prompting, RAG ja peenhäälestus on kolm suurt hooba LLM-ide kohandamiseks sinu probleemile. Iga sobib mõnele probleemile ja ei sobi teistele. Raamistik valimiseks, iga reaalsed kulud ja toodangumustrid, kus nende kombineerimine hiilgab.
Ekspert 19 minutit
Kas see on RAG-i lõpp? Anthropicu UUS prompti caching
Prompt Engineering. Käib läbi Anthropicu prompti caching'u vs Gemini konteksti-caching'u koos konkreetsete latentsuse ja kulu vähenemistega kasutusjuhtumi kohta (pikkade dokumentide chat, few-shot, multi-turn). Cache-write lisatasu vs cache-read soodustuse lahtimõtestamine on täpselt see, mida artikkel eeldab, kui ta räägib sellest, millal caching ennast ära tasub.
Ekspert 56 minutit
Build Hour: Prompt Caching
OpenAI. OpenAI enda Build Hour prompti caching'ust — 1024-tokeni künnis, eesliite-stabiilsuse nõue, audio caching 99% soodustusega realtime'i jaoks, time-to-first-token mõjud pikkade sisendite korral. Kasulik, kui mõõdad inseneri-pingutust, mida nõuab cache'i päriselt usaldusväärselt tabamine oma produktsiooni-promptidel.
Ekspert 107 minutit
Miks AI evaluatsioonid on toote-ehitajatele kuumim uus oskus | Hamel Husain ja Shreya Shankar
Lenny's Podcast. Husaini ja Shankari arutelu täiendab artikli nõuet määrata ülevaatamise eest vastutaja ning siduda sagedus muudatuste, juhtumite ja täheldatud tõrgetega. Ülevaatamise ajakulu tuleb hinnata oma töövoo põhjal.
Edasijõudnud 3 minutit
Hinda AI-juhiseid Anthropic Console'is
Anthropic. Kolmeminutiline Anthropicu läbikäik päris evaluatsiooni jooksutamisest Workbenchi sees — realistlike testjuhtumite auto-genereerimine, väljundite hindamine, juhise muutmine ja sama komplekti uuesti kõrvuti jooksutamine. Vaatamiste arv jääb tavalisest piirist allapoole, aga "kuidas ma seda päriselt ilma koodi kirjutamata teen" jaoks on see puhtaim ametlik demo ja istub kenasti strateegilisema Husaini/Shankari vestluse alla.
Edasijõudnud 19 minutit
Tõhusamate AI-agentide ehitamine
Anthropic. Anthropicu insenerid käivad läbi, mida nad päriselt muutsid, kui nende mitme-agendi süsteemid tööriistu valesti kasutasid — endpointide kokku surumine, ID-de asemel nimede tagastamine, MCP-dele ja Agent Skillsile toetumine selle asemel et süsteemi prompti rohkem tööriistu sisse toppida. Kaardistub punkt-punktilt artikli tööriistade kirjelduste ja tagastusvormi disaini kontrollnimekirjale.
Ekspert 29 minutit
Agentide promptimine | Code w/ Claude
Anthropic. Hannah Moran ja Jeremy Hadfield Applied AI-st käivad läbi, kuidas tööriistakutseid ja agendi prompte sõnastada päris Pokemoni-mängiva agendi peal — millal lükata käitumine süsteemi prompti versus tööriista kirjeldusse, mida mudel peab teadma iga tööriista eeltingimuste kohta. Kasulik kohe pärast oma esimese MCP serveri kirjutamist, kui leiad, et Claude seda ootamatutel viisidel kutsub.
Ekspert 9 minutit
LangSmith 10 minutiga
LangChain. LangChaini kaasasutaja tutvustab LLM-i päringujälgi, projekte ja andmestikke: tokenikulu, latentsust, veamäära, tagasiside koondamist ning ühe otsinguetapi detailvaadet. Video näitab visuaalselt, miks struktureeritud päringujäljed annavad rohkem teavet kui lihtne konsoolilogimine.
Ekspert 154 minutit
LLM-ide instrumenteerimine ja hindamine
Hamel Husain. Hamel Husain, Eugene Yan, Brian Bischof, Harrison Chase ja Shreya Shankar käsitlevad päringujälgi, logianalüüsi, mudelipõhist hindamist ning päris tootmisandmete ülevaatamise töökorraldust. Pikk loeng seob artikli jälgitavuse põhimõtted praktiliseks hindamis- ja tagasisidetsükliks.
Ekspert 9 minutit
RAG vs Fine Tuning
IBM Technology. Tihedam fookus kahele tehnikale, mida tiimid kõige sagedamini segi ajavad. Läheb sügavamale andmete värskuse, allika atributsiooni ja inference-aja kiiruse argumendi osas fine-tuningu poolt. Vaatamist väärt, kui üritad spetsiifiliselt argumenteerida tarbetu fine-tune projekti vastu.
Ekspert 13 minutit
RAG vs Fine-Tuning vs prompti inseneeria: AI-mudelite optimeerimine
IBM Technology. Selge tahvli-läbikäik kõigist kolmest tehnikast koos nende vastavate kuludega — leidmise latentsus, treenimise arvutusvõimsus ja katastroofiline unustamine, ainult-promptiga lahenduste piirid — ja kombinatsioonid, mis produktsioonis päriselt mõtet annavad. Lõpetav näide juriidilisest AI-süsteemist, mis kasutab kõiki kolme, on peaaegu täpselt artikli "millal kombineerida" argument.
Ekspert 8 minutit
Whartoni professor: 4 stsenaariumi AI tuleviku jaoks | Ethan Mollick Big Think+-ile
Big Think. Tihke 8-minutiline versioon Mollicki "neli stsenaariumi" mudelist — staatiline, lineaarne, eksponentsiaalne, AGI — ja miks tiimid peaksid planeerima stsenaariumi kaks või kolm vastu, mitte panustama kõike kumbalegi äärmusele. Kasulik, kui püüad saada juhtkonda kokku leppima, mille vastu nad päriselt valmistuvad, enne kui mängukava kirjutad.
Edasijõudnud 60 minutit
Iga juht vajab seda AI strateegiat | Ethan Mollick selgitab
Sana. Tund Mollickiga selle kohta, milline AI organisatsioonide sees päriselt välja näeb — miks "kärpida kulusid" on vale raamistus, miks traditsioonilised organisatsiooniskeemid kõverduvad ja mida "AI-nat" tiimid teisiti teevad. Jääb tavalisest 100k piirist allapoole, aga see on selgeim praktik-tasandi vestlus kasutuselevõtu strateegiast uurijalt, keda sellel teemal kõige järjekindlamalt tsiteeritakse, ja artikli mängukava-mured kaardistuvad peaaegu 1:1 tema raamistusele.
Edasijõudnud