

AI för företag
Verksamhetsnära AI-system, val vid införande, kundarbetsflöden och mätbara resultat.
34 innehållsposter (17 artiklar · 17 videor)
Börja här
Börja med några rekommenderade innehållsposter innan du går igenom hela flödet.
 11 min läsning
Utforma en handbok för AI-införande i teamet
En praktisk handbok för AI-införande: välj avgränsade användningsfall, involvera berörd personal, fastställ regler för data och beslut, träna på verkligt arbete och mät effekten mot en baslinje.
Mellannivå 9 min läsning
AI-avkastning och mognad: så mäter du ett införande som faktiskt fungerar
AI-införande bör inte mätas efter hur många som har provat ChatGPT. Ett praktiskt ramverk för att mäta arbetsflödets avkastning, kvalitet, risk, mognad och beredskap för skalning.
Avancerad 9 min läsning
Bygga eller köpa AI-system: ett praktiskt beslutsramverk
Jämför köp, konfigurering, utökning, egenutveckling och egen drift med samma krav, uteslutningskriterier, representativa prov och modell för totalkostnad.
AvanceradMer i detta ämne
 9 min läsning
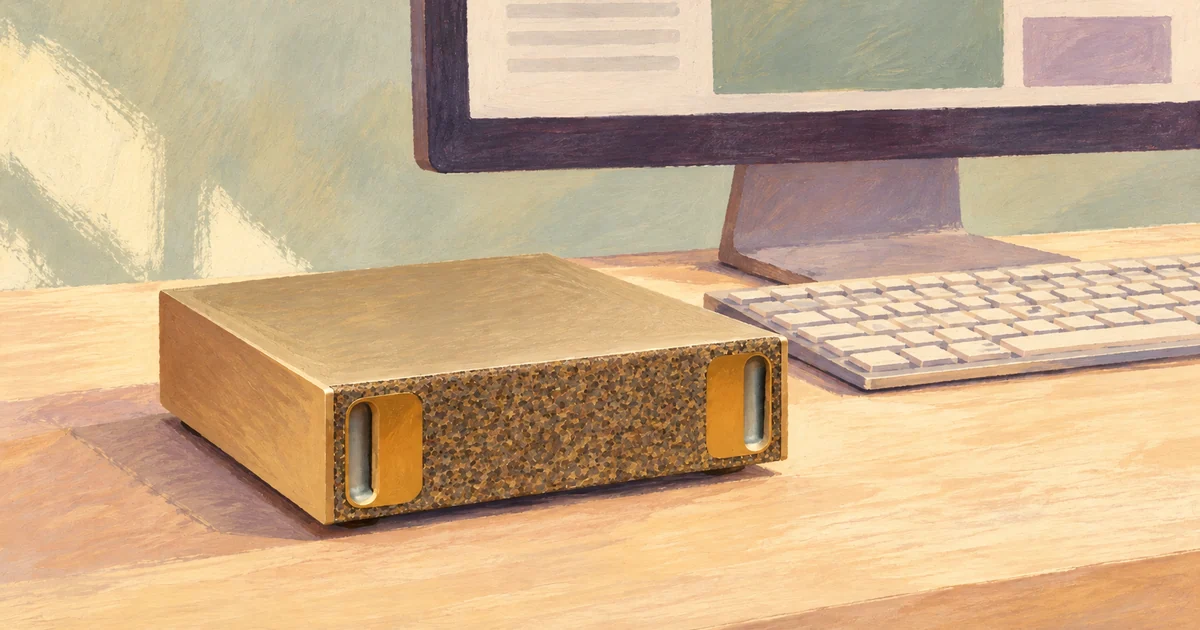
DGX Spark: vad det är, vem det är till för och vad som ändrats för lokala agenter
En saklig genomgång av NVIDIA DGX Spark: Grace Blackwell GB10-specifikationer från NVIDIA, koherent enhetligt minne, ConnectX-7-klustring och när en agentdator för skrivbordet är rätt satsning på privat AI.
Avancerad 12 min läsning
Få Codex, Claude Code och Cursor att arbeta som ett CLI-team
Använd AGENTS.md, CLAUDE.md, Cursor-regler och CLI-verktygens icke-interaktiva lägen så att Codex designar, Claude granskar och Cursor implementerar, utan en egen orkestreringsplattform.
Avancerad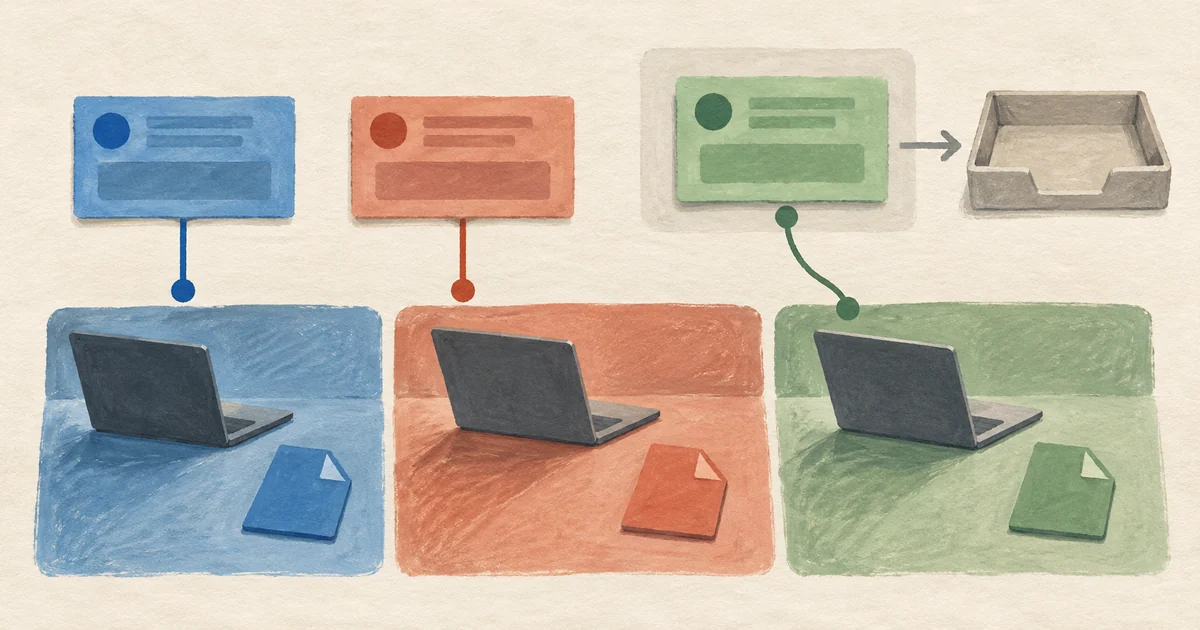 15 min läsning
Projektledning för flera agenter med Linear: Claude, Cursor och Codex i samma backlog
Låt Claude Code, Cursor och Codex arbeta i samma Linear-projekt som ett riktigt ingenjörsteam: reservera arbete, markera framsteg, lämna över till granskning, åtgärda fynd och stäng ärenden utan att trampa på varandra.
Avancerad 8 min läsning
Arbetets värdighet när maskiner kan göra mer av det
En praktisk bedömning av hur jobb utformas om för ledare i små och medelstora företag: granska medarbetarnas inflytande, bevarat omdöme, kompetensvägar, arbetsbelastning, övervakning och möjligheter att överklaga innan du kallar en automatisering framgångsrik.
Mellannivå 8 min läsning
Vad du ska säga till teamet när du automatiserar en del av deras jobb
En praktisk plan för kommunikationen i automatiseringsprojekt: vad du ska säga innan beslutet låses, vilka åtaganden som bygger förtroende och vilka löften chefer inte ska ge.
Mellannivå 32 minuter
Så bygger du människocentrerade AI-arbetsflöden för lokalisering med Shashi Bhushan
Crowdin. Shashi Bhushan börjar med att kartlägga arbetsflödet i stället för att välja verktyg och tar sedan upp källtextens kvalitet, mänsklig granskning, AI-baserad korrekturläsning, ordlistekontroller, produktteamets medverkan, pilotprojekt och integritetsbegränsningar. Det är nästan exakt den verksamhetsmodell som artikeln rekommenderar för estniska team som arbetar på estniska, engelska, ryska och finska samt med kundspecifik terminologi.
Mellannivå 4 minuter
Vi presenterar EmbeddingGemma: den ledande öppna modellen för embeddings på enheter
Google for Developers. Videon introducerar flerspråkiga textembeddings som kan köras lokalt och stödja semantisk sökning och RAG utan att varje dokument skickas till ett driftat API. För estniska företag är det ett användbart tekniskt komplement till artikelns mönster för intern kunskapssökning: flerspråkig informationshämtning är bara värdefull när den även respekterar datalokalitet, behörigheter och källans auktoritet.
Mellannivå 17 minuter
Conductor-vd:n Charlie Holtz visar sin AI-baserade utvecklingsmiljö
Y Combinator. En konkret genomgång av en erfaren utvecklares arbetssätt i stället för ett panelsamtal: Holtz jämför Claude Code och Codex, samordnar flera kodningsagenter parallellt och markerar ”slop-free zones” där genererad kod inte får införas utan granskning. Upplägget förkroppsligar artikelns regler – kontext från kodförrådet, små granskningsbara ändringar och en människa som behåller arkitektansvaret medan agenterna skriver koden.
Avancerad 56 minuter
AI-agenter inom ekonomi med HPE:s ekonomichef (CFO)
CXOTalk. HPE:s ekonomichef Marie Myers beskriver införandet av agentbaserad AI (företagets plattform ”Alfred”) i en ekonomiavdelning med 3 600 medarbetare och den disciplin som artikeln förespråkar: en modell för direkt kontra indirekt avkastning, beslutspunkter som avgör om varje användningsfall fortsätter eller stoppas, obligatoriska kvalitetskontroller med människan i processen och mått på arbetsflödesnivå, till exempel en veckovis granskningsprocess där det manuella arbetet minskade med omkring 90 %. Införandet mäts som förändrat arbete, inte som inloggningar i verktyget.
Avancerad 41 minuter
Privat AI kontra molnet: så kan företagsledare fatta bättre beslut om att bygga eller köpa
World Wide Technology. Kopplar beslut om att bygga eller köpa till verksamhetsresultat, placering av arbetsbelastningar, molnekonomi, datasuveränitet, säkerhet, infrastrukturens beredskap och hybrida driftsmodeller. Det gör videon till ett användbart strategiskt komplement när man ska avgöra om man bör köpa ett verktyg, bygga ut en plattform, utveckla ett tunt anpassat lager eller ta ett större ansvar för teknikstacken för driftsättning.
Avancerad 10 min läsning
Flerspråkiga AI-arbetsflöden för estniska företag
En praktisk arbetsflödesmodell för estniska företag som arbetar på estniska, engelska, ryska, finska och andra kundspråk utan att förlora tonalitet, terminologi, integritet eller ansvar.
Mellannivå 9 min läsning
AI-anpassade utvecklingsmiljöer och kodarbetsflöden med kännedom om kodarkivet
Cursor, Copilot, Claude Code och agenter med kännedom om kodarkivet förändrar programvaruutvecklingen först när teamen sätter gränser. Ett praktiskt arbetsflöde för kodbaskontext, planering, tester, granskning, hemligheter och produktionssäkerhet.
Avancerad 9 min läsning
EU AI Act for SMEs: a practical governance plan
The EU AI Act is not just a legal problem for large vendors. A practical SME plan for inventory, risk classification, human oversight, transparency, vendor records, and rollout discipline.
Avancerad 10 min läsning
Mönster för privat AI-driftsättning: lokal, VPC, egen drift och hybrid
Privat AI är inte en enda arkitektur. En praktisk jämförelse av lokala modeller, SaaS för företag, drift i VPC, inferens i egen regi och hybridmönster för små och medelstora företag som värdesätter integritet och kontroll.
Avancerad 12 min läsning
Kostnadsoptimera inferens: promptcachning, routing och kontroll av utdata
Bygg en kostnadsmodell för inferens utifrån mätdata, optimera de största kostnadsposterna och visa att varje ändring bevarar kvaliteten i uppgiften.
Avancerad 10 min läsning
Utvärderingar för icke-utvecklare: ta reda på om ditt AI-arbetsflöde blir bättre eller sämre
En praktisk introduktion till att utvärdera ett AI-arbetsflöde med representativa exempel, uttryckliga bedömningskriterier, kvalificerade etiketter, lanseringsregler och ett kalkylblad när det räcker.
Mellannivå 12 min läsning
Utforma MCP-verktyg som LLM-modeller faktiskt använder rätt
De flesta MCP-verktyg vi ser är tekniskt korrekta men praktiskt oanvändbara. LLM-modeller ignorerar dem, använder dem fel eller anropar dem på olämpliga sätt. Här är principerna för att utforma verktyg som LLM-modeller tar till sig naturligt, med exempel på vanliga fel och hur de åtgärdas.
Avancerad 12 min läsning
Observerbarhet för LLM-appar: spårning, kostnader, svarstid och kvalitetsdrift
Utöka vanlig observerbarhet med flerstegsspår, hänförbar kostnad, prompt- och modellversioner, utvärderade kvalitetssignaler, integritetskontroller och aviseringar som härleds från arbetsbelastningen.
Avancerad 12 min läsning
Välj mellan promptning, RAG och finjustering (och när de bör kombineras)
Promptning, RAG och finjustering är de tre stora verktygen för att anpassa LLM-modeller till ditt problem. Var och en passar vissa problem och är fel för andra. Ett ramverk för valet, de realistiska kostnaderna och de produktionsmönster där kombinationer ger bäst resultat.
Avancerad 19 minuter
Är det här slutet för RAG? Anthropics NYA promptcachelagring
Prompt Engineering. Jämför Anthropics promptcachelagring med Geminis kontextcachelagring och visar konkreta minskningar av latens och kostnader per användningsfall (chatt med långa dokument, few-shot och konversationer i flera turer). Genomgången av pristillägget för att skriva till cachen jämfört med rabatten för att läsa från den är precis vad artikeln förutsätter när den beskriver när cachelagring lönar sig.
Avancerad 56 minuter
Build Hour: promptcachelagring
OpenAI. OpenAI:s egen Build Hour om promptcachelagring – tröskeln på 1024 token, kravet på stabila prefix, stora rabatter för cachelagring av ljud i realtid (kontrollera den aktuella prissidan för den exakta nivån) och påverkan på tiden till första token vid långa indata. Användbart när du bedömer den tekniska insats som faktiskt krävs för att träffa cachen tillförlitligt med dina produktionsprompter.
Avancerad 107 minuter
Därför är AI-utvärderingar den hetaste nya färdigheten för produktutvecklare | Hamel Husain och Shreya Shankar
Lenny's Podcast. Samtalet med Husain och Shankar kompletterar artikelns krav på en ansvarig och en granskningsfrekvens som följer förändringar, incidenter och observerade fel. Bedöm tidsåtgången för ditt eget arbetsflöde.
Mellannivå 3 minuter
Utvärdera prompter i Anthropic Console
Anthropic. En tre minuter lång genomgång från Anthropic av hur man kör en verklig utvärdering i Workbench – genererar automatiskt realistiska testfall, betygsätter resultat, finjusterar prompten och kör samma testsvit på nytt sida vid sida. Antalet visningar ligger under den vanliga gränsen, men för frågan ”hur gör jag faktiskt det här utan att skriva kod?” är det den tydligaste officiella demonstrationen och passar väl under det mer strategiska samtalet med Husain och Shankar.
Mellannivå 19 minuter
Bygg effektivare AI-agenter
Anthropic. Ingenjörer på Anthropic går igenom vad de faktiskt ändrade när deras system med flera agenter använde verktyg fel – slog samman slutpunkter, returnerade namn i stället för ID:n och använde MCP:er och Agent Skills i stället för att pressa in fler verktyg i systemprompten. Det motsvarar punkt för punkt artikelns checklista för verktygsbeskrivningar och utformning av returformat.
Avancerad 29 minuter
Promptning för agenter | Code w/ Claude
Anthropic. Hannah Moran och Jeremy Hadfield från Applied AI går igenom hur verktygsanrop och agentprompter ska formuleras i en verklig agent som spelar Pokémon – när beteende bör placeras i systemprompten respektive verktygsbeskrivningen och vad modellen behöver veta om varje verktygs förvillkor. Omedelbart användbar när du har skrivit din första MCP-server och upptäcker att Claude anropar den på oväntade sätt.
Avancerad 9 minuter
LangSmith på 10 minuter
LangChain. En av LangChains medgrundare ger en guidad rundtur i ett LLM-spår, ett projekt och en datamängd – tokenkostnad, latens, felfrekvens, aggregering av återkoppling och fördjupning i ett enskilt spann för ett hämtningssteg. Det är den närmaste visuella motsvarigheten till det artikeln beskriver med ”varje anrop är ett spann” och varför strukturerade spår är bättre än loggning med utskrifter.
Avancerad 154 minuter
Instrumentering och utvärdering av LLM:er
Hamel Husain. Hamel Husain, Eugene Yan, Brian Bischof, Harrison Chase och Shreya Shankar arbetar med spårning, logganalys, LLM som bedömare och arbetsflödet för att granska verkliga produktionsdata. Ge den samma uppmärksamhet som en lång podd. Det är den bästa enskilda djupgående genomgången på YouTube av artikelns tes ”titta på dina spår”.
Avancerad 9 minuter
RAG kontra finjustering
IBM Technology. Ett mer avgränsat fokus på de två tekniker som team oftast blandar ihop. Videon går djupare in på datas aktualitet, källhänvisningar och argumentet att finjustering kan ge snabbare inferens. Den är värd att se om du specifikt försöker argumentera mot ett onödigt finjusteringsprojekt.
Avancerad 13 minuter
RAG kontra finjustering kontra promptutformning: optimera AI-modeller
IBM Technology. En tydlig whiteboardgenomgång av alla tre teknikerna och deras respektive kostnader: latens vid informationshämtning, beräkningskostnaden för träning och katastrofal glömska samt begränsningarna med lösningar som enbart bygger på prompter. Den tar också upp de kombinationer som faktiskt är rimliga i produktion. Det avslutande exemplet, där ett juridiskt AI-system använder alla tre teknikerna, motsvarar nästan exakt artikelns argument om när de bör kombineras.
Avancerad 8 minuter
Whartonprofessor: 4 scenarier för AI:s framtid | Ethan Mollick för Big Think+
Big Think. En koncentrerad 8-minutersversion av Mollicks modell med ”fyra scenarier” – statisk, linjär, exponentiell, AGI – och varför team bör planera utifrån scenario två eller tre i stället för att satsa allt på någon av ytterligheterna. Användbar när du försöker få en ledningsgrupp att enas om vad den faktiskt förbereder sig för innan du skriver handboken.
Mellannivå 60 minuter
Varje ledare behöver den här AI-strategin | Ethan Mollick förklarar
Sana. En timme med Mollick om hur AI i organisationer faktiskt ser ut – varför ”sänk kostnaderna” är fel inramning, varför traditionella organisationsscheman håller på att förändras och vad AI-baserade team gör annorlunda. Den ligger under den vanliga gränsen på 100k, men är det tydligaste samtalet på praktikernivå om implementeringsstrategi med den forskare som mest konsekvent citeras inom ämnet. Frågorna i artikelns handbok motsvarar hans inramning nästan 1:1.
Mellannivå