

L’IA pour l’entreprise
Systèmes d’IA destinés aux entreprises, choix d’adoption, parcours clients et résultats mesurables.
58 contenus (25 articles · 33 vidéos)
Commencez ici
Quelques bons contenus pour débuter avant de parcourir l’ensemble du flux.
 11 min de lecture
Concevoir un guide d’adoption de l’IA pour une équipe
Un guide pratique pour adopter l’IA : choisir des cas d’usage bien délimités, associer le personnel concerné, fixer les règles relatives aux données et aux décisions, former sur des tâches réelles et mesurer les effets par rapport à une situation de référence.
Intermédiaire 9 min de lecture
ROI et maturité en IA : mesurer une adoption réellement efficace
L’adoption de l’IA ne se mesure pas au nombre de personnes qui ont essayé ChatGPT. Voici un cadre concret pour mesurer le ROI des flux de travail, la qualité, les risques, la maturité et la capacité de déploiement à grande échelle.
Avancé 9 min de lecture
Développer ou acheter un système d’IA : un cadre de décision concret
Comparez l’achat, la configuration, l’extension, le développement sur mesure et l’auto-hébergement selon les mêmes exigences, critères éliminatoires, essai représentatif et modèle de coût total.
AvancéPlus de contenus sur ce thème
 9 min de lecture
DGX Spark : ce que c’est, à qui il s’adresse et ce qu’il change pour les agents exécutés localement
Une analyse factuelle du NVIDIA DGX Spark : caractéristiques du Grace Blackwell GB10 publiées par NVIDIA, mémoire unifiée cohérente, interconnexion de plusieurs systèmes par ConnectX-7 et situations où une machine de bureau dédiée aux agents constitue un choix pertinent pour l’IA privée.
Avancé 12 min de lecture
Faire de Codex, Claude Code et Cursor une seule équipe en ligne de commande
Utilisez AGENTS.md, CLAUDE.md, les règles de Cursor et les modes non interactifs des CLI pour confier la conception à Codex, la revue à Claude et l’implémentation à Cursor, sans plateforme d’orchestration sur mesure.
Avancé 15 min de lecture
Gérer un projet multi-agents avec Linear : Claude, Cursor et Codex sur un même backlog
Faites travailler Claude Code, Cursor et Codex sur un même projet Linear comme une véritable équipe d’ingénierie : prise en charge des tâches, suivi de l’avancement, transmission pour revue, correction des constats et clôture des tickets sans conflits.
Avancé 8 min de lecture
La dignité au travail quand les machines peuvent en accomplir davantage
Une évaluation pratique de la transformation des postes pour les dirigeants de PME : examinez la participation des salariés, leur pouvoir de jugement, les parcours de compétences, la charge de travail, la surveillance et les voies de recours avant de déclarer une automatisation réussie.
Intermédiaire 8 min de lecture
Que dire à votre équipe lorsque vous automatisez une partie de son travail
Une séquence de communication pratique pour les projets d’automatisation : que dire avant que la décision ne se fige, quels engagements créent la confiance et quelles promesses les responsables ne doivent pas faire.
Intermédiaire 32 minutes
Comment créer des flux de travail d’IA centrés sur l’humain dans la localisation avec Shashi Bhushan
Crowdin. Shashi Bhushan commence par cartographier le flux de travail plutôt que par sélectionner des outils, puis aborde la qualité du texte source, la vérification humaine, la relecture par l’IA, les contrôles de glossaire, la participation de l’équipe produit, les projets pilotes et les contraintes de confidentialité. Cela correspond presque exactement au modèle opérationnel recommandé dans l’article pour les équipes estoniennes qui travaillent en estonien, en anglais, en russe, en finnois et avec la terminologie propre à leurs clients.
Intermédiaire 4 minutes
Présentation d’EmbeddingGemma : le modèle ouvert de référence pour les plongements vectoriels sur appareil
Google for Developers. La vidéo présente des plongements vectoriels de textes multilingues capables de s’exécuter localement et de prendre en charge la recherche sémantique et le RAG sans envoyer chaque document à une API hébergée. Pour les entreprises estoniennes, c’est un complément technique utile au modèle de recherche dans les connaissances internes présenté dans l’article : la récupération multilingue n’a de valeur que si elle respecte aussi la localisation des données, les autorisations et l’autorité des sources.
Intermédiaire 17 minutes
Le PDG de Conductor, Charlie Holtz, nous montre sa configuration de codage basée sur l'IA
Y Combinator. Il s'agit d'une démonstration concrète par un ingénieur senior, et non d'une table ronde. Holtz compare Claude Code et Codex, coordonne plusieurs agents de développement en parallèle et définit des « zones sans code bâclé » où aucun code généré ne peut être intégré sans revue. Sa configuration incarne les principes de l'article : fournir le contexte du dépôt, produire de petits correctifs faciles à examiner et laisser à l'humain la responsabilité de l'architecture pendant que les agents écrivent le code.
Avancé 56 minutes
Agents d'IA dans la finance avec le CFO d'HPE
CXOTalk. Marie Myers, directrice financière de HPE, décrit le déploiement de l'IA agentique — leur plateforme « Alfred » — dans une organisation financière de 3 600 personnes. Elle applique la discipline défendue dans l'article : distinction entre ROI direct et indirect, étapes de validation qui déterminent la poursuite ou l'arrêt de chaque cas d'usage, contrôle qualité obligatoire avec intervention humaine et indicateurs propres au workflow. Elle cite notamment un processus de revue hebdomadaire dont l'effort manuel a diminué d'environ 90 %. L'adoption se mesure par la transformation du travail, pas par le nombre de connexions à un outil.
Avancé 41 minutes
IA privée vs. cloud : comment les dirigeants d'entreprise peuvent prendre des décisions plus intelligentes sur le choix entre construire ou acheter
World Wide Technology. Elle relie le choix entre développement et achat aux objectifs métier, au placement des charges de travail, à l'économie du cloud, à la souveraineté des données, à la sécurité, à la maturité de l'infrastructure et aux modèles d'exploitation hybrides. Elle aide ainsi à décider s'il faut acheter un outil, étendre une plateforme, développer une fine couche sur mesure ou prendre en charge une plus grande partie de l'infrastructure de déploiement.
Avancé 10 min de lecture
Flux de travail d’IA multilingues pour les entreprises estoniennes
Un modèle pratique de flux de travail pour les entreprises estoniennes qui utilisent l’estonien, l’anglais, le russe, le finnois et d’autres langues de leurs clients, sans compromettre le ton, la terminologie, la confidentialité ni la responsabilité.
Intermédiaire 9 min de lecture
IDE natifs de l'IA et processus de développement tenant compte du dépôt
Cursor, Copilot, Claude Code et les agents qui comprennent le dépôt ne transforment le développement logiciel que si les équipes leur imposent des limites. Voici un processus concret couvrant le contexte du code, la planification, les tests, la revue, les secrets et la sécurité en production.
Avancé 9 min de lecture
Règlement européen sur l’IA : un plan de gouvernance concret pour les PME
Le règlement européen sur l’IA n’est pas seulement une question juridique pour les grands fournisseurs. Voici un plan concret pour les PME : inventaire, classification des risques, supervision humaine, transparence, documentation des fournisseurs et discipline de déploiement.
Avancé 10 min de lecture
Modes de déploiement de l’IA privée : local, VPC, auto-hébergé et hybride
L’IA privée ne se résume pas à une seule architecture. Cette comparaison concrète couvre les modèles locaux, le SaaS d’entreprise, les déploiements dans un VPC, l’inférence auto-hébergée et les architectures hybrides pour les PME soucieuses de la confidentialité et du contrôle.
Avancé 10 min de lecture
La stack marketing IA : contenu, SEO et réseaux sociaux avec validation humaine
Des processus marketing à évaluer pour la recherche autorisée, la rédaction étayée par des sources, le contrôle SEO, l’adaptation, l’approbation humaine avant publication et la mesure des résultats, avec une vérification juridique propre à chaque pays avant lancement.
Intermédiaire 11 min de lecture
La stack commerciale IA : enrichissement des prospects, personnalisation et relances à grande échelle
Une stack commerciale IA concrète pour la recherche, la personnalisation, les séquences et les relances, sans produire les messages indésirables que tout le monde supprime. L’architecture, les outils, les prompts et les garde-fous qui séparent une prospection utile d’une prospection importune.
Intermédiaire 12 min de lecture
Optimiser les coûts d’inférence : cache des prompts, routage et contrôle des sorties
Élaborez un modèle des coûts d’inférence à partir des traces, optimisez les postes mesurés les plus importants et démontrez que chaque modification préserve la qualité de la tâche.
Avancé 10 min de lecture
Évaluations pour les non-ingénieurs : savoir si votre flux de travail d’IA s’améliore ou se dégrade
Les évaluations — la mesure systématique de la qualité des productions de l’IA — sont généralement considérées comme un sujet réservé à l’ingénierie. Pourtant, toute équipe qui utilise des flux de travail d’IA en a besoin, et leurs principes fondamentaux sont accessibles sans écrire de code.
Intermédiaire 13 min de lecture
Créer des évaluations qui détectent vraiment les régressions
La plupart des suites d’évaluation semblent impressionnantes, mais ne détectent pas les régressions réelles. Des évaluations pertinentes exigent des jeux de données soigneusement construits, des métriques sensibles, des juges étalonnés et une culture de confiance. Voici les pratiques des équipes qui maîtrisent cette discipline.
Avancé 14 min de lecture
MCP à partir de zéro : créer un serveur de production en TypeScript
Créer un serveur Model Context Protocol (MCP) de production exige davantage que de relier quelques outils. Voici les schémas de conception, l’authentification, la gestion des erreurs, la diffusion continue, l’observabilité et les réalités opérationnelles qui rendent un serveur MCP utile à grande échelle.
Avancé 12 min de lecture
Concevoir des outils MCP que les LLM utilisent réellement correctement
La plupart des outils MCP que nous rencontrons sont techniquement corrects, mais pratiquement inutiles. Les LLM les ignorent, les utilisent mal ou les appellent sans discernement. Voici les principes permettant de concevoir des outils qu’ils adoptent naturellement, avec des exemples d’erreurs courantes et leurs corrections.
Avancé 12 min de lecture
Observabilité des applications LLM : traçage, coûts, latence et dérive de la qualité
Étendez l’observabilité standard par des traces multi-étapes, un coût attribuable, les versions de prompt et de modèle, des signaux de qualité évalués, des contrôles de confidentialité et des alertes dérivées de la charge.
Avancé 12 min de lecture
Construire un RAG de production : ingestion, embeddings, recherche, reclassement et évaluation
Un pipeline RAG de production comporte six étapes, chacune régie par des principes qui déterminent la qualité. Voici l’architecture, les choix propres à chaque étape et la discipline d’évaluation itérative qui distinguent un RAG efficace d’un système décevant.
Avancé 12 min de lecture
Choisir entre le prompting, le RAG et le fine-tuning (et quand les combiner)
Le prompting, le RAG et le fine-tuning sont les trois principaux leviers permettant d’adapter un LLM à votre problème. Chacun convient à certaines situations et non à d’autres. Voici un cadre de décision, leurs coûts réels et les architectures de production où leur combinaison excelle.
Avancé 12 min de lecture
RAG au-delà des segments : graph RAG, RAG agentique et RAG à contexte long
Le RAG classique fondé sur des segments présente des limites. Le graph RAG, le RAG agentique et le RAG à contexte long les dépassent chacun différemment. Voici quand choisir chaque approche, comment elle fonctionne réellement et quels compromis importent en production.
Avancé 13 min de lecture
Économie unitaire d’un produit LLM : une feuille de calcul tarifaire vérifiable
Ventilez l’usage des modèles, la marge contributive, le coût des échecs, l’assistance et la fidélisation avant de fixer un prix. Cette feuille de calcul remplace les fourchettes de marché non étayées par des données vérifiées.
Avancé 13 min de lecture
Sorties structurées et appels de fonctions : les schémas adaptés à la production
Les sorties structurées et les appels de fonctions permettent de passer d’un « LLM qui génère du texte » à un « système qui exécute des tâches ». En production, les schémas, la gestion des erreurs, l’idempotence et la dégradation progressive comptent davantage que le seul mode JSON.
Avancé 24 minutes
J’ai créé un agent de contenu avec n8n et Claude (étape par étape)
Greg Isenberg. Avec The Boring Marketer, Isenberg construit dans n8n un véritable pipeline de contenu : collecte des publications les plus performantes sur YouTube et X, rédaction de nouveaux contenus avec Claude, recherche avec Perplexity, génération d’images et publication sur LinkedIn après une étape de validation humaine. C’est exactement la structure « un agent au centre, des outils de part et d’autre » décrite dans l’article, et la validation humaine est montrée plutôt que simplement mentionnée.
Intermédiaire 30 minutes
Je révèle tous les secrets du vibe marketing, sans rien cacher
Greg Isenberg. Cette présentation plus large de l’écosystème marketing actuel fondé sur l’IA couvre l’automatisation des flux de travail, le routage des modèles, les outils d’IA pour la vidéo et la voix, ainsi que la création d’annonces à partir de l’analyse des concurrents. Elle permet de comprendre le rôle de chaque catégorie d’outils avant de décider où placer les trois premiers Zaps ou flux n8n de votre équipe.
Intermédiaire 26 minutes
Création en direct d’un agent commercial d’IA qui appelle les prospects
Liam Ottley. Cette réalisation en direct crée un agent vocal d’IA qui appelle les prospects entrants, les qualifie et tente de programmer un appel de découverte — Make.com associé à un fournisseur de services vocaux, avec le script de qualification et la logique de transfert visibles. Elle complète bien le volet e-mail : même schéma d’enrichissement puis de personnalisation, mais canal et modes de défaillance différents.
Intermédiaire 30 minutes
J’ai hyperpersonnalisé 1000+ e-mails de prospection avec ce système d’IA (modèle gratuit)
Nick Saraev. Saraev construit exactement le pipeline décrit dans l’article — Apollo pour les prospects, Apify pour l’extraction, n8n pour enrichir les données et produire une accroche de plusieurs lignes à partir du site de chaque prospect, puis Instantly pour l’envoi — et expose franchement le coût par prospect et les taux de réponse. C’est la démonstration la plus claire d’une « véritable personnalisation à grande échelle », pas d’un simple « publipostage avec un prénom ».
Intermédiaire 19 minutes
Est-ce la fin de la RAG ? La nouvelle mise en cache des prompts d'Anthropic
Prompt Engineering. Elle compare la mise en cache des prompts d'Anthropic à celle du contexte chez Gemini, en chiffrant les gains de latence et de coût selon le cas d'usage : conversation sur de longs documents, apprentissage à partir de quelques exemples et échanges en plusieurs tours. La comparaison entre le surcoût d'écriture du cache et l'économie réalisée à la lecture correspond exactement au calcul de rentabilité présenté dans l'article.
Avancé 56 minutes
Build Hour : Mise en cache des prompts
OpenAI. Cette session officielle d'OpenAI détaille le seuil de 1 024 tokens, l'exigence de stabilité du préfixe, les fortes remises liées à la mise en cache audio en temps réel — consultez la page tarifaire actuelle pour connaître le taux exact — et l'effet des longues entrées sur le délai avant le premier token. Elle aide à estimer l'effort technique nécessaire pour exploiter le cache de façon fiable avec vos prompts de production.
Avancé 107 minutes
Pourquoi les évaluations d’IA sont la nouvelle compétence incontournable des concepteurs de produits | Hamel Husain et Shreya Shankar
Lenny's Podcast. Hamel Husain et Shreya Shankar parcourent l’intégralité du flux de travail d’évaluation sur un véritable assistant d’IA de gestion locative — examen des traces, codage ouvert et axial des erreurs, décision du moment où s’arrêter, création d’un LLM utilisé comme juge et validation par rapport au jugement humain. Ce rare entretien approfondi s’adresse réellement aux chefs de produit et aux responsables d’équipe, plutôt qu’aux ingénieurs en apprentissage automatique. Il reprend le rythme recommandé dans l’article : « 30 minutes par semaine après la configuration ».
Intermédiaire 3 minutes
Évaluer des prompts dans la console Anthropic
Anthropic. Cette présentation de trois minutes par Anthropic montre une véritable évaluation dans le Workbench — génération automatique de cas de test réalistes, notation des résultats, ajustement du prompt et nouvelle exécution de la même suite pour une comparaison côte à côte. Le nombre de vues reste sous notre seuil habituel, mais, pour répondre à la question « comment faire concrètement sans écrire de code ? », c’est la démonstration officielle la plus claire. Elle complète parfaitement l’entretien plus stratégique de Husain et Shankar.
Intermédiaire 55 minutes
Comment mettre systématiquement en place des évaluations de LLM (métriques, tests unitaires, LLM utilisé comme juge)
Dave Ebbelaar. Un ingénieur en IA présente l’échelle d’évaluation qu’il utilise réellement — tests unitaires fondés sur des assertions, métriques sans référence, calibration du LLM utilisé comme juge par rapport aux humains, puis boucle analyser-mesurer-améliorer. Parmi les vidéos disponibles, cette structure correspond le mieux à l’argument de l’article : les évaluations forment un système de détection des régressions, pas un classement.
Avancé 19 minutes
Comment construire des systèmes d'évaluation LLM spécifiques à un domaine : Hamel Husain et Emil Sedgh
AI Engineer. Hamel Husain et le directeur technique de Rechat présentent le système d’évaluation d’un véritable produit d’IA : les raisons de l’échec des évaluations génériques prêtes à l’emploi, une architecture en couches d’assertions, des traces journalisées soumises à une validation humaine, des LLM utilisés comme juges et maintenus en accord avec un expert du domaine, ainsi que la façon dont un système d’évaluation opérationnel rend possibles la curation des données et l’ajustement fin. C’est l’étude de cas en production qui étaye l’argument de l’article : les évaluations sont un dispositif de détection des régressions, pas un classement.
Avancé 104 minutes
Créer des agents avec Model Context Protocol — atelier complet avec Mahesh Murag d’Anthropic
AI Engineer. Mahesh Murag d’Anthropic présente la conception de MCP — pourquoi les outils, les ressources et les prompts sont séparés, comment les clients négocient les capacités et ce que les hôtes de production font réellement du protocole. Regardez cette vidéo après la réalisation pratique pour comprendre les parties de MCP que le SDK masque discrètement et confronter la liste de contrôle « prêt pour la production » de l’article à l’intention des auteurs de la spécification.
Avancé 75 minutes
La formation accélérée ultime à MCP : construire à partir de zéro
Web Dev Simplified. La vidéo construit intégralement, code à l’appui, un serveur et un client MCP en TypeScript — définitions d’outils, schémas, prompts, ressources, transport stdio et débogage dans l’inspecteur. C’est sur YouTube la vidéo qui se rapproche le plus du travail demandé dans l’article, à un rythme qui permet de faire une pause et de reproduire chaque étape dans votre propre éditeur.
Avancé 19 minutes
Créer des agents d'IA plus efficaces
Anthropic. Les ingénieurs d’Anthropic expliquent les changements réellement apportés lorsque leurs systèmes multi-agents utilisaient mal les outils — regroupement de plusieurs endpoints, renvoi de noms plutôt que d’identifiants, recours à MCP et aux Agent Skills plutôt qu’accumulation d’outils dans le prompt système. Cela correspond point par point à la liste de contrôle de l’article pour les descriptions d’outils et la conception des valeurs renvoyées.
Avancé 29 minutes
Rédiger des prompts pour les agents | Code w/ Claude
Anthropic. Hannah Moran et Jeremy Hadfield, de l’équipe Applied AI, montrent comment formuler les appels d’outils et les prompts d’agents à partir d’un agent qui joue à Pokémon — quand placer un comportement dans le prompt système plutôt que dans la description de l’outil, et ce que le modèle doit savoir des préconditions de chaque outil. La vidéo devient immédiatement utile après la création de votre premier serveur MCP, lorsque Claude commence à l’appeler de façon inattendue.
Avancé 9 minutes
LangSmith en 10 minutes
LangChain. Le cofondateur de LangChain propose une visite guidée d’une trace LLM, d’un projet et d’un jeu de données — coût des tokens, latence, taux d’erreur, agrégation des retours et exploration du span d’une seule étape de récupération. C’est l’équivalent visuel le plus proche de ce que décrit l’article lorsqu’il affirme que « chaque appel est un span » et explique pourquoi les traces structurées sont supérieures aux simples journaux produits par des instructions d’affichage.
Avancé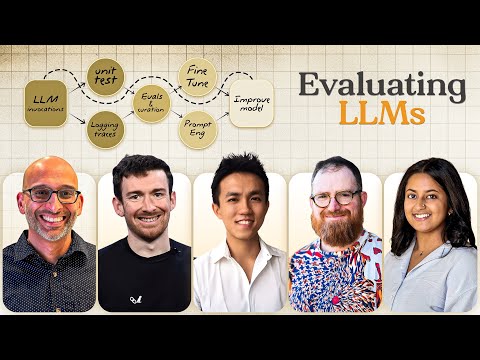 154 minutes
Instrumentation et évaluation des LLM
Hamel Husain. Hamel Husain, Eugene Yan, Brian Bischof, Harrison Chase et Shreya Shankar travaillent sur le traçage, l’analyse des journaux, les LLM utilisés comme juges et le flux d’examen de véritables données de production. Consacrez à cette vidéo la même attention qu’à un long podcast : c’est sur YouTube l’analyse la plus approfondie de la thèse « examinez vos traces » défendue dans l’article.
Avancé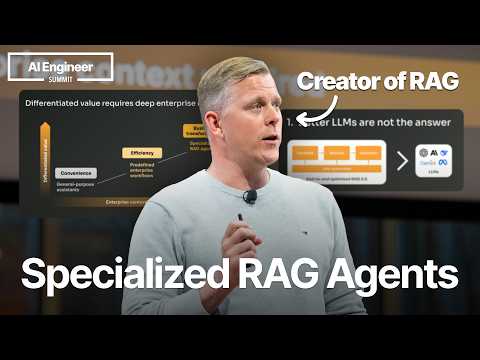 17 minutes
Agents RAG en production : dix leçons tirées du terrain — Douwe Kiela, créateur du RAG
AI Engineer. Douwe Kiela a dirigé l’article scientifique fondateur du RAG chez FAIR et déploie désormais le RAG dans des entreprises réglementées. La conférence porte surtout sur ce qui cesse de fonctionner à grande échelle — stratégies de segmentation qui ne résistent pas à 100 000 documents, constat selon lequel « l’exactitude est le minimum attendu ; l’inexactitude est le véritable problème », et importance supérieure de l’attribution et de l’observabilité par rapport au modèle d’embedding. Elle offre un bon étalonnage avant de relire les sections de l’article sur l’évaluation et la surveillance.
Avancé 19 minutes
Créer des applications RAG prêtes pour la production : Jerry Liu
AI Engineer. Le PDG de LlamaIndex explique l’écart entre une démonstration naïve du RAG et un véritable pipeline — récupération de petits segments vers de grands contextes, routage des sous-questions, recherche hybride et évaluation. La structure de ses diapositives correspond presque directement aux sections du pipeline de l’article ; regardez la vidéo d’abord, puis relisez l’article avec ses schémas en tête.
Avancé 9 minutes
RAG ou fine-tuning
IBM Technology. Cette vidéo se concentre sur les deux techniques que les équipes confondent le plus souvent. Elle approfondit la fraîcheur des données, l’attribution des sources et l’avantage de vitesse à l’inférence que peut apporter le fine-tuning. Elle mérite d’être regardée si vous cherchez précisément à déconseiller un projet de fine-tuning inutile.
Avancé 13 minutes
RAG, fine-tuning ou ingénierie des prompts : optimiser les modèles d’IA
IBM Technology. Cette présentation claire au tableau blanc compare les trois techniques et leurs coûts respectifs — latence de récupération, calcul nécessaire à l’entraînement, oubli catastrophique et limites des solutions fondées uniquement sur les prompts — ainsi que les combinaisons réellement pertinentes en production. L’exemple final d’un système d’IA juridique utilisant les trois correspond presque exactement à l’argument « quand les combiner » de l’article.
Avancé 39 minutes
Présentation du RAG 2.0 : RAG agentique et graphes de connaissances (modèle gratuit)
Cole Medin. Cette réalisation fonctionnelle associe RAG agentique et graphe de connaissances ; l’agent décide quand effectuer une recherche vectorielle, quand interroger Neo4j et quand combiner les deux. C’est sur YouTube la démonstration la plus claire du schéma « l’agent comme planificateur de la récupération » décrit dans l’article, avec un code que vous pouvez télécharger et exécuter.
Avancé 16 minutes
Graph RAG : améliorer le RAG avec des graphes de connaissances
Prompt Engineering. Cette présentation ciblée de GraphRAG par Microsoft couvre l’extraction d’entités, les résumés de communautés et la synthèse ciblée par requête, avec une installation sur machine locale et des indications de coût. Regardez-la spécialement pour la section de l’article consacrée au graph RAG ; la discussion des coûts est précisément ce que la plupart des présentations écrites omettent.
Avancé 42 minutes
Les agents IA verticaux pourraient être 10 fois plus importants que le SaaS
Y Combinator. Les animateurs de Lightcone expliquent pourquoi les agents d'IA verticaux — plutôt que de simples interfaces horizontales autour d'un modèle — offrent une forme plus défendable aux entreprises applicatives. Des exemples concrets éclairent les catégories que les fournisseurs de modèles risquent d'intégrer eux-mêmes. C'est la version constructive du piège lié à l'absence de barrière concurrentielle décrit dans l'article.
Avancé 34 minutes
Comment l'IA réinvente les modèles économiques logiciels ft. Bret Taylor de Sierra
Sequoia Capital. Bret Taylor décrit le passage d'un SaaS facturé par utilisateur à une tarification fondée sur les résultats : quels indicateurs choisir — résolution, CSAT, NPS —, pourquoi les acteurs établis peinent à s'adapter et comment la spécialisation verticale renforce le pouvoir de fixation des prix. Cette analyse reflète directement les sections de l'article consacrées à la tarification et aux marges.
Avancé 41 minutes
OpenAI DevDay 2024 | Sorties structurées pour des applications fiables
OpenAI. La vidéo présente `strict: true`, sa différence par rapport à l’ancien mode JSON, le traitement des refus et la manière dont les appels de fonctions s’articulent avec les schémas de format de réponse. Elle est particulièrement utile parce qu’elle décrit le contrat fourni par l’API, sur lequel reposent les schémas de production de l’article.
Avancé 18 minutes
Pydantic est tout ce dont vous avez besoin : Jason Liu
AI Engineer. Cette présentation a cristallisé le modèle moderne « définir un modèle Pydantic, le transmettre au LLM et laisser la validation faire le reste ». Elle donne des exemples concrets d’objets imbriqués, de validateurs qui détectent les URL hallucinées et de chaîne de pensée représentée par un champ typé. Regardez-la avant de relire la section de l’article sur les validateurs : vous reconnaîtrez l’origine de ses règles de nouvelle tentative et de refus.
Avancé 8 minutes
Professeur à Wharton : 4 scénarios pour l’avenir de l’IA | Ethan Mollick pour Big Think+
Big Think. Cette présentation concise de 8 minutes résume le modèle des « quatre scénarios » de Mollick — statique, linéaire, exponentiel et AGI — et explique pourquoi les équipes devraient préparer le deuxième ou le troisième scénario plutôt que de tout miser sur l’un des deux extrêmes. Elle est utile lorsqu’une équipe de direction doit s’accorder sur ce à quoi elle se prépare avant de rédiger le guide.
Intermédiaire 60 minutes
Chaque leader a besoin de cette stratégie en matière d'IA | Ethan Mollick explique
Sana. Pendant une heure, Mollick décrit la réalité de l’IA dans les organisations — pourquoi « réduire les coûts » est un mauvais cadre, comment les structures organisationnelles traditionnelles évoluent et ce que font différemment les équipes conçues autour de l’IA. La vidéo reste sous notre seuil habituel de 100k vues, mais c’est la discussion destinée aux praticiens la plus claire sur la stratégie d’adoption, avec le chercheur le plus régulièrement cité sur ce sujet. Les thèmes du guide présenté dans l’article recoupent presque 1:1 son approche.
Intermédiaire