

AI for Business
Business-facing AI systems, adoption choices, customer workflows, and measurable outcomes.
58 historier (25 artikler · 33 videoer)
Start her
Et par gode steder at begynde, før du går på opdagelse i hele oversigten.
 11 min læsning
Udform en plan for teamets indførelse af AI
En praktisk plan for indførelse af AI: Vælg afgrænsede anvendelser, inddrag berørte medarbejdere, fastlæg regler for data og beslutninger, træn med reelt arbejde, og mål effekten i forhold til en nulmåling.
Let øvet 9 min læsning
AI-ROI og modenhed: sådan måler du en AI-indførelse, der faktisk virker
Indførelsen af AI bør ikke måles på, hvor mange der har prøvet ChatGPT. En praktisk model til måling af arbejdsgangens ROI, kvalitet, risiko, modenhed og skaleringsparathed.
Avanceret 9 min læsning
Byg eller køb AI-systemer: den praktiske beslutningsramme
Sammenlign køb, konfiguration, udvidelse, egenudvikling og selvhosting ud fra de samme krav og vetokriterier, den samme repræsentative prøve og den samme samlede omkostningsmodel.
AvanceretFlere i dette emne
 9 min læsning
DGX Spark: hvad det er, hvem det er til, og hvad der ændrede sig for lokale agenter
En nøgtern gennemgang af NVIDIA DGX Spark: NVIDIAs specifikationer for Grace Blackwell GB10, kohærent samlet hukommelse, klyngedannelse med ConnectX-7, og hvornår en lokal agentcomputer er et fornuftigt valg til privat AI.
Avanceret 12 min læsning
Få Codex, Claude Code og Cursor til at arbejde som ét team via CLI
Brug AGENTS.md, CLAUDE.md, Cursor-regler og CLI'ernes udskriftstilstande, så Codex designer, Claude gennemgår, og Cursor implementerer uden en specialbygget orkestreringsplatform.
Avanceret 15 min læsning
Projektledelse med flere AI-agenter i Linear: Claude, Cursor og Codex i én fælles backlog
Lad Claude Code, Cursor og Codex arbejde på det samme Linear-projekt som et rigtigt udviklingsteam: tag ejerskab over opgaver, registrér fremdrift, overdrag til gennemgang, ret fund og afslut opgaver uden at overskrive hinandens arbejde.
Avanceret 8 min læsning
Værdighed i arbejdet, når maskiner kan udføre mere af det
En praktisk vurdering af jobomlægning for SMV-ledere: Undersøg medarbejderindflydelse, bevaret dømmekraft, udviklingsmuligheder, arbejdsbelastning, overvågning og klageadgang, før I erklærer en automatisering for en succes.
Let øvet 8 min læsning
Hvad du skal sige til dit team, når du automatiserer en del af deres arbejde
En praktisk rækkefølge for kommunikationen om automatiseringsprojekter: Hvad du skal sige, før beslutningen ligger fast, hvilke tilsagn der opbygger tillid, og hvilke løfter ledere ikke bør give.
Let øvet 32 minutter
Sådan bygger du menneskecentrerede AI-arbejdsgange i lokalisering med Shashi Bhushan
Crowdin. Shashi Bhushan starter med arbejdsgangskortlægning snarere end værktøjsvalg og dækker derefter kilde-tekstkvalitet, menneskelig gennemgang, AI-proofreading, glossary-tjek, produktteam-involvering, pilots og databeskyttelsesbegrænsninger. Det er næsten præcis den driftsmodel, artiklen anbefaler til estiske teams, der arbejder på tværs af estisk, engelsk, russisk, finsk og kundespecifik terminologi.
Let øvet 4 minutter
Vi præsenterer EmbeddingGemma: den førende open model til embeddings på enheden
Google for Developers. Videoen introducerer flersprogede tekstembeddings, der kan køre lokalt og understøtte semantisk søgning og RAG uden at sende hvert dokument til et hostet API. For estiske virksomheder er det et nyttigt teknisk komplement til artiklens mønster for intern videnssøgning: flersproget retrieval er kun værdifuld, når den også respekterer datalokalitet, tilladelser og kildeautoritet.
Let øvet 17 minutter
Conductor-CEO Charlie Holtz viser sin AI-kodemiljøopsætning
Y Combinator. En konkret senior-engineering-gennemgang frem for et panel: Holtz sammenligner Claude Code og Codex, orkestrerer flere coding agents parallelt og markerer "slop-free zones", hvor genereret kode ikke må lande uden review. Setuppet omsætter artiklens regler — repository-kontekst, små reviewbare patches, og at mennesket forbliver arkitekt, mens agenterne taster.
Avanceret 56 minutter
AI-agenter i finans med HPE's CFO
CXOTalk. HPE CFO Marie Myers beskriver udrulning af agentisk AI (deres "Alfred"-platform) på tværs af en finance-organisation med 3.600 personer med den disciplin, artiklen argumenterer for: en direkte-kontra-indirekte ROI-ramme, stage gates, der afgør, om hvert use case fortsætter eller stopper, obligatoriske kvalitetskontroller med menneskelig kontrol i processen, og arbejdsgangsmetrics såsom en ugentlig review-proces, der mister omtrent 90 % af sin manuelle indsats. Adoption måles som ændret arbejde, ikke tool-logins.
Avanceret 41 minutter
Privat AI vs. cloud: sådan kan virksomhedsledere træffe smartere build-or-buy-beslutninger
World Wide Technology. Forbinder byg-eller-køb-valg med forretningsoutcomes, workload-placering, cloud-økonomi, datasouverænitet, sikkerhed, infrastrukturparathed og hybride driftsmodeller. Det gør den til en nyttig strategisk ledsager, når du skal beslutte, hvornår du skal købe et værktøj, udvide en platform, bygge et tyndt custom-lag eller eje mere af deployment-stakken.
Avanceret 10 min læsning
Flersprogede AI-arbejdsgange til estiske virksomheder
En praktisk arbejdsgangsmodel til estiske virksomheder, der arbejder på estnisk, engelsk, russisk, finsk og andre kundesprog uden at miste tone, terminologi, databeskyttelse eller ansvar.
Let øvet 9 min læsning
AI-native IDE'er og repository-bevidste udviklingsworkflows
Cursor, Copilot, Claude Code og repository-bevidste agenter ændrer kun softwarearbejdet, når teams sætter grænser. Et praktisk workflow for kodebasekontekst, planlægning, test, review, secrets og produktionssikkerhed.
Avanceret 9 min læsning
EU's AI-forordning for SMV'er: en praktisk styringsplan
EU's AI-forordning er ikke kun et juridisk problem for store udbydere. En praktisk SMV-plan for register, risikoklassificering, menneskeligt tilsyn, gennemsigtighed, dokumentation fra leverandører og disciplin ved udrulning.
Avanceret 10 min læsning
Udrulningsmønstre for privat AI: lokalt, i VPC, selvhostet eller hybrid
Privat AI er ikke én enkelt arkitektur. En praktisk sammenligning af lokale modeller, SaaS til virksomheder, VPC-udrulninger, selvhostet inferens og hybride mønstre for SMV'er, der prioriterer databeskyttelse og kontrol.
Avanceret 10 min læsning
AI-marketingstacken: indhold, SEO og sociale medier med menneskelig gennemgang
Mulige arbejdsgange til AI-assisteret markedsføring: tilladt research, kildebaserede udkast, SEO-gennemgang, tilpasning, menneskelig godkendelse før publicering og målbare resultater med juridisk kontrol i den relevante jurisdiktion før lancering.
Let øvet 11 min læsning
AI-salgsstacken: leadberigelse, personalisering og opfølgning i stor skala
En praktisk AI-salgsstack til research, personalisering, kontaktforløb og opfølgning uden at ende som den spam, alle sletter. Arkitekturen, værktøjerne, prompts og kontrolforanstaltninger, der skelner mellem relevant og generende kontakt.
Let øvet 12 min læsning
Optimer inferensomkostninger: cachelagring af prompts, styring af modelvalg og kontrol af output
Byg en sporingsbaseret omkostningsmodel for inferens, optimér de største målte omkostningsposter, og dokumentér, at hver ændring bevarer opgavekvaliteten.
Avanceret 10 min læsning
Evalueringer for ikke-ingeniører: Se, om jeres AI-arbejdsgang bliver bedre eller dårligere
Evalueringer — systematisk måling af kvaliteten i AI-output — behandles normalt som et teknisk anliggende. Men alle teams med AI-arbejdsgange har brug for dem, og grundprincipperne kræver ingen kode. Sådan gør I.
Let øvet 13 min læsning
Sådan bygger du evalueringer, der faktisk opdager regressioner
De fleste evalueringssuiter ser imponerende ud, men overser reelle regressioner. Det kræver omhyggelig opbygning af datasæt, følsomme målinger, kalibrering af dommermodeller og en kultur præget af tillid at bygge evalueringer, der opdager det væsentlige. Her er mønstrene fra de teams, der lykkes med det.
Avanceret 14 min læsning
MCP fra bunden: byg en produktionsklar server i TypeScript
At bygge en produktionsklar Model Context Protocol-server kræver mere end at forbinde nogle få værktøjer. Her er mønstrene for skemadesign, godkendelse, fejlhåndtering, streaming og observabilitet samt de praktiske produktionsforhold, der gør MCP-servere nyttige i stor skala.
Avanceret 12 min læsning
Design MCP-værktøjer, som LLM'er faktisk bruger korrekt
De fleste MCP-værktøjer, vi ser, er teknisk korrekte, men praktisk talt ubrugelige. LLM'er ignorerer dem, bruger dem forkert eller foretager unødvendige kald. Her er principperne for at designe værktøjer, som LLM'er tager naturligt i brug, med eksempler på almindelige fejl og løsninger.
Avanceret 12 min læsning
Observerbarhed i LLM-applikationer: sporing, omkostninger, svartid og kvalitetsændringer
Udvid almindelig observerbarhed med flertrinsspor, henførbare omkostninger, prompt- og modelversioner, evaluerede kvalitetssignaler, databeskyttelseskontroller og advarsler baseret på arbejdsbelastningen.
Avanceret 12 min læsning
Byg produktionsklar RAG: indlæsning, embeddings, søgning, reranking og evaluering
En produktionsklar RAG-pipeline består af seks faser, hvor konkrete mønstre afgør kvaliteten. Her er arkitekturen, valgene i hver fase og den iterative evalueringsdisciplin, der adskiller velfungerende RAG fra skuffende løsninger.
Avanceret 12 min læsning
Vælg mellem prompting, RAG og finjustering (og hvornår de skal kombineres)
Prompting, RAG og finjustering er de tre store greb til at tilpasse LLM'er til dit problem. De passer hver især til nogle problemer og ikke til andre. Her er en ramme for valget, de realistiske omkostninger og de produktionsmønstre, hvor kombinationen virker bedst.
Avanceret 12 min læsning
RAG ud over chunks: Graph RAG, agentisk RAG og RAG med lang kontekst
Klassisk chunk-baseret RAG har begrænsninger. Graph RAG, agentisk RAG og RAG med lang kontekst overskrider dem på forskellige måder. Her ser vi på, hvornår hver variant er det rette værktøj, hvordan den faktisk fungerer, og hvilke afvejninger der betyder noget i produktion.
Avanceret 13 min læsning
LLM-produktets enhedsøkonomi: et evidensbaseret prisark
Kortlæg fordelingen af modelanvendelse, bidragsmargin, fejlhåndtering, support og kundefastholdelse før prisfastsættelsen. Dette ark erstatter udokumenterede markedsintervaller med efterprøvelige input.
Avanceret 13 min læsning
Strukturerede output og funktionskald: produktionsmønstrene
Strukturerede output og funktionskald er broen fra 'LLM, der genererer tekst' til 'system, der udfører arbejde'. I produktion handler de vigtige mønstre om skemaer, fejlhåndtering, idempotens og kontrolleret forringelse — ikke kun JSON-tilstand.
Avanceret 24 minutter
Jeg byggede en AI-indholdsagent med n8n og Claude (trin for trin)
Greg Isenberg. Isenberg bygger sammen med The Boring Marketer en konkret indholdsproces i n8n. De indsamler populære opslag fra YouTube og X, udarbejder nye udkast med Claude, researcher med Perplexity, genererer billeder og publicerer på LinkedIn efter menneskelig godkendelse. Det er netop den struktur med en agent mellem flere værktøjer, som artiklen beskriver, og den menneskelige gennemgang bliver vist i praksis frem for blot nævnt.
Let øvet 30 minutter
Jeg AFSLØRER ALLE vibe marketing-hemmelighederne (INGEN gatekeeping)
Greg Isenberg. En bredere gennemgang af den aktuelle AI-marketingstack, herunder automatisering af arbejdsgange, modelrouting, AI-værktøjer til video og tale samt udarbejdelse af annoncer på baggrund af konkurrentanalyse. Videoen viser, hvilke roller forskellige værktøjer kan have, før du beslutter, hvor teamets første tre Zaps eller n8n-arbejdsgange skal bruges.
Let øvet 26 minutter
Jeg bygger live en AI-salgsbot, der ringer til leads for mig
Liam Ottley. En liveopbygning af en AI-stemmeagent, der ringer til indgående leads, kvalificerer dem og forsøger at booke en indledende samtale. Make.com kombineres med en stemmeudbyder, og både kvalifikationsmanuskript og overdragelseslogik vises. Videoen supplerer e-maildelen med samme mønster for berigelse og personalisering i en anden kanal med andre fejlmuligheder.
Let øvet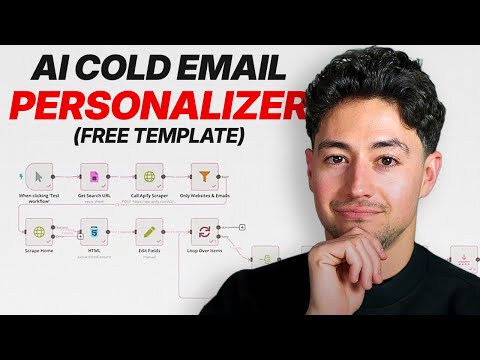 30 minutter
Jeg personaliserede mere end 1000 kolde e-mails i dybden med DETTE AI-system (GRATIS SKABELON)
Nick Saraev. Saraev bygger den arbejdsgang, som artiklen beskriver: Apollo til leads, Apify til dataindsamling, n8n til berigelse og generering af en indledning på flere linjer ud fra hvert leads website samt Instantly til afsendelse. Han er åben om omkostninger pr. lead og svarprocenter. Videoen viser dermed reel personalisering i større skala frem for blot brevfletning med et fornavn.
Let øvet 19 minutter
Er det slutningen på RAG? Anthropics NYE prompt-caching
Prompt Engineering. Gennemgår Anthropics promptcaching op mod Geminis context caching med konkrete latenstid- og omkostningsreduktioner pr. use case (long-document chat, few-shot, multi-turn). Nedbrydningen af cache-write-tillæg kontra cache-read-rabat er præcis det, artiklen antager, når den taler om, hvornår caching betaler sig.
Avanceret 56 minutter
Build Hour: prompt-caching
OpenAI. OpenAIs egen Build Hour om promptcaching — 1024-token-tærsklen, kravet om prefix-stabilitet, stejle audio-caching-rabatter for realtime (tjek den aktuelle prisside for den præcise sats), time-to-first-token-effekter ved lange inputs. Nyttig, når du dimensionerer engineering-indsatsen for faktisk at ramme cachen pålideligt på dine produktionsprompts.
Avanceret 107 minutter
How to evaluate AI products | Hamel Husain & Shreya Shankar (Lenny's Podcast)
Lenny's Podcast. Hamel Husain og Shreya Shankar gennemgår hele eval-arbejdsgangen på en rigtig property-management-AI-assistent — at se på traces, open og axial coding af fejl, at beslutte, hvornår man skal stoppe, at bygge en LLM-as-judge og validere den mod menneskelig vurdering. Det er den sjældne lange samtale, der ægte er rettet mod PM'er og team leads snarere end ML-ingeniører, og den dækker samme "30 minutter om ugen efter opsætning"-rytme, artiklen anbefaler.
Let øvet 3 minutter
Evaluér prompts i Anthropic Console
Anthropic. En tre minutters Anthropic-gennemgang af at køre en rigtig eval inde i Workbench — auto-generering af realistiske testcases, bedømmelse af outputs, justering af prompten og genkørsel af samme suite side om side. Visningstallet ligger under den sædvanlige grænse, men til "hvordan gør jeg faktisk dette uden at skrive kode" er dette den klareste officielle demo og slotter pænt ind under den mere strategiske Husain/Shankar-samtale.
Let øvet 55 minutter
Sådan sætter du systematisk LLM-evals op (metrics, unit tests, LLM-as-a-Judge)
Dave Ebbelaar. En arbejdende AI-ingeniør gennemgår sin faktiske eval-stige — assert-stil unit tests, reference-free metrics, LLM-as-judge-alignment med mennesker og analyze/measure/improve-sløjfen. Strukturen er det nærmeste match på video til artiklens argument om, at evalueringer er et regression-fangende system, ikke en leaderboard.
Avanceret 19 minutter
Sådan konstruerer du domænespecifikke LLM-evalueringssystemer: Hamel Husain og Emil Sedgh
AI Engineer. Hamel Husain og Rechats CTO gennemgår eval-systemet bag et rigtigt AI-produkt: hvorfor generiske off-the-shelf-evals fejler, en lagdelt opsætning af assertions, loggede traces med menneskelig gennemgang og LLM-judges holdt aligned med en domæneekspert, og hvordan et fungerende eval-system låser data curation og finjustering op. Det er produktionscasestudiet for artiklens argument om, at evalueringer er regression-fangende maskineri, ikke en leaderboard.
Avanceret 104 minutter
Building Agents with Model Context Protocol — fuld workshop med Mahesh Murag fra Anthropic
AI Engineer. Anthropics Mahesh Murag gennemgår MCP's design — hvorfor tools, resources og prompts er adskilt, hvordan clients forhandler capabilities, hvad produktionshosts faktisk gør med protokollen. Se den efter bygningen for at forstå de dele af MCP, SDK'et stille skjuler, og kalibrér artiklens "produktionsklar"-tjekliste mod spec-forfatternes hensigt.
Avanceret 75 minutter
Den ultimative MCP crash course — byg fra bunden
Web Dev Simplified. En fuld code-along-bygning af både en MCP-server og en client i TypeScript — tool definitions, schemas, prompts og resources, stdio-transport, inspector-debugging. Det er den nærmeste video på YouTube til faktisk at gøre det, artiklen beder dig om, i et tempo, hvor du kan pause og følge med i din egen editor.
Avanceret 19 minutter
Bygning af mere effektive AI-agenter
Anthropic. Anthropic-ingeniører gennemgår, hvad de faktisk ændrede, da deres multi-agent-systemer misbrugte værktøjer — sammenlægning af endpoints, returnering af navne i stedet for IDs, leaning på MCP'er og Agent Skills i stedet for at proppe flere værktøjer ind i systemprompten. Mapper punkt-for-punkt til artiklens tjekliste for værktøjsbeskrivelser og return-shape-design.
Avanceret 29 minutter
Prompting til agenter | Code med Claude
Anthropic. Hannah Moran og Jeremy Hadfield fra Applied AI gennemgår, hvordan man formulerer tool calls og agentprompts på en rigtig Pokemon-spillende agent — hvornår man skal skubbe adfærd ind i systemprompten kontra værktøjsbeskrivelsen, hvad modellen behøver at vide om hvert værktøjs forudsætninger. Nyttig umiddelbart efter, at du har skrevet din første MCP-server og opdager, at Claude kalder den på uventede måder.
Avanceret 9 minutter
LangSmith på 10 minutter
LangChain. En guidet tour af en LLM-trace, project og dataset af LangChains medstifter — token-omkostning, latenstid, fejlrate, feedback-aggregering, drill-down i et enkelt retrieval-step-span. Det er den nærmeste visuelle analog til det, artiklen beskriver, når den taler om "hvert kald er et span", og hvorfor strukturerede traces slår print-logging.
Avanceret 154 minutter
Instrumentering og evaluering af LLM'er
Hamel Husain. Hamel Husain, Eugene Yan, Brian Bischof, Harrison Chase og Shreya Shankar arbejder sig igennem tracing, loganalyse, LLM-as-judge og arbejdsgangen omkring at se på rigtige produktionsdata. Sid med den på samme måde, som du ville med en lang podcast — det er den bedste dybe behandling af artiklens tese "se på dine traces" på YouTube.
Avanceret 17 minutter
RAG Agents in Prod: 10 lektioner, vi lærte — Douwe Kiela, skaber af RAG
AI Engineer. Douwe Kiela ledede det oprindelige RAG-paper på FAIR og shipper nu RAG ind i regulerede enterprises. Talket handler mest om, hvad der holder op med at virke i skala — chunking-strategier, der ikke overlever 100k dokumenter, "accuracy is table stakes, inaccuracy is the real problem", og hvorfor attribution og observerbarhed betyder mere end embedding-modellen. God kalibrering, før du genlæser artiklens eval- og monitoring-afsnit.
Avanceret 19 minutter
Bygning af produktionsklare RAG-applikationer: Jerry Liu
AI Engineer. LlamaIndex' CEO gennemgår gapet mellem "naiv RAG-demo" og en rigtig pipeline — small-to-big retrieval, sub-question routing, hybrid search, evaluering. Formen på hans slides mapper næsten direkte til artiklens pipeline-afsnit; se først, og genlæs derefter artiklen med hans diagrammer i hovedet.
Avanceret 9 minutter
RAG vs. fine-tuning
IBM Technology. Strammere fokus på de to teknikker, teams oftest forveksler. Går dybere ind i datafreshness, kildeattribution og inference-time-hastighedsargumentet for finjustering. Værd at se, hvis du specifikt forsøger at argumentere imod et unødvendigt fine-tune-projekt.
Avanceret 13 minutter
RAG vs Fine-Tuning vs Prompt Engineering: Optimering af AI-modeller
IBM Technology. En klar whiteboard-gennemgang af alle tre teknikker med deres respektive omkostninger — retrieval-latenstid, træningscompute og catastrophic forgetting, grænserne for prompt-only-løsninger — og de kombinationer, der faktisk giver mening i produktion. Det afsluttende eksempel på et juridisk AI-system, der bruger alle tre, er næsten præcis artiklens "hvornår skal de kombineres"-argument.
Avanceret 39 minutter
Introducing RAG 2.0: Agentic RAG + Knowledge Graphs (GRATIS skabelon)
Cole Medin. En arbejdende agentic-RAG-plus-knowledge-graph-bygning, hvor agenten beslutter, hvornår den skal lave vector search, hvornår den skal ramme Neo4j, og hvornår den skal gøre begge dele. Det er den klareste demonstration på YouTube af mønsteret "agenten som retrieval-planner", artiklen beskriver, i kode du faktisk kan trække ned og køre.
Avanceret 16 minutter
Graph RAG: Forbedring af RAG med knowledge graphs
Prompt Engineering. En fokuseret gennemgang af Microsofts GraphRAG — entity extraction, community summaries, query-focused summarization — sat op på en lokal maskine med omkostningsnoter. Se den specifikt til artiklens graph-RAG-afsnit; omkostningsdiskussionen er den del, de fleste write-ups springer over.
Avanceret 42 minutter
Vertikale AI-agenter kan blive 10X større end SaaS
Y Combinator. Lightcone-værterne arbejder sig gennem, hvorfor vertikale AI-agenter — ikke horisontale wrappers — er den forsvarlige form for application-layer-virksomheder, med konkrete eksempler og et klart syn på, hvilke kategorier modeludbyderne vil æde. Det er anti-moat-fælden, artiklen advarede om, udtrykt som en positiv playbook.
Avanceret 34 minutter
Sådan genopfinder AI software-forretningsmodeller med Bret Taylor fra Sierra
Sequoia Capital. Bret Taylor gennemgår skiftet fra per-seat SaaS til outcomes-baseret prissætning — hvad du skal forankre i (resolution, CSAT, NPS), hvorfor incumbents har svært ved at følge med, og hvordan vertikal specialisering skaber pricing power. Det spejler direkte artiklens afsnit om prissætning og marginer.
Avanceret 41 minutter
OpenAI DevDay 2024 | Strukturerede outputs til pålidelige applikationer
OpenAI. Gennemgår `strict: true`, forskellen fra gammel JSON-mode, refusal-håndtering og hvordan function calling og response-format-schemas komponerer. Nyttig præcis, fordi den beskriver den kontrakt, API'et giver dig, som er det, artiklens produktionsmønstre er bygget ovenpå.
Avanceret 18 minutter
Pydantic er alt, du har brug for: Jason Liu
AI Engineer. Talket, der krystalliserede det moderne mønster "definér en Pydantic-model, giv den til LLM'en, lad validering gøre resten", med konkrete eksempler på nestede objekter, validators der fanger hallucinerede URL'er, og Chain-of-Thought som et typet felt. Se den, før du genlæser artiklens afsnit om validators, og du vil genkende, hvor dens retry- og refusal-regler kommer fra.
Avanceret 8 minutter
Wharton-professor: 4 scenarier for AI's fremtid | Ethan Mollick for Big Think+
Big Think. Videoen giver på 8 minutter en kort version af Mollicks model med fire scenarier: statisk udvikling, lineær udvikling, eksponentiel udvikling og AGI. Den forklarer også hans begrundelse for at planlægge efter scenarie to eller tre frem for at satse alt på et yderpunkt. Modellen kan bruges til at tydeliggøre ledelsens antagelser, før teamets plan udformes.
Let øvet 60 minutter
Alle ledere har brug for denne AI-strategi | Ethan Mollick forklarer
Sana. Mollick diskuterer i en time, hvordan AI kan ændre arbejdet i organisationer. Han udfordrer en tilgang, der kun handler om omkostningsbesparelser, og beskriver ændringer i organisationsformer og såkaldte "AI-native" teams. Videoen ligger under den sædvanlige grænse på 100k visninger, men der er næsten et 1:1-forhold mellem dens emner og artiklens fokus på arbejdsgange, kompetencer og organisatorisk risiko.
Let øvet