

Конфиденциальный, локальный и самостоятельно размещённый ИИ
Локальные модели, конфиденциальные варианты развёртывания, самостоятельное размещение и гибридные архитектуры.
15 материалов (11 статей · 4 видео)
Начните здесь
Несколько хороших первых материалов перед полной лентой.
 10 мин чтения
Варианты развёртывания конфиденциального ИИ: локально, в VPC, на своих серверах и гибридно
Конфиденциальный ИИ — это не одна архитектура. Практическое сравнение локальных моделей, корпоративного SaaS, развёртывания в VPC, инференса на своей инфраструктуре и гибридных вариантов для малого и среднего бизнеса.
Продвинутый 11 мин чтения
Самостоятельное размещение или управляемый инференс: модель точки безубыточности
При каком масштабе самостоятельное размещение становится выгоднее API? Расчёты, эксплуатационные затраты и признаки, по которым можно выбрать между своей инфраструктурой и управляемым инференсом.
ПродвинутыйЕще по этой теме
 8 мин чтения
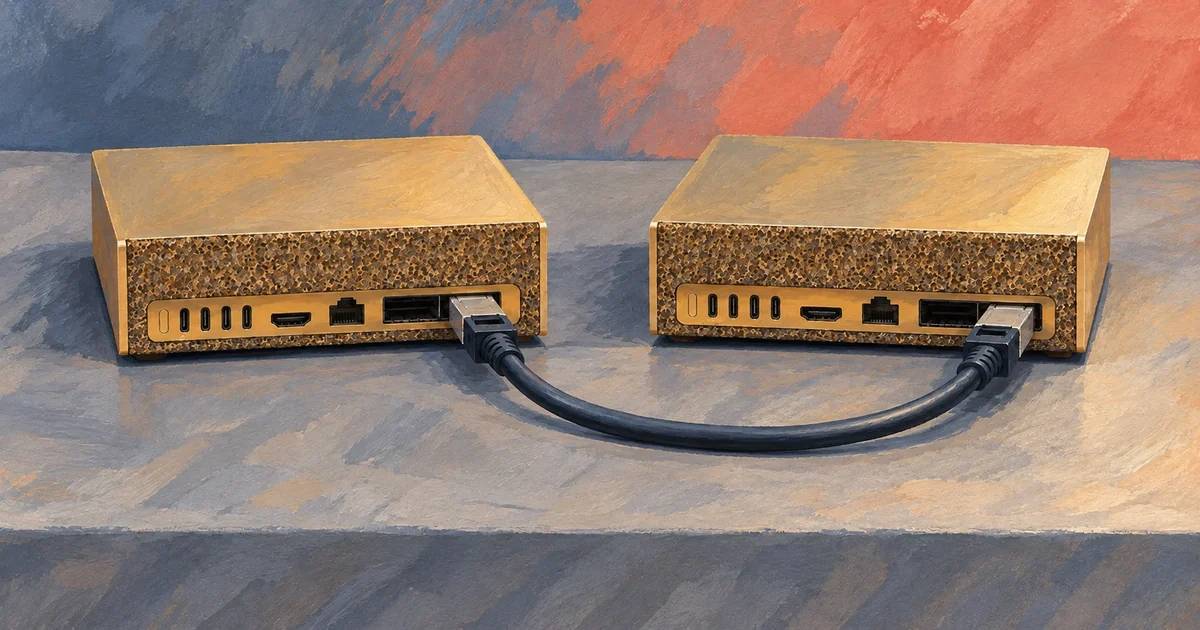
Подключение двух узлов DGX Spark: QSFP, SSH, RoCE и Cluster Assistant
Практическое руководство по подключению двух узлов NVIDIA DGX Spark с помощью QSFP и ConnectX-7: единое имя пользователя, SSH без пароля, RoCE для распределённых рабочих нагрузок, NVIDIA Sync Cluster Assistant и процедура отката.
Продвинутый 8 мин чтения
Реальность локального инференса на DGX Spark: память, стек и когда облако всё ещё выигрывает
Как интерпретировать заявления NVIDIA о 128 ГБ когерентной памяти и примерно 200 млрд параметров на одном узле, выбрать стек инференса и спроектировать аппаратные тесты, которые определят пригодность локального инференса.
Продвинутый 9 мин чтения
DGX Spark: что это, для кого и что изменилось для локальных агентов
Приземлённый разбор NVIDIA DGX Spark: спецификации Grace Blackwell GB10 от NVIDIA, когерентная унифицированная память, кластеризация ConnectX-7 и когда настольный компьютер для агентов — правильная ставка на частный ИИ.
Продвинутый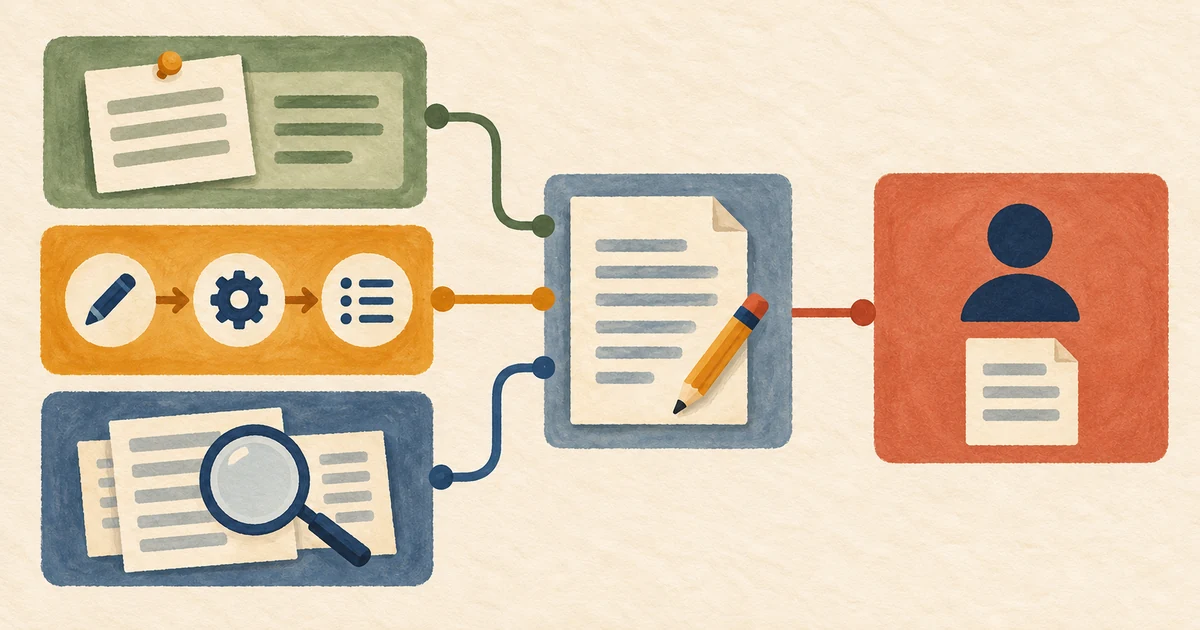 7 мин чтения
Hermes Agent: что это такое, чем не является и когда его следует использовать
Чёткая карта Hermes Agent от Nous Research: постоянная память, навыки, инструменты и шлюзы обмена сообщениями, а также критерии выбора между обычным чат-ботом и средой выполнения агентов.
Уверенный 8 мин чтения
Вызов vLLM и других OpenAI-совместимых эндпоинтов из n8n
Вызывайте локальную OpenAI-совместимую конечную точку /v1/chat/completions из узла HTTP Request в n8n с явной аутентификацией, бюджетами тайм-аутов, проверками базового URL и границей частной сети.
Уверенный 10 мин чтения
NemoClaw на DGX Spark: план развертывания и безопасности
Спланируйте и оцените работу OpenClaw, Hermes или Deep Agents Code внутри NVIDIA OpenShell на DGX Spark: текущая настройка, уровни политик, маршрутизация инференса и необходимые доказательства приемки.
Продвинутый 9 мин чтения
Настройка личного шлюза OpenClaw: установка, онбординг, панель управления
Что такое OpenClaw, как установить и провести первичную настройку самодостаточного многоканального шлюза, открыть панель управления на порту 18789 и какие версии Node поддерживаются, не пропуская базовый уровень безопасности.
Уверенный 10 мин чтения
Экспериментальный стек из двух DGX Spark, DeepSeek-V4-Flash, n8n и Hermes
Как оценить экспериментальную конфигурацию сообщества для DeepSeek-V4-Flash на двух DGX Spark, где n8n отвечает за детерминированную автоматизацию, а Hermes выполняет задачи, требующие суждения.
Продвинутый 37 мин
Возможности VMware Private AI Foundation и обновление от Broadcom
Tech Field Day. Показывает конфиденциальный ИИ как многослойную инфраструктуру: контролируемые вычисления, изолированные среды, Kubernetes, контейнеры инференса, управление моделями, самообслуживание, совместное использование GPU и мониторинг. Это соответствует предупреждению статьи: конфиденциальность зависит от границ, журналирования, доступа и эксплуатации, а не от одного слова «локально».
Продвинутый 13 мин чтения
Дообучение в 2026 году: эксперимент с LoRA и QLoRA и измеримыми результатами
Решите, оправдано ли параметрически эффективное дообучение, управляйте данными, зафиксируйте воспроизводимый эксперимент, сравните результаты на отложенных выборках и тестах безопасности, а также проведите бенчмарки обслуживания перед развертыванием.
Продвинутый 157 мин
Fine-tuning LLM-моделей — курс по генеративному ИИ
freeCodeCamp.org. Курс разбирает квантизацию, LoRA, QLoRA и PEFT на примерах Llama 2 и Gemma. Курс даёт примеры расхода VRAM для конкретных конфигураций. Статья требует измерений на выбранной модели и оборудовании; эти примеры не доказывают, что для любой подходящей задачи можно обойтись без кластера.
Продвинутый 59 мин
Разработка LLM: сборка, обучение, fine-tuning
Sebastian Raschka. Обзор Рашки помогает понять место дообучения в обучении модели. Он дополняет описанный в статье подход к эксперименту с LoRA: сначала измерить разрыв относительно базового варианта на конкретной задаче и проверить ресурсы, затем оценить адаптер перед выпуском.
Продвинутый 32 мин
Быстрый сервинг LLM с vLLM и PagedAttention
Anyscale. Видео разбирает пример потери 60–80% памяти GPU, PagedAttention и пакетную обработку. Это контекст для модели затрат при сопоставимом качестве; измеряйте производительность и загрузку на своей нагрузке.
Продвинутый