

KI für Unternehmen
KI-Systeme für Unternehmen, Einführungsentscheidungen, Kunden-Workflows und messbare Ergebnisse.
58 Beiträge (25 Artikel · 33 Videos)
Hier beginnen
Einige gute Beiträge für den Einstieg, bevor Sie die vollständige Übersicht durchsuchen.
 11 Min. Lesezeit
Ein Playbook für die KI-Einführung im Team entwickeln
Ein praxisnahes Playbook für die KI-Einführung: Wählen Sie klar begrenzte Anwendungsfälle, beteiligen Sie die betroffenen Beschäftigten, legen Sie Daten- und Entscheidungsregeln fest, schulen Sie anhand realer Arbeit und vergleichen Sie die Wirkung mit einem Ausgangswert.
Mittelstufe 9 Min. Lesezeit
KI-ROI und Reifegrad: So messen Sie eine Einführung, die tatsächlich funktioniert
Der Erfolg einer KI-Einführung bemisst sich nicht daran, wie viele Personen ChatGPT ausprobiert haben. Ein praxisnaher Rahmen zur Messung von Workflow-ROI, Qualität, Risiko, Reifegrad und Skalierungsbereitschaft.
Fortgeschritten 9 Min. Lesezeit
KI-Systeme entwickeln oder kaufen: ein praktischer Entscheidungsrahmen
Vergleichen Sie Kauf, Konfiguration, Erweiterung, Eigenentwicklung und Selbsthosting anhand derselben Anforderungen, verbindlichen Ausschlusskriterien, eines repräsentativen Tests und eines einheitlichen Gesamtkostenmodells.
FortgeschrittenWeitere in diesem Thema
 9 Min. Lesezeit
DGX Spark: was es ist, für wen es gedacht ist und was sich für lokale Agenten geändert hat
Eine sachliche Einordnung von NVIDIA DGX Spark: die Grace-Blackwell-GB10-Spezifikationen von NVIDIA, kohärenter Unified Memory, ConnectX-7-Clustering und die Frage, wann ein Agentenrechner am Schreibtisch die richtige Wahl für private KI ist.
Fortgeschritten 12 Min. Lesezeit
Codex, Claude Code und Cursor als ein CLI-Team nutzen
Nutzen Sie AGENTS.md, CLAUDE.md, Cursor-Regeln und nicht interaktive CLI-Modi, damit Codex entwirft, Claude prüft und Cursor implementiert, ganz ohne eigene Orchestrierungsplattform.
Fortgeschritten 15 Min. Lesezeit
Multi-Agent-Projektmanagement mit Linear: Claude, Cursor und Codex mit gemeinsamem Backlog
Lassen Sie Claude Code, Cursor und Codex wie ein echtes Entwicklungsteam am selben Linear-Projekt arbeiten: Aufgaben übernehmen, Fortschritt dokumentieren, Prüfungen übergeben, Befunde beheben und Issues schließen, ohne einander in die Quere zu kommen.
Fortgeschritten 8 Min. Lesezeit
Die Würde der Arbeit, wenn Maschinen mehr davon übernehmen können
Eine praktische Bewertung der Arbeitsgestaltung für Führungskräfte in KMU: Prüfen Sie Mitsprache, verbleibenden Entscheidungsspielraum, Lern- und Entwicklungspfade, Arbeitsbelastung, Überwachung und Einspruchsmöglichkeiten, bevor Sie eine Automatisierung als Erfolg verbuchen.
Mittelstufe 8 Min. Lesezeit
Was Sie Ihrem Team sagen sollten, wenn Sie einen Teil der Teamarbeit automatisieren
Eine praktische Kommunikationsabfolge für Automatisierungsprojekte: Was Sie sagen sollten, bevor die Entscheidung feststeht, welche Zusagen Vertrauen schaffen und welche Versprechen Führungskräfte nicht geben sollten.
Mittelstufe 32 Minuten
Wie man menschenzentrierte KI-Workflows in der Lokalisierung erstellt – mit Shashi Bhushan
Crowdin. Shashi Bhushan beginnt mit der Erfassung des Workflows statt mit der Tool-Auswahl. Anschließend behandelt er die Qualität des Ausgangstexts, menschliche Prüfung, KI-Lektorat, Glossarprüfungen, die Einbindung des Produktteams, Pilotprojekte und Datenschutzbeschränkungen. Das entspricht nahezu genau dem Betriebsmodell, das der Artikel estnischen Teams für die Arbeit auf Estnisch, Englisch, Russisch, Finnisch und mit kundenspezifischer Terminologie empfiehlt.
Mittelstufe 4 Minuten
Einführung in EmbeddingGemma: Das beste Open-Model für On-Device-Embeddings
Google for Developers. Das Video stellt mehrsprachige Text-Embeddings vor, die lokal ausgeführt werden und semantische Suche sowie RAG ermöglichen, ohne jedes Dokument an eine gehostete API zu senden. Für estnische Unternehmen ist dies eine nützliche technische Ergänzung zum Muster des Artikels für die interne Wissenssuche: Mehrsprachiger Abruf ist nur dann wertvoll, wenn er auch Datenlokalität, Berechtigungen und die Verbindlichkeit der Quellen berücksichtigt.
Mittelstufe 17 Minuten
Conductor-CEO Charlie Holtz stellt sein KI-Coding-Setup vor
Y Combinator. Eine konkrete Demonstration eines Senior-Entwicklers statt einer Podiumsdiskussion: Holtz vergleicht Claude Code und Codex, koordiniert mehrere Coding-Agenten parallel und definiert „Slop-freie Zonen“, in denen generierter Code niemals ungeprüft landen darf. Der Aufbau verkörpert die Regeln des Artikels: Repository-Kontext, kleine prüfbare Patches und der Mensch als Architekt, während die Agenten die Tipparbeit übernehmen.
Fortgeschritten 56 Minuten
KI-Agenten im Finanzwesen mit dem Finanzvorstand (CFO) von HPE
CXOTalk. HPE-CFO Marie Myers beschreibt die Einführung agentischer KI über die Plattform „Alfred“ in einer Finanzorganisation mit 3,600 Beschäftigten. Dabei folgt sie genau der vom Artikel geforderten Disziplin: ein Rahmen für direkten und indirekten ROI, Entscheidungsschleusen zur Fortsetzung oder Beendigung einzelner Anwendungsfälle, verpflichtende Qualitätskontrollen mit Menschen in der Prüfschleife und Workflowkennzahlen, etwa für einen wöchentlichen Prüfprozess, dessen manueller Aufwand um ungefähr 90% sank. Gemessen wird veränderte Arbeit, nicht die Zahl der Tool-Anmeldungen.
Fortgeschritten 41 Minuten
Private KI vs. Cloud: Wie Führungskräfte bessere Make-or-Buy-Entscheidungen treffen
World Wide Technology. Das Video verknüpft Make-or-Buy-Entscheidungen mit Geschäftsergebnissen, der Platzierung von Workloads, Cloud-Wirtschaftlichkeit, Datensouveränität, Sicherheit, Infrastrukturreife und hybriden Betriebsmodellen. Damit unterstützt es die Entscheidung, wann ein Werkzeug gekauft, eine Plattform erweitert, eine schlanke individuelle Schicht entwickelt oder ein größerer Teil des Bereitstellungs-Stacks selbst verantwortet werden sollte.
Fortgeschritten 10 Min. Lesezeit
Mehrsprachige KI-Workflows für estnische Unternehmen
Ein praktisches Workflow-Modell für estnische Unternehmen, die auf Estnisch, Englisch, Russisch, Finnisch und in weiteren Kundensprachen arbeiten – ohne Ton, Terminologie, Datenschutz oder Verantwortlichkeit zu verlieren.
Mittelstufe 9 Min. Lesezeit
KI-native IDEs und Repository-bewusste Entwicklungsworkflows
Cursor, Copilot, Claude Code und Repository-bewusste Agenten verändern die Softwareentwicklung nur, wenn Teams Grenzen setzen. Ein praktischer Workflow für Codebasis-Kontext, Planung, Tests, Code-Review, Geheimnisse und Produktsicherheit.
Fortgeschritten 9 Min. Lesezeit
EU-KI-Verordnung für KMU: ein praktischer Governance-Plan
Die EU-KI-Verordnung ist nicht nur ein rechtliches Problem für große Anbieter. Ein praktischer Plan für KMU zu Bestandsaufnahme, Risikoklassifizierung, menschlicher Aufsicht, Transparenz, Anbieternachweisen und einem kontrollierten Rollout.
Fortgeschritten 10 Min. Lesezeit
Bereitstellungsmuster für private KI: lokal, in der VPC, selbst gehostet und hybrid
Private KI ist keine einzelne Architektur. Ein praktischer Vergleich lokaler Modelle, Enterprise-SaaS, VPC-Bereitstellungen, selbst gehosteter Inferenz und hybrider Muster für KMU, denen Datenschutz und Kontrolle wichtig sind.
Fortgeschritten 10 Min. Lesezeit
Der KI-Marketing-Stack: Content, SEO und Social Media mit menschlicher Freigabe
Mögliche KI-gestützte Marketing-Workflows für zulässige Recherche, quellenbasierte Entwürfe, SEO-Prüfung, Anpassung, menschliche Veröffentlichungsfreigabe und messbare Ergebnisse, ergänzt um rechtliche Prüfungen für den jeweiligen Rechtsraum vor dem Start.
Mittelstufe 11 Min. Lesezeit
Der KI-Vertriebsstack: Lead-Anreicherung, Personalisierung und Follow-up in großem Maßstab
Ein praktischer KI-Vertriebsstack für Recherche, Personalisierung, Kontaktsequenzen und Follow-up, ohne zu dem Spam zu werden, den alle löschen. Architektur, Werkzeuge, Prompts und Schutzvorkehrungen für wirksame statt lästige Kommunikation.
Mittelstufe 12 Min. Lesezeit
Inferenzkosten optimieren: Prompt-Caching, Routing und Ausgabe-Steuerung
Erstellen Sie anhand von Traces ein Kostenmodell für die Inferenz, optimieren Sie die größten gemessenen Kostenfaktoren und belegen Sie, dass jede Änderung die Aufgabenqualität erhält.
Fortgeschritten 10 Min. Lesezeit
Evals für Nichttechniker: Erkennen Sie, ob Ihr KI-Workflow besser oder schlechter wird
Evals messen die Qualität von KI-Ausgaben systematisch und gelten meist als Aufgabe für Entwickler. Doch jedes Team mit KI-Workflows benötigt sie, und die Grundlagen kommen ohne Code aus. Eine praktische Anleitung.
Mittelstufe 13 Min. Lesezeit
Evals erstellen, die tatsächlich Regressionen erkennen
Die meisten Eval-Suites wirken beeindruckend, übersehen aber reale Regressionen. Evals, die relevante Fehler erkennen, erfordern sorgfältig aufgebaute Datensätze, empfindliche Metriken, kalibrierte Judges und eine Kultur des Vertrauens. Diese Muster nutzen Teams, die es richtig machen.
Fortgeschritten 14 Min. Lesezeit
MCP von Grund auf: Einen produktionsreifen Server in TypeScript entwickeln
Ein produktionsreifer Model-Context-Protocol-Server erfordert mehr als die Anbindung einiger Tools. Entscheidend sind Schemadesign, Authentifizierung, Fehlerbehandlung, Streaming, Observability und die betrieblichen Anforderungen, durch die MCP-Server im großen Maßstab zuverlässig nutzbar werden.
Fortgeschritten 12 Min. Lesezeit
MCP-Tools so entwerfen, dass LLMs sie zuverlässig verwenden
Die meisten MCP-Tools, die wir sehen, sind technisch korrekt, aber praktisch unbrauchbar. LLMs ignorieren sie, verwenden sie falsch oder rufen sie auf ungeeignete Weise auf. Diese Designprinzipien sorgen dafür, dass LLMs Tools zuverlässig einsetzen – mit konkreten Fehlerbildern und Korrekturen.
Fortgeschritten 12 Min. Lesezeit
Observability für LLM-Apps: Tracing, Kosten, Latenz und Qualitätsdrift
Erweitern Sie die übliche Observability um mehrstufige Traces, zurechenbare Kosten, Prompt- und Modellversionen, evaluierte Qualitätssignale, Datenschutzkontrollen und aus der jeweiligen Aufgabe abgeleitete Warnmeldungen.
Fortgeschritten 12 Min. Lesezeit
Produktionsreifes RAG entwickeln: Ingestion, Embedding, Retrieval, Reranking und Evals
Eine produktionsreife RAG-Pipeline umfasst sechs Stufen, deren spezifische Muster die Qualität bestimmen. Architektur, Entscheidungen je Stufe und konsequente iterative Evaluation unterscheiden ein funktionierendes RAG-System von einem enttäuschenden.
Fortgeschritten 12 Min. Lesezeit
Prompting, RAG oder Fine-Tuning wählen — und wann Sie sie kombinieren sollten
Prompting, RAG und Fine-Tuning sind die drei großen Hebel, um große Sprachmodelle an Ihr Problem anzupassen. Jeder eignet sich für bestimmte Probleme und für andere nicht. Ein Entscheidungsrahmen, die realistischen Kosten jedes Ansatzes und erfolgreiche Kombinationsmuster für den Produktivbetrieb.
Fortgeschritten 12 Min. Lesezeit
RAG jenseits von Chunking: Graph RAG, agentisches RAG und Long-Context RAG
Klassisches Chunk-basiertes RAG hat Grenzen. Graph RAG, agentisches RAG und Long-Context RAG überwinden sie auf unterschiedliche Weise. Erfahren Sie, wann welcher Ansatz das richtige Werkzeug ist, wie er tatsächlich funktioniert und welche Kompromisse im Produktivbetrieb relevant sind.
Fortgeschritten 13 Min. Lesezeit
Unit Economics für LLM-Produkte: ein Arbeitsblatt für evidenzbasierte Preise
Prüfen Sie vor der Preisfestlegung die Verteilung der Modellnutzung, den Deckungsbeitrag, die Fehlerbehandlung, den Supportaufwand und die Kundenbindung. Dieses Arbeitsblatt ersetzt unbelegte Marktbandbreiten durch überprüfbare Eingaben.
Fortgeschritten 13 Min. Lesezeit
Strukturierte Ausgaben und Function Calling: Muster für den Produktivbetrieb
Strukturierte Ausgaben und Function Calling bilden die Brücke vom „LLM, das Text generiert“ zum „System, das Aufgaben ausführt“. Im Produktivbetrieb zählen robuste Schemata, Fehlerbehandlung, Idempotenz und kontrollierte Degradation – nicht nur der JSON-Modus.
Fortgeschritten 24 Minuten
Ich habe mit N8N und Claude einen KI-Content-Agenten entwickelt (Schritt für Schritt)
Greg Isenberg. Isenberg entwickelt mit The Boring Marketer eine reale Content-Pipeline in n8n. Sie sammelt besonders erfolgreiche Beiträge von YouTube und X, erstellt mit Claude neue Entwürfe, recherchiert mit Perplexity, generiert Bilder und veröffentlicht nach einem menschlichen Freigabeschritt auf LinkedIn. Das entspricht genau dem im Artikel beschriebenen Muster „Agent in der Mitte, Werkzeuge auf beiden Seiten“. Die menschliche Prüfung wird tatsächlich gezeigt und nicht nur erwähnt.
Mittelstufe 30 Minuten
Ich enthülle alle Geheimnisse des Vibe-Marketings (ohne Gatekeeping)
Greg Isenberg. Ein breiter Überblick über den aktuellen KI-Marketing-Stack mit Workflow-Automatisierung, Modell-Routing, KI-Werkzeugen für Video und Sprache sowie Anzeigenerstellung anhand von Wettbewerbsanalysen. So sehen Sie, welche Werkzeuge in den einzelnen Bereichen welche Aufgaben übernehmen, bevor Sie entscheiden, wo Ihr Team die ersten drei Zaps oder n8n-Flows einsetzen sollte.
Mittelstufe 26 Minuten
Live einen KI-Vertriebsbot entwickeln, der Leads für mich anruft
Liam Ottley. Der Live-Aufbau eines KI-Sprachagenten, der eingehende Leads anruft, qualifiziert und ein Erstgespräch zu vereinbaren versucht. Make.com, ein Sprachanbieter, das Qualifizierungsskript und die Übergabelogik sind zu sehen. Das ergänzt den E-Mail-Kanal gut: dasselbe Muster aus Anreicherung und anschließender Personalisierung, aber ein anderer Kanal mit anderen Fehlermodi.
Mittelstufe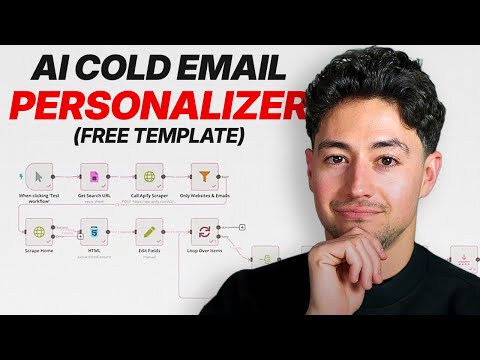 30 Minuten
Ich habe 1000+ Kaltakquise-E-Mails mit DIESEM KI-System tiefgehend personalisiert (KOSTENLOSE VORLAGE)
Nick Saraev. Saraev entwickelt genau die im Artikel beschriebene Pipeline: Apollo für Leads, Apify zum Scrapen, n8n zur Datenanreicherung und zur Erstellung eines mehrzeiligen individuellen Einstiegstexts anhand der Website jedes Leads sowie Instantly für den Versand. Dabei spricht er offen über die Kosten pro Lead und die Antwortraten. Dies ist die klarste Demonstration echter Personalisierung in großem Maßstab statt eines bloßen Serienbriefs mit Vornamen.
Mittelstufe 19 Minuten
Ist das das Ende von RAG? Anthropics NEUES Prompt-Caching
Prompt Engineering. Das Video vergleicht Anthropics Prompt-Caching mit Geminis Context Caching und zeigt konkrete Latenz- und Kostensenkungen für Chats mit langen Dokumenten, Few-Shot- und Multi-Turn-Anwendungen. Die Gegenüberstellung des Aufpreises für Cache-Schreibvorgänge und des Rabatts für Cache-Lesevorgänge entspricht genau der Annahme des Artikels dazu, wann sich Caching auszahlt.
Fortgeschritten 56 Minuten
Build Hour: Prompt-Caching
OpenAI. OpenAIs eigene Build Hour zum Prompt-Caching behandelt die Schwelle von 1024 Tokens, die erforderliche Stabilität des Präfixes, hohe Rabatte für Echtzeit-Audio-Caching, deren genauen Satz Sie auf der aktuellen Preisseite finden, und die Auswirkung langer Eingaben auf die Zeit bis zum ersten Token. Das ist nützlich, wenn Sie den technischen Aufwand abschätzen, um den Cache mit produktiven Prompts zuverlässig zu treffen.
Fortgeschritten 107 Minuten
Warum KI-Evals die gefragteste neue Fähigkeit für Produktentwickler sind | Hamel Husain & Shreya Shankar
Lenny's Podcast. Hamel Husain und Shreya Shankar durchlaufen den gesamten Eval-Workflow anhand eines realen KI-Assistenten für die Immobilienverwaltung — Traces prüfen, Fehler offen und axial kodieren, einen sinnvollen Abbruchpunkt bestimmen, einen LLM-as-Judge entwickeln und ihn anhand menschlicher Bewertungen validieren. Dieses seltene ausführliche Gespräch richtet sich tatsächlich an Produktmanager und Teamleitungen statt an ML-Entwickler. Es behandelt außerdem genau den vom Artikel empfohlenen Rhythmus von „30 Minuten pro Woche nach der Einrichtung“.
Mittelstufe 3 Minuten
Prompts in der Anthropic Console bewerten
Anthropic. Eine dreiminütige Anthropic-Anleitung für eine reale Evaluierung in der Workbench — realistische Testfälle automatisch erzeugen, Ausgaben bewerten, den Prompt anpassen und dieselbe Testsuite anschließend nebeneinander erneut ausführen. Die Aufrufzahl liegt unter der üblichen Schwelle. Für die Frage „Wie setze ich das ohne Programmierung praktisch um?“ ist dies jedoch die klarste offizielle Demonstration und eine gute Ergänzung zum strategischeren Gespräch mit Husain und Shankar.
Mittelstufe 55 Minuten
LLM-Evaluierungen systematisch einrichten (Metriken, Unit-Tests, LLM-as-a-Judge)
Dave Ebbelaar. Ein praktizierender KI-Entwickler stellt seine tatsächlich verwendete Eval-Stufenfolge vor: assertionsbasierte Unit-Tests, referenzfreie Metriken, die Abstimmung von LLM-as-a-Judge mit menschlichen Bewertungen und den Zyklus aus Analysieren, Messen und Verbessern. Diese Struktur entspricht am ehesten dem Argument des Artikels, dass Evals ein System zum Erkennen von Regressionen sind und keine Rangliste.
Fortgeschritten 19 Minuten
Domänenspezifische LLM-Evaluierungssysteme entwickeln: Hamel Husain und Emil Sedgh
AI Engineer. Hamel Husain und Emil Sedgh, CTO von Rechat, erläutern das Eval-System hinter einem realen KI-Produkt: warum generische Standard-Evals scheitern, wie Assertions, protokollierte Traces mit menschlicher Prüfung und an Domänenexperten ausgerichtete LLM-Bewerter aufeinander aufbauen und wie ein funktionierendes Eval-System Datenkuratierung und Fine-Tuning ermöglicht. Dies ist die Fallstudie aus dem Produktionseinsatz zum Argument des Artikels, dass Evals der Regressionserkennung dienen und keine Rangliste bilden.
Fortgeschritten 104 Minuten
Agenten mit dem Model Context Protocol entwickeln – vollständiger Workshop mit Mahesh Murag von Anthropic
AI Engineer. Mahesh Murag von Anthropic erläutert den Entwurf von MCP: weshalb Werkzeuge, Ressourcen und Prompts getrennt sind, wie Clients Fähigkeiten aushandeln und wie Produktions-Hosts das Protokoll tatsächlich einsetzen. Sehen Sie sich den Workshop nach der Implementierung an, um die Teile von MCP zu verstehen, die das SDK im Hintergrund verbirgt, und die Checkliste des Artikels zur Produktionsreife mit der Absicht der Spezifikationsautoren abzugleichen.
Fortgeschritten 75 Minuten
Der ultimative MCP-Crashkurs – von Grund auf entwickeln
Web Dev Simplified. Eine vollständige Implementierung zum Mitmachen, die sowohl einen MCP-Server als auch einen Client in TypeScript entwickelt: Werkzeugdefinitionen, Schemata, Prompts und Ressourcen, stdio-Transport und Fehlersuche im Inspector. Kein anderes Video auf YouTube kommt der praktischen Aufgabe des Artikels näher. Das Tempo erlaubt es, im eigenen Editor Schritt für Schritt mitzuarbeiten.
Fortgeschritten 19 Minuten
Effektivere KI-Agenten entwickeln
Anthropic. Anthropic-Entwickler zeigen, was sie tatsächlich änderten, als ihre Multi-Agenten-Systeme Werkzeuge falsch verwendeten: Endpunkte zusammenführen, Namen statt IDs zurückgeben und MCP sowie Agent Skills nutzen, statt immer mehr Werkzeuge in den System-Prompt zu packen. Das entspricht Punkt für Punkt der Checkliste des Artikels zu Werkzeugbeschreibungen und Rückgabeformaten.
Fortgeschritten 29 Minuten
Prompting für Agenten | Programmieren mit Claude
Anthropic. Hannah Moran und Jeremy Hadfield aus dem Applied-AI-Team zeigen an einem realen Pokémon-Spielagenten, wie Werkzeugaufrufe und Agenten-Prompts formuliert werden: Wann gehört ein Verhalten in den System-Prompt, wann in die Werkzeugbeschreibung, und welche Vorbedingungen eines Werkzeugs muss das Modell kennen? Das ist besonders nützlich, nachdem Sie Ihren ersten MCP-Server gebaut haben und Claude ihn anders als erwartet aufruft.
Fortgeschritten 9 Minuten
LangSmith in 10 Minuten
LangChain. Der Mitgründer von LangChain führt durch einen LLM-Trace, ein Projekt und einen Datensatz. Er zeigt Tokenkosten, Latenz, Fehlerrate, aggregiertes Feedback und die Detailansicht eines einzelnen Spans für einen Retrieval-Schritt. Das Video veranschaulicht am besten, was der Artikel mit „Jeder Aufruf ist ein Span“ meint und weshalb strukturierte Traces einfachen Print-Logs überlegen sind.
Fortgeschritten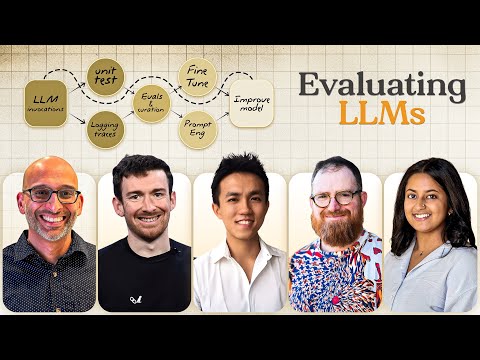 154 Minuten
LLMs instrumentieren und evaluieren
Hamel Husain. Hamel Husain, Eugene Yan, Brian Bischof, Harrison Chase und Shreya Shankar behandeln Tracing, Protokollanalyse, LLM-as-a-Judge und den Arbeitsablauf zur Untersuchung realer Produktionsdaten. Hören Sie die Sitzung wie einen langen Podcast. Sie ist die beste ausführliche Darstellung der Kernaussage „Sehen Sie sich Ihre Traces an“, die wir auf YouTube gefunden haben.
Fortgeschritten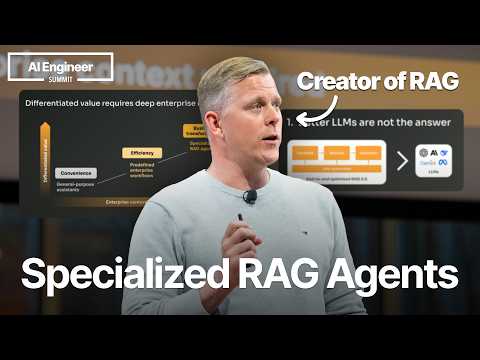 17 Minuten
RAG-Agenten im Produktivbetrieb: 10 Erkenntnisse – Douwe Kiela, Erfinder von RAG
AI Engineer. Douwe Kiela leitete die ursprüngliche RAG-Forschungsarbeit bei FAIR und bringt RAG heute in regulierte Unternehmen. Der Vortrag konzentriert sich darauf, was im großen Maßstab nicht mehr funktioniert: Chunking-Strategien, die 100k Dokumente nicht überstehen, die Aussage „Genauigkeit wird vorausgesetzt, Ungenauigkeit ist das eigentliche Problem“ sowie die Frage, weshalb Quellenzuordnung und Observability wichtiger werden als das Embedding-Modell. Das bietet die richtige Einordnung, bevor Sie die Eval- und Monitoring-Abschnitte des Artikels erneut lesen.
Fortgeschritten 19 Minuten
Produktionsreife RAG-Anwendungen entwickeln: Jerry Liu
AI Engineer. Der CEO von LlamaIndex erläutert die Lücke zwischen einer „naiven RAG-Demo“ und einer realen Pipeline: Small-to-Big Retrieval, Routing von Unterfragen, hybride Suche und Evaluation. Die Struktur seiner Folien entspricht nahezu direkt den Pipelineabschnitten des Artikels. Sehen Sie zuerst das Video und lesen Sie den Artikel anschließend mit seinen Diagrammen im Kopf erneut.
Fortgeschritten 9 Minuten
RAG vs. Fine-Tuning
IBM Technology. Ein fokussierterer Vergleich der beiden Ansätze, die Teams am häufigsten verwechseln. Das Video vertieft Datenaktualität, Quellenzuordnung und den Geschwindigkeitsvorteil von Fine-Tuning zur Inferenzzeit. Es ist besonders nützlich, wenn Sie gegen ein unnötiges Fine-Tuning-Projekt argumentieren möchten.
Fortgeschritten 13 Minuten
RAG vs. Fine-Tuning vs. Prompt-Engineering: KI-Modelle optimieren
IBM Technology. Eine klare Whiteboard-Darstellung aller drei Ansätze und ihrer jeweiligen Kosten: Retrieval-Latenz, Rechenaufwand für das Training und katastrophales Vergessen sowie die Grenzen reiner Prompt-Lösungen. Außerdem zeigt das Video, welche Kombinationen im Produktionseinsatz sinnvoll sind. Das abschließende Beispiel eines KI-Systems für den Rechtsbereich entspricht nahezu genau dem Argument des Artikels zur Kombination der Ansätze.
Fortgeschritten 39 Minuten
Einführung in RAG 2.0: agentisches RAG und Wissensgraphen (KOSTENLOSE Vorlage)
Cole Medin. Eine funktionierende Implementierung von agentischem RAG mit Wissensgraphen, bei der der Agent entscheidet, wann er eine Vektorsuche, eine Abfrage von Neo4j oder beides ausführt. Dies ist die klarste YouTube-Demonstration des im Artikel beschriebenen Musters „Agent als Retrieval-Planer“ — mit Code, den Sie herunterladen und selbst ausführen können.
Fortgeschritten 16 Minuten
Graph RAG: RAG mit Wissensgraphen verbessern
Prompt Engineering. Eine fokussierte Einführung in Microsoft GraphRAG: Entitätsextraktion, Community-Zusammenfassungen und abfrageorientierte Synthese, lokal eingerichtet und um Kostenhinweise ergänzt. Sehen Sie das Video speziell zum Graph-RAG-Abschnitt des Artikels. Die Kostendiskussion ist der Teil, den die meisten Darstellungen auslassen.
Fortgeschritten 42 Minuten
Vertikale KI-Agenten könnten zehnmal größer werden als SaaS
Y Combinator. Die Lightcone-Moderatoren erläutern mit konkreten Beispielen, warum vertikale KI-Agenten anstelle horizontaler Wrapper Unternehmen auf der Anwendungsschicht einen dauerhafteren Wettbewerbsvorteil verschaffen könnten. Sie benennen außerdem nüchtern die Kategorien, die Modellanbieter voraussichtlich selbst übernehmen werden. Damit wird die Warnung des Artikels vor der Wrapper-Falle zu einem positiven Handlungsrahmen.
Fortgeschritten 34 Minuten
Wie KI Software-Geschäftsmodelle neu erfindet – mit Bret Taylor von Sierra
Sequoia Capital. Bret Taylor erläutert den Übergang von sitzplatzbasierter SaaS-Abrechnung zu ergebnisorientierter Preisgestaltung: geeignete Bezugsgrößen wie Falllösung, CSAT und NPS, die Schwierigkeiten etablierter Anbieter bei diesem Wandel und die Preissetzungsmacht vertikaler Spezialisierung. Das entspricht direkt den Abschnitten des Artikels zu Preisen und Margen.
Fortgeschritten 41 Minuten
OpenAI DevDay 2024 | Strukturierte Ausgaben für zuverlässige Anwendungen
OpenAI. Der Vortrag behandelt `strict: true`, den Unterschied zum früheren JSON-Modus, den Umgang mit Ablehnungen sowie das Zusammenspiel von Funktionsaufrufen und Schemata für Antwortformate. Er ist besonders nützlich, weil er den API-Vertrag beschreibt, auf dem die Produktionsmuster des Artikels aufbauen.
Fortgeschritten 18 Minuten
Pydantic ist alles, was Sie brauchen: Jason Liu
AI Engineer. Dieser Vortrag prägte das moderne Muster „Pydantic-Modell definieren, an das LLM übergeben und den Rest der Validierung überlassen“. Er zeigt konkrete Beispiele für verschachtelte Objekte, Validatoren, die halluzinierte URLs erkennen, und Gedankengänge als typisiertes Feld. Sehen Sie ihn sich vor dem erneuten Lesen des Artikelabschnitts über Validatoren an; dann wird deutlich, woher dessen Regeln für Wiederholungsversuche und Ablehnungen stammen.
Fortgeschritten 8 Minuten
Wharton-Professor: 4 Szenarien für die Zukunft der KI | Ethan Mollick für Big Think+
Big Think. Eine kompakte, 8-minütige Darstellung von Mollicks Modell der „vier Szenarien“, statisch, linear, exponentiell und AGI, sowie der Gründe, aus denen Teams für Szenario zwei oder drei planen sollten, statt alles auf eines der Extreme zu setzen. Das Video hilft einem Führungsteam, sich vor dem Schreiben des Playbooks darauf zu verständigen, worauf es sich tatsächlich vorbereitet.
Mittelstufe 60 Minuten
Diese KI-Strategie braucht jede Führungskraft | Ethan Mollick erklärt
Sana. Eine Stunde mit Mollick darüber, wie KI innerhalb von Organisationen tatsächlich eingesetzt wird, warum „Kosten senken“ der falsche Denkrahmen ist, warum sich traditionelle Organigramme verändern und was KI-native Teams anders machen. Die Aufrufzahl liegt unter der üblichen 100k-Marke. Dennoch ist dies das klarste Gespräch auf Praxisebene über Einführungsstrategien mit dem Forscher, der zu diesem Thema besonders häufig zitiert wird. Die Fragen des Artikels entsprechen nahezu 1:1 seiner Einordnung.
Mittelstufe