

 9 分钟阅读
DGX Spark:是什么、为谁而设,以及对本地智能体改变了什么
基于 NVIDIA 声明的能力、运维能力与数据边界,而非营销口号,决定 DGX Spark 是否适合你的私有智能体路线图。
高级私有/本地AI
24 个结果
没有符合这些筛选条件的内容尝试不同的类别或级别,或清除筛选条件以查看所有内容。
9 分钟阅读基于 NVIDIA 声明的能力、运维能力与数据边界,而非营销口号,决定 DGX Spark 是否适合你的私有智能体路线图。
 8 分钟阅读
设计切合实际的单节点 Spark 推理路径,包含内存预算、软件技术栈、故障模式,以及保留云端回退的明确标准。
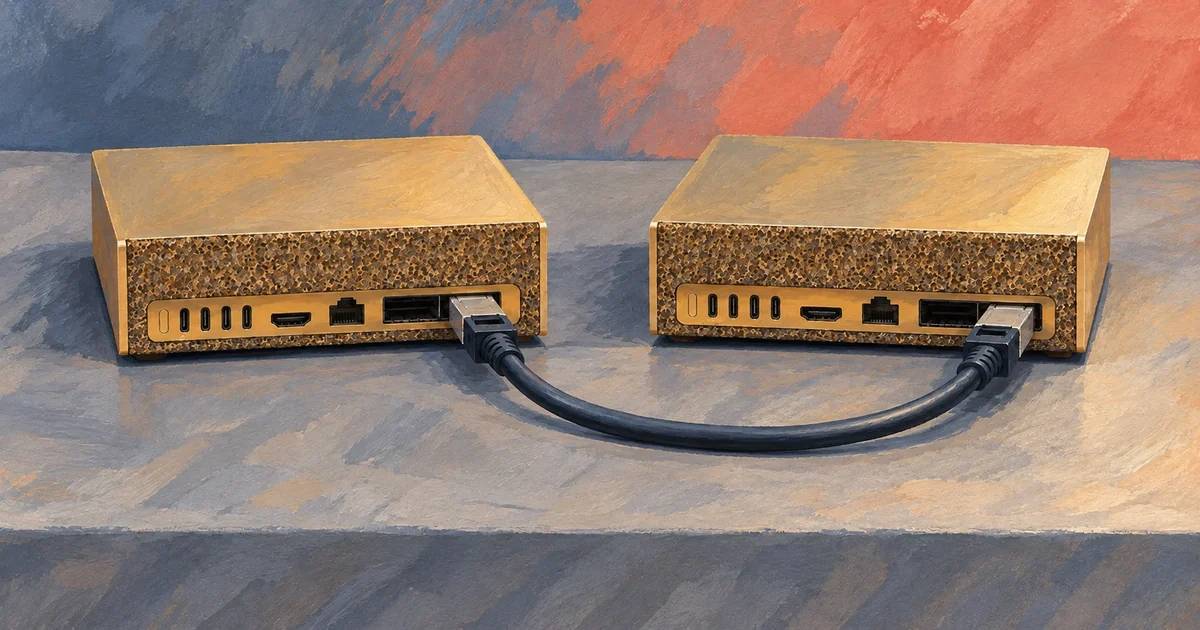 8 分钟阅读
按 NVIDIA 文档化的 QSFP/ConnectX-7 路径连接两台 DGX Spark,验证 SSH 与 RoCE 就绪,并知道如何安全回滚网络变更。
 10 分钟阅读
规划一次 DGX Spark 上的 NemoClaw 评估,理解当前上手流程和策略层,并明确使用真实数据或凭据前必须取得的执行证据。
 10 分钟阅读
在围绕实验性双 Spark DeepSeek-V4-Flash 服务路径设计 n8n 与 Hermes 工作流之前,评估该路径是否可行。
 12 分钟阅读
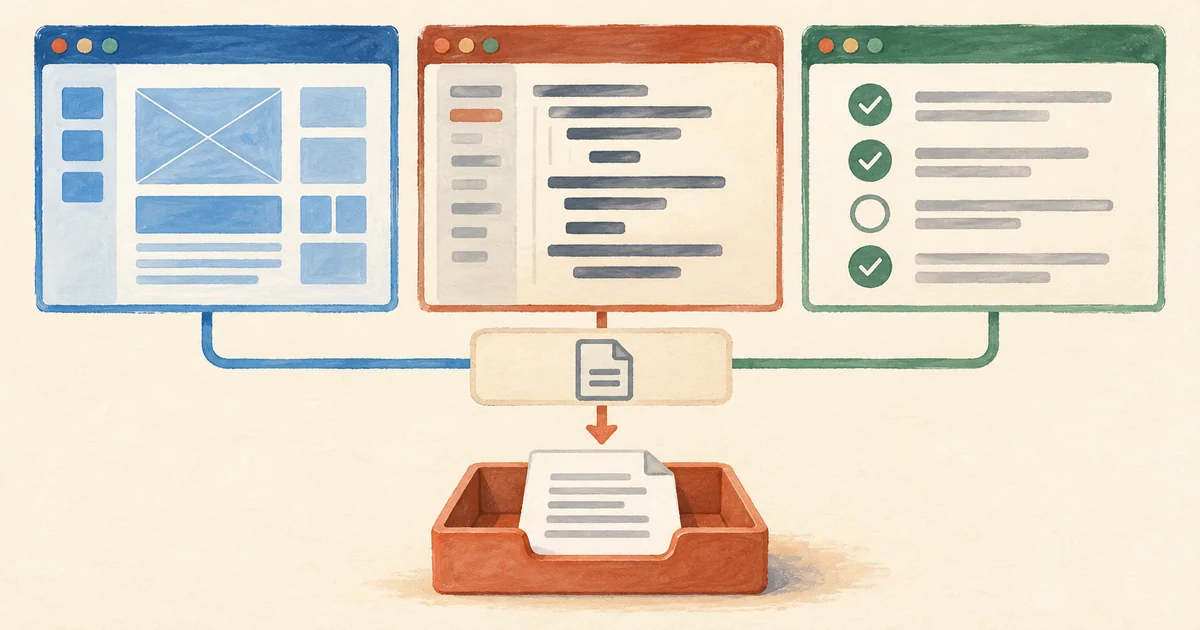
搭建一套可移植的 Codex + Claude Code + Cursor 工作流,让设计、评审和实现通过 Markdown 交接约定与 CLI 运行完成流转。
 15 分钟阅读
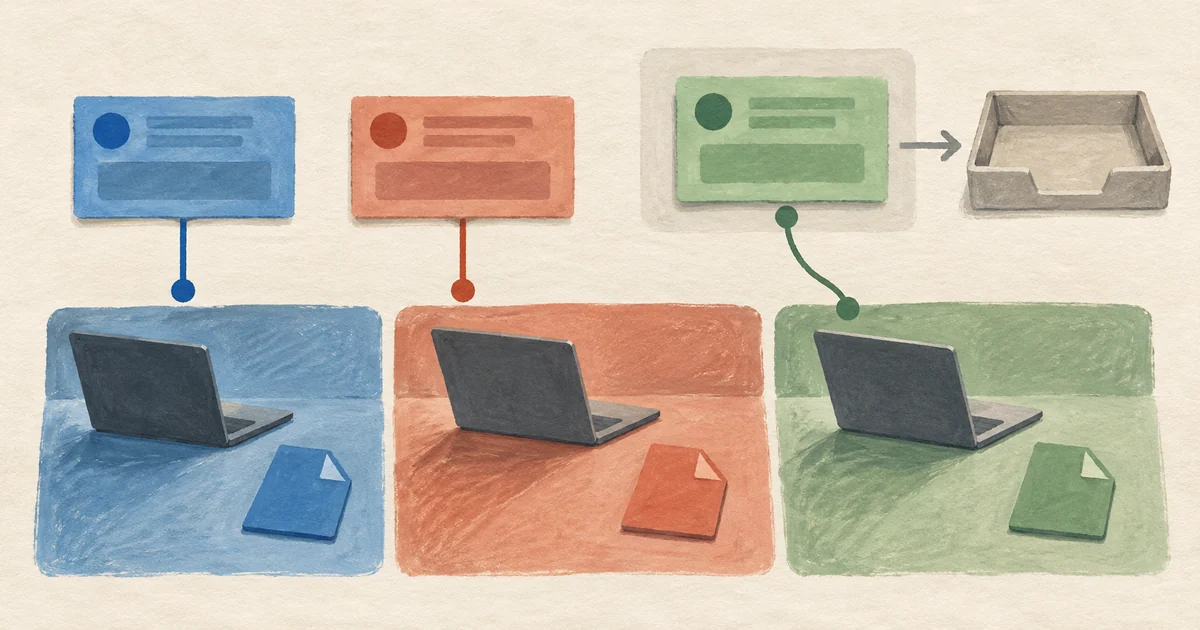
搭建由 Linear 支撑的多智能体编码工作流,让 Claude、Cursor 与 Codex 认领工单、并行工作、相互评审,并留下可审计的完成记录。
 11 分钟阅读
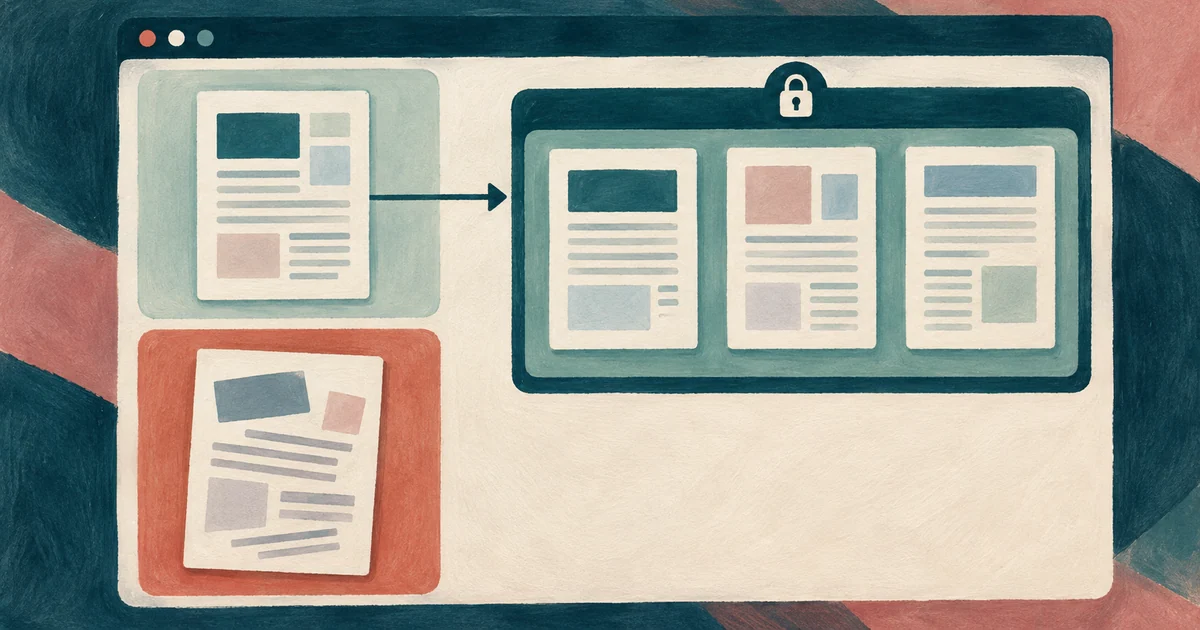
设计一条安全的 RAG 文档摄取流水线,涵盖权限元数据、OCR 质量检查、来源时效性、保留规则、删除行为和摄取测试。
 10 分钟阅读
建立一份生产AI失败模式清单,为幻觉、上下文过时、提示词注入、不安全的工具调用和薄弱的降级机制设置控制措施。
 10 分钟阅读
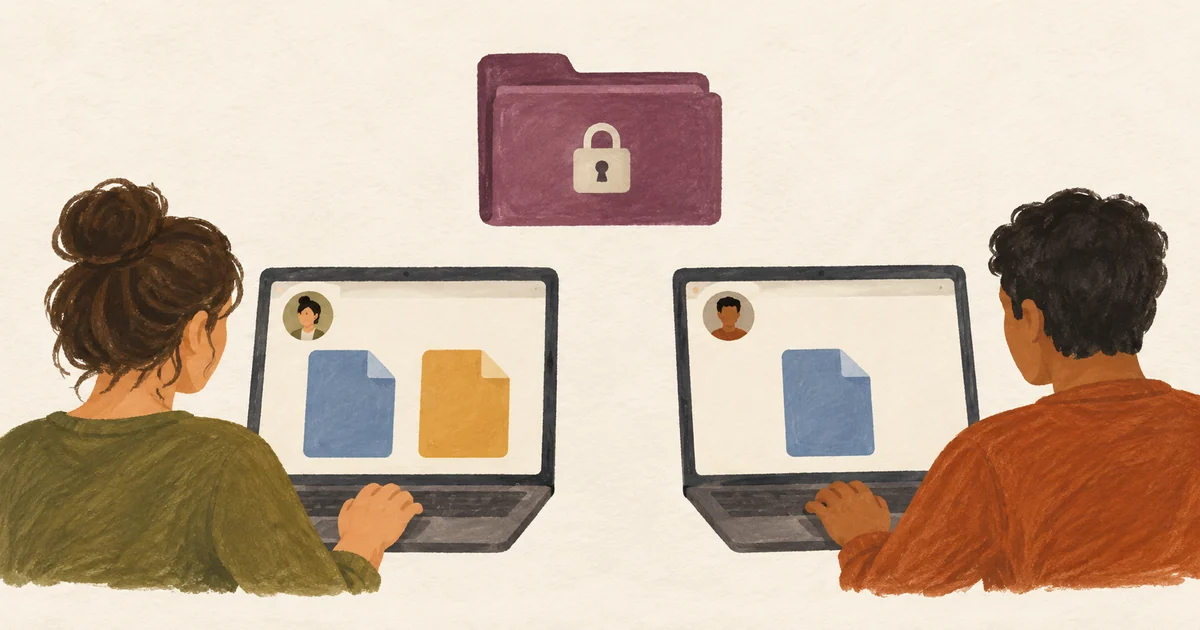
设计一个具备权限感知检索、来源责任归属、泄露控制和拒绝行为的企业知识RAG。
 9 分钟阅读
根据工作流适配、数据控制、成本、能力及战略价值,决定何时采购、配置、扩展或自研 AI 系统。
 9 分钟阅读
使用工作流投资回报率、质量、风险控制和成熟度等级衡量 AI 应用成效,而不是依赖工具使用量等虚荣指标。
 9 分钟阅读
判断客户语音智能体是否适用,并在首次实施时妥善设计披露、升级处理、测试和监控机制。
 10 分钟阅读
根据数据敏感性、能力需求、成本、延迟和运营能力选择私有 AI 部署模式。
 9 分钟阅读
设计一种感知代码仓库的AI编码工作流,在不削弱评审、安全、测试或责任归属的前提下提高交付速度。
 12 分钟阅读
分离系统、开发者和用户指令,并将生产提示作为有版本的系统组件进行测试。
 12 分钟阅读
在常规可观测性基础上,增加多步骤追踪、可归因成本、提示词与模型版本、经过评估的质量信号、隐私控制,以及根据工作负载制定的告警。
 12 分钟阅读
我们看到的大多数MCP工具在技术上正确,在实践中却毫无用处。LLM会忽略、误用,或以无益的方式调用它们。本文介绍让LLM自然采用工具的设计原则,并给出常见失败及其修复示例。
 12 分钟阅读
提示词、RAG和微调是让LLM适应你的问题的三大手段。它们各有适用和不适用的问题。本文提供选择框架、各自的实际成本,以及组合使用时效果突出的生产模式。
 13 分钟阅读
判断参数高效微调是否合理,治理数据,固定可复现实验,对比留出集与安全结果,并在部署前对服务性能做基准测试。
 12 分钟阅读
长期运行的智能体需要一套责任明确的持久化设计,涵盖来源、确认、租户隔离、检索测试、保留、更正和可验证删除。
 14 分钟阅读
为大语言模型工作流建立威胁模型,并针对不可信内容、检索、工具调用、授权、监控和事件响应落实具体控制措施。
 12 分钟阅读
基于追踪数据建立推理成本模型,优化实测成本中占比最大的部分,并证明每项改动都不会损害任务质量。
 11 分钟阅读
自托管要达到什么规模才会比 API 调用更划算?本文介绍实际计算、运维现实,以及区分哪些团队应该自托管、哪些团队应该继续为托管推理付费的模式。