

 9 分の読書
DGX Sparkとは何か:誰に向き、ローカルエージェントをどう変えたのか
マーケティングスローガンではなく、NVIDIAが公表する機能、組織の運用能力、データ境界に基づいて、DGX Sparkがプライベートエージェントのロードマップに適するかを判断します。
上級者プライベート/ローカルAI
24件の結果
フィルターに一致するものがありませんカテゴリやレベルを変更するか、フィルターをクリアしてすべてのコンテンツを表示してください。
9 分の読書マーケティングスローガンではなく、NVIDIAが公表する機能、組織の運用能力、データ境界に基づいて、DGX Sparkがプライベートエージェントのロードマップに適するかを判断します。
 8 分の読書
メモリー予算、ソフトウェアスタック、障害モード、クラウドへのフォールバックを残す明確な基準を含む、現実的な単一ノードSpark推論経路を設計します。
 8 分の読書
NVIDIAが文書化したQSFP/ConnectX-7経路で2台のDGX Sparkを接続し、SSHとRoCEの準備状況を確認して、ネットワーク変更を安全にロールバックする方法を身に付けます。
 10 分の読書
DGX Spark上でのNemoClaw評価を計画し、現行のオンボーディングとポリシー層を理解したうえで、実データや認証情報を使用する前に必要な実行証拠を定義します。
 10 分の読書
n8nとHermesのワークフローを設計する前に、2台のSparkでDeepSeek-V4-Flashをサーブする実験的な経路が実行可能かを評価します。
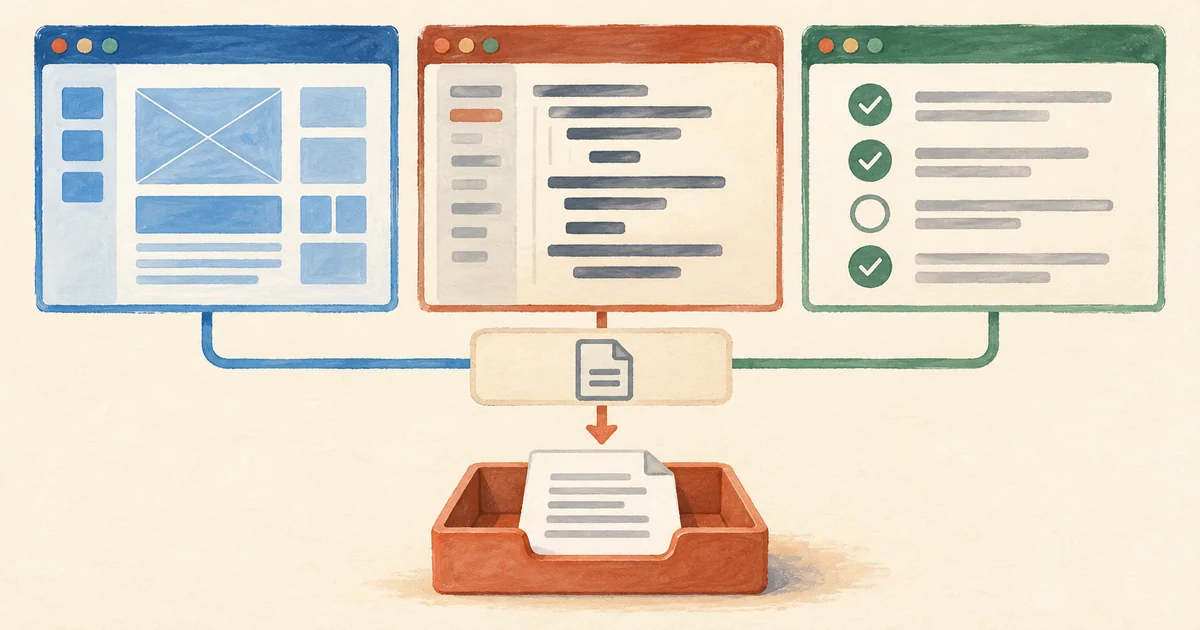 12 分の読書
設計、レビュー、実装がmarkdownの契約とCLI実行で受け渡される、移植可能なCodex + Claude Code + Cursorのワークフローを構築できるようになります。
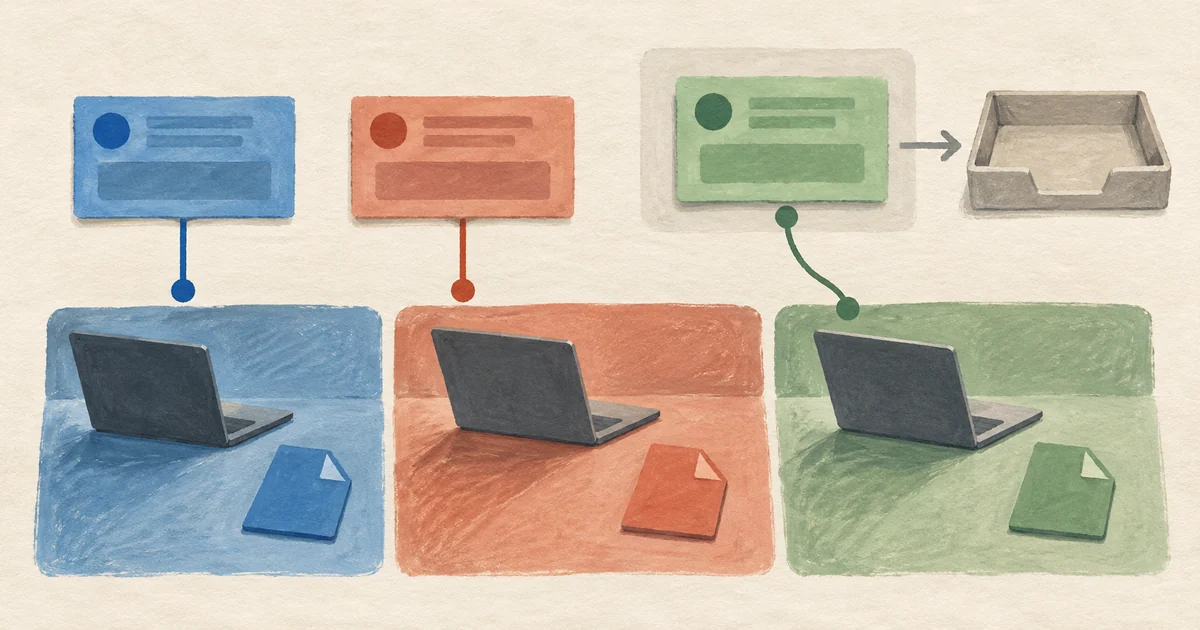 15 分の読書
Claude、Cursor、CodexがIssueの担当を宣言し、並列に作業し、相互レビューを行い、監査可能な記録を残して作業を完了する、Linearベースのマルチエージェント開発ワークフローを構築します。
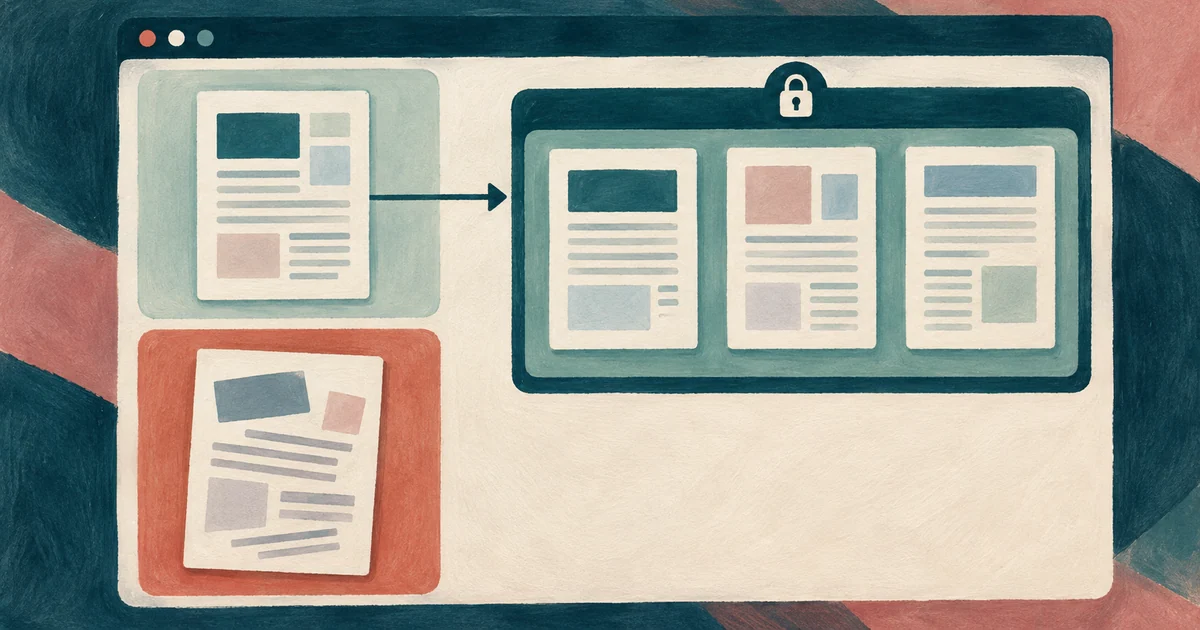 11 分の読書
権限メタデータ、OCRの品質確認、情報源の鮮度、保持ルール、削除時の挙動、取り込みテストを備えた、RAG向けの安全な文書取り込みパイプラインを設計します。
 10 分の読書
ハルシネーション、古いコンテキスト、プロンプトインジェクション、危険なツール実行、弱いフォールバックに対する制御を含む、本番AIの失敗モード台帳を作成する。
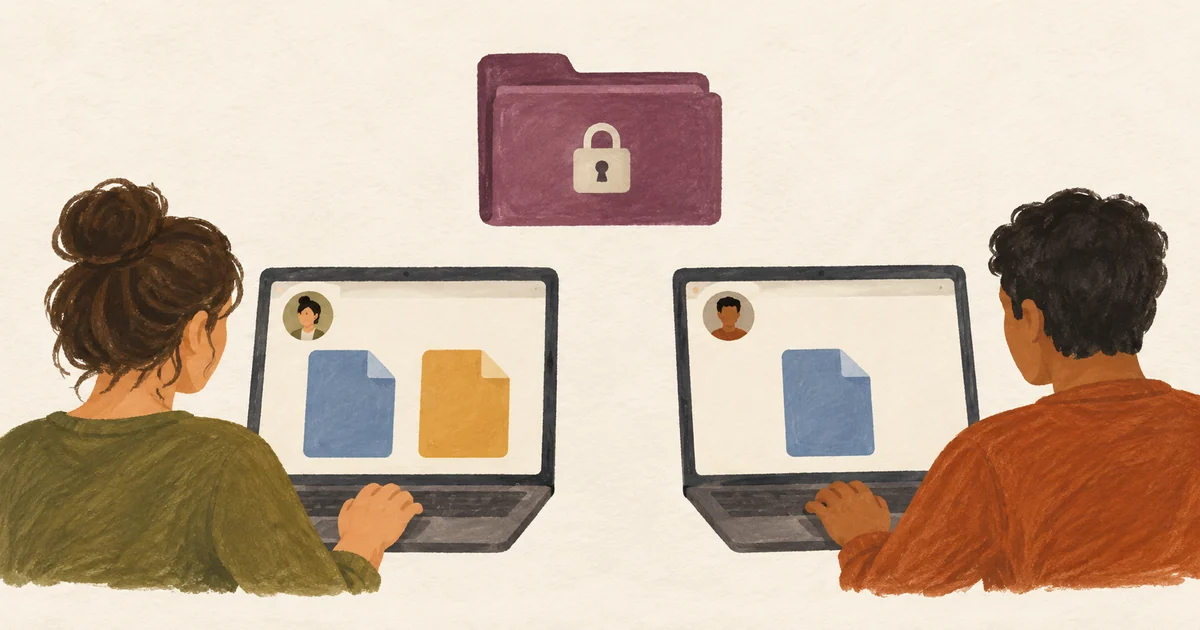 10 分の読書
権限を認識する検索、情報源のオーナーシップ、漏えい対策、回答拒否の挙動を備えた社内ナレッジRAGを設計します。
 9 分の読書
ワークフローへの適合性、データの管理、コスト、機能、戦略的価値に基づいて、AIシステムを購入するか、設定するか、拡張するか、構築するかを判断します。
 9 分の読書
見栄えだけのツール利用指標ではなく、ワークフローのROI、品質、リスク統制、成熟度によってAI導入を測ります。
 9 分の読書
顧客向け音声エージェントが適切かどうかを判断し、開示、エスカレーション、テスト、モニタリングを備えた最初の導入を設計できるようになります。
 10 分の読書
データの機微性、必要な機能、コスト、レイテンシー、運用能力に基づいて、プライベートAIの導入パターンを選べるようになります。
 9 分の読書
レビュー、セキュリティ、テスト、オーナーシップを弱めることなく、開発速度を向上させる、リポジトリを認識するAIコーディングワークフローを設計します。
 12 分の読書
system、developer、userの指示を分離し、本番プロンプトをバージョン管理されたシステムコンポーネントとしてテストする。
 12 分の読書
複数ステップのトレース、帰属可能なコスト、プロンプトとモデルのバージョン、評価に基づく品質シグナル、プライバシー管理、ワークロード実績に基づくアラートによって、通常の可観測性をLLM向けに拡張します。
 12 分の読書
私たちが目にするMCPツールの多くは、技術的には正しくても実用上は役に立ちません。LLMはツールを無視したり、誤用したり、役に立たない方法で呼び出したりします。LLMが自然に採用できるツールを設計する原則を、よくある失敗と修正の例を交えて説明します。
 12 分の読書
プロンプティング、RAG、ファインチューニングは、LLMを課題に適応させるための3つの大きな手段です。それぞれに適した課題と適さない課題があります。選択のためのフレームワーク、各手法の現実的なコスト、そして組み合わせることで効果を発揮する本番パターンを解説します。
 13 分の読書
パラメーター効率の高いチューニングが妥当かを判断し、データを統制し、再現可能な実験を固定し、ホールドアウトと安全性の結果を比較し、導入前に推論提供を測定します。
 12 分の読書
長期実行エージェントには、自ら責任を持つ永続化設計が必要です。出所、確認、テナント分離、検索テスト、保持、修正、検証可能な削除までを設計します。
 14 分の読書
LLMワークフローの脅威をモデル化し、信頼できないコンテンツ、検索、ツール呼び出し、認可、監視、インシデント対応に具体的な制御を追加できるようにします。
 12 分の読書
トレースに基づく推論コストモデルを構築し、実測で最大の費用要因を最適化し、各変更がタスク品質を維持していることを示します。
 11 分の読書
どの程度の規模になれば、自社運用がAPI利用より有利になるのでしょうか。実際のコスト計算と運用上の現実を踏まえ、自社運用に向くチームとマネージド推論を使い続けるべきチームの違いを解説します。