

 9 minutos
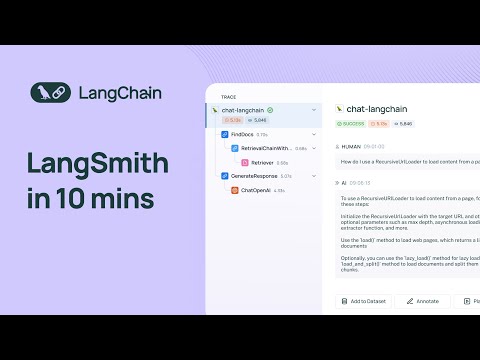
LangSmith en 10 minutos
Podrás navegar por trazas, proyectos y conjuntos de datos en LangSmith, y consultar el coste en tokens, la latencia, la tasa de errores y el detalle de cada span.
AvanzadoIA para empresas
Dave Ebbelaar. Un ingeniero de IA en activo recorre su escala real de evaluaciones: pruebas unitarias de tipo assert, métricas sin referencia, alineación del LLM como juez con el criterio humano y el ciclo de analizar, medir y mejorar. Es la estructura audiovisual que más se aproxima al argumento del artículo: las evaluaciones forman un sistema para detectar regresiones, no una clasificación.
Algunas herramientas quedarán obsoletas, pero la escala es sólida: primero comprobaciones deterministas y después comprobaciones calificadas por modelos y validadas frente a personas. No omitas la calibración solo porque resulte fácil añadir un LLM juez.
Diseñarás una escala de evaluaciones que detecte regresiones antes de que los cambios en los prompts o los modelos lleguen a los usuarios.
Experiencia implementando o manteniendo un flujo de trabajo de IA con ejemplos de fallos conocidos.
Última revisión: 18 may 2026
Continúa por el mismo itinerario de aprendizaje con los siguientes vídeos complementarios seleccionados.
9 minutosPodrás navegar por trazas, proyectos y conjuntos de datos en LangSmith, y consultar el coste en tokens, la latencia, la tasa de errores y el detalle de cada span.
 75 minutos
Crearás tu primer servidor MCP y comprenderás cómo encajan las herramientas, los esquemas, los prompts, los recursos y los transportes.
 19 minutos
Mejorarás el diseño de las herramientas para que los agentes elijan la acción correcta con los parámetros adecuados.
Cursos externos seleccionados para profundizar en este tema.
 Coursera · Emory University
Emory University Goizueta Business School faculty
The deeper, university-level counterpart to our beginner HubSpot marketing pick — Emory's business-school treatment goes past 'how to prompt' into training generative models for brand-specific output, the purchase-funnel economics of AI-generated content, and a full module of genuine skepticism about when generative AI is and isn't worth using in marketing.
 Coursera · IBM
IBM AI Academy
La respuesta de la era de la IA generativa a la cuestión de la estrategia ejecutiva. Tres cursos breves dirigidos específicamente a líderes empresariales —sin necesidad de formación técnica— sobre dónde crea valor la IA generativa, cómo gobernarla de manera responsable y cómo convertir un vago "deberíamos usar IA" en un caso de uso concreto y defendible. Tiene una valoración de 4.6 basada en ~700 reseñas. Conviene cursarla antes de tomar la próxima decisión presupuestaria sobre IA.