Vidéos complémentaires

Ingénierie du contexte : gérer des fenêtres d'un million de tokens sans dégradation — vidéos complémentaires

L'article examine l'écart entre « le modèle accepte un million de tokens » et « le modèle exploite un million de tokens de manière fiable ». Il présente les modes de défaillance, les quatre leviers de l'ingénierie du contexte — écrire, sélectionner, compresser et isoler — ainsi que les budgets qui permettent aux sessions de longue durée de rester efficaces. Ces deux vidéos exposent, dans cet ordre, le problème puis les solutions avec une clarté remarquable.

Choix principal

7:56
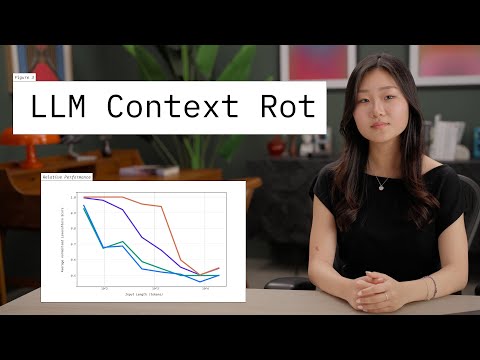
Dégradation du contexte : Comment l'augmentation des tokens d'entrée affecte les performances des grands modèles de langage

Chroma

Kelly Hong présente les recherches de Chroma sur 18 modèles : pourquoi les scores aux tests de « l'aiguille dans une botte de foin » sont trompeurs, comment les performances diminuent face à l'ambiguïté et aux éléments parasites, et pourquoi même de simples tâches de répétition de chaînes se dégradent au-delà de 500 tokens. Courte et étayée par des données, cette vidéo montre précisément le risque qu'il faut prendre au sérieux avant d'aborder les solutions techniques de l'article.

Ce que vous en retirerez: Comprendre comment le contexte long peut échouer en présence d'ambiguïté et d'éléments perturbateurs, puis concevoir des tests autour de ce risque.

À voir ou à connaître au préalable: Seul le vocabulaire de base des grands modèles de langage est nécessaire ; il s'agit d'une brève présentation de recherche.

Note d’AI Expert: Les modèles, leurs tarifs et leurs capacités évoluent rapidement. Retenez ici la méthode de décision, puis vérifiez le comportement des modèles actuels avant de l'adopter.
Ouvrir la page vidéo

À voir également

22:06
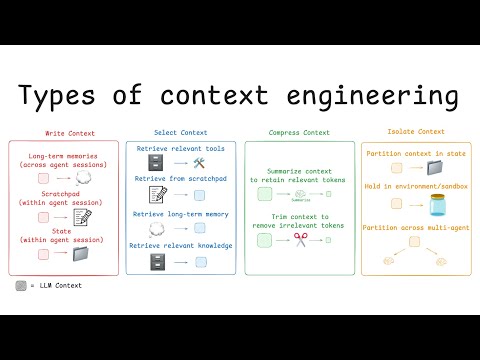
Ingénierie du contexte pour les agents

LangChain

Lance Martin présente le cadre « écrire, sélectionner, compresser, isoler », avec des exemples concrets : quand résumer l'historique des actions, quand externaliser l'état dans des fichiers et quand lancer des sous-agents uniquement pour préserver le contexte de l'agent parent. Cette approche correspond presque directement à la section de l'article consacrée à la gestion pratique des fenêtres d'un million de tokens.

Ce que vous en retirerez: Appliquer les modèles d'écriture, de sélection, de compression et d'isolement pour gérer délibérément le contexte des agents.

À voir ou à connaître au préalable: Expérience de la conception ou de l'exploitation d'agents dotés d'un contexte de longue durée.

Note d’AI Expert: Les modèles, leurs tarifs et leurs capacités évoluent rapidement. Retenez ici la méthode de décision, puis vérifiez le comportement des modèles actuels avant de l'adopter.

Ouvrir la page vidéo