

LLM-applikationer i produktion
Design, udrul, overvåg og driv LLM-applikationer efter demonstrationsfasen.
17 historier (12 artikler · 5 videoer)
Start her
Et par gode steder at begynde, før du går på opdagelse i hele oversigten.
 12 min læsning
Design af produktionsprompts: system-, udvikler- og brugerlag
Et styringsmønster til at adskille betroede instruktioner, runtime-data og brugerinput og derefter versionere, evaluere, udrulle og observere prompts efter risiko.
Avanceret 10 min læsning
Fejltilstande i AI-produktion: det, der går i stykker efter demoen
AI-systemer fejler som regel på forudsigelige måder: hallucinationer, forældet kontekst, medløberi, prompt injection, usikker værktøjsbrug, skemadrift og svage fallbacks. Et register over fejltilstande til teams, der sætter reelle workflows i produktion.
AvanceretFlere i dette emne
 8 min læsning
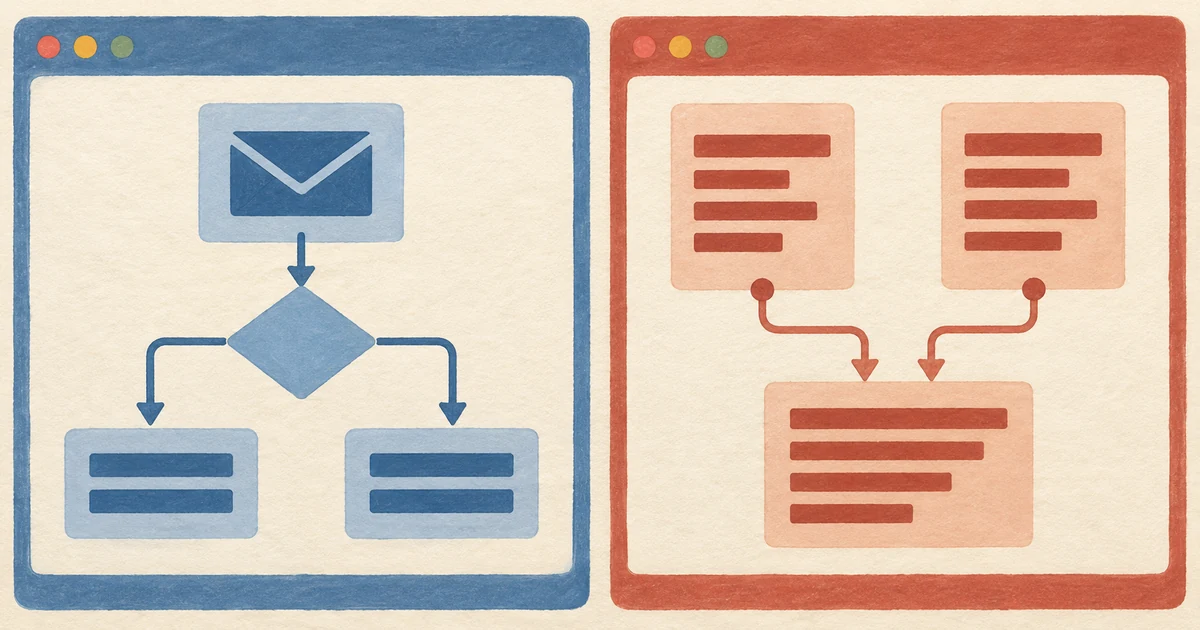
Hermes vs n8n: vælg efter opgaven (og hvornår du skal bruge begge)
En beslutningsramme for Hermes Agent over for n8n: Deterministisk integrationslogik bliver i n8n, mens et Hermes-API-trin med bearer-autentificering eller et særskilt forløb for hændelseswebhooks håndterer afgrænset agentarbejde.
Let øvet 10 min læsning
Eksperimentel stak med to DGX Spark-enheder, DeepSeek-V4-Flash, n8n og Hermes
Sådan evaluerer du en eksperimentel fællesskabsudviklet løsning med to DGX Spark-systemer til DeepSeek-V4-Flash, hvor n8n håndterer den deterministiske del og Hermes vurderingsopgaverne.
Avanceret 69 minutter
Agentlandskabet – erfaringer fra at sætte agenter i produktion
MLOps.community. Prosus' VP of AI og en AI-ingeniør rapporterer, hvad der faktisk brød, da de deployede agenter på tværs af gruppens porteføljevirksomheder: promptinjektion-pentest før launch, en usikker write, da en Jira-agent fejlede på menneskelig stenografi, forældet kontekst håndteret ved at få agenter til at synliggøre deres antagelser, og fallback-design, der merged eller dræbte agenter, når de tilføjede cognitive load. Det læser som artiklens fejltilstandsregister genafspillet som en live postmortem.
Avanceret 12 min læsning
Optimer inferensomkostninger: cachelagring af prompts, styring af modelvalg og kontrol af output
Byg en sporingsbaseret omkostningsmodel for inferens, optimér de største målte omkostningsposter, og dokumentér, at hver ændring bevarer opgavekvaliteten.
Avanceret 13 min læsning
Finjustering i 2026: et LoRA- og QLoRA-eksperiment med dokumentationen i centrum
Afgør, om parametereffektiv finjustering er berettiget, styr dataene, fastlås et reproducerbart eksperiment, sammenlign resultater på et adskilt testsæt og i sikkerhedstests, og mål modeldriften før idriftsættelse.
Avanceret 12 min læsning
Design MCP-værktøjer, som LLM'er faktisk bruger korrekt
De fleste MCP-værktøjer, vi ser, er teknisk korrekte, men praktisk talt ubrugelige. LLM'er ignorerer dem, bruger dem forkert eller foretager unødvendige kald. Her er principperne for at designe værktøjer, som LLM'er tager naturligt i brug, med eksempler på almindelige fejl og løsninger.
Avanceret 12 min læsning
Byg hukommelse til agenter med langvarige forløb
Agenter med langvarige forløb kræver et persistensdesign med en tydelig ejer: dokumenteret oprindelse, bekræftelse, isolering mellem lejere, test af søgning, regler for opbevaring, rettelse og verificerbar sletning.
Avanceret 10 min læsning
Orkestrering af flere modeller: routing efter omkostninger, latenstid og kvalitet
Routing af forskellige opgaver til forskellige modeller kan reducere omkostninger eller latenstid, men kun evaluering af den konkrete arbejdsbelastning kan vise, om den ekstra kompleksitet betaler sig. Her er mønstrene, målingerne og fejltilstandene.
Let øvet 12 min læsning
Observerbarhed i LLM-applikationer: sporing, omkostninger, svartid og kvalitetsændringer
Udvid almindelig observerbarhed med flertrinsspor, henførbare omkostninger, prompt- og modelversioner, evaluerede kvalitetssignaler, databeskyttelseskontroller og advarsler baseret på arbejdsbelastningen.
Avanceret 14 min læsning
Promptinjektion og LLM-sikkerhed: trusselsmodeller og forsvar i dybden
Promptinjektion er en permanent klasse af LLM-sikkerhedsrisici, ikke en fejl i promptformuleringen. En produktionsguide til trusselsmodeller, datagrænser, værktøjsrettigheder, regressionstest, overvågning og hændelseshåndtering.
Avanceret 12 min læsning
Vælg mellem prompting, RAG og finjustering (og hvornår de skal kombineres)
Prompting, RAG og finjustering er de tre store greb til at tilpasse LLM'er til dit problem. De passer hver især til nogle problemer og ikke til andre. Her er en ramme for valget, de realistiske omkostninger og de produktionsmønstre, hvor kombinationen virker bedst.
Avanceret 9 minutter
LangSmith på 10 minutter
LangChain. En guidet tour af en LLM-trace, project og dataset af LangChains medstifter — token-omkostning, latenstid, fejlrate, feedback-aggregering, drill-down i et enkelt retrieval-step-span. Det er den nærmeste visuelle analog til det, artiklen beskriver, når den taler om "hvert kald er et span", og hvorfor strukturerede traces slår print-logging.
Avanceret 154 minutter
Instrumentering og evaluering af LLM'er
Hamel Husain. Hamel Husain, Eugene Yan, Brian Bischof, Harrison Chase og Shreya Shankar arbejder sig igennem tracing, loganalyse, LLM-as-judge og arbejdsgangen omkring at se på rigtige produktionsdata. Sid med den på samme måde, som du ville med en lang podcast — det er den bedste dybe behandling af artiklens tese "se på dine traces" på YouTube.
Avanceret 77 minutter
AI prompt engineering: En dybdegående gennemgang
Anthropic. Fire Anthropic prompt engineers (research, alignment, applied, developer relations) taler længe om, hvad de faktisk gør til daglig — hvordan de redigerer prompts under pres, hvordan de tænker om "honesty" i instruktioner, hvornår XML-scaffolds hjælper, hvornår de ikke gør. Artiklens lagdelte model mapper rent over på, hvordan de beskriver arbejdet; dette er den bedste måde at høre den mentale model højt.
Avanceret 25 minutter
Prompting 101 | Code med Claude
Anthropic. En live-bygningssession af Anthropics Applied AI-team på en forsikringsclaims-prompt — de starter med en vag instruktion og itererer til noget, en udvikler faktisk ville shippe, og viser den slags revisioner, artiklen beskriver for system- og developer-lagene. Se den, før du genlæser artiklens tjekliste om eksempler, outputstruktur og refusal-håndtering.
Avanceret