

コストとモデル運用
推論コストを管理し、ホスティング方式を選び、モデルをルーティングし、運用上のトレードオフを理解します。
9件のコンテンツ (記事4件 · 動画5件)
ここから開始
一覧を見る前に、まずおすすめのコンテンツをいくつかご覧ください。
 10 分の読書
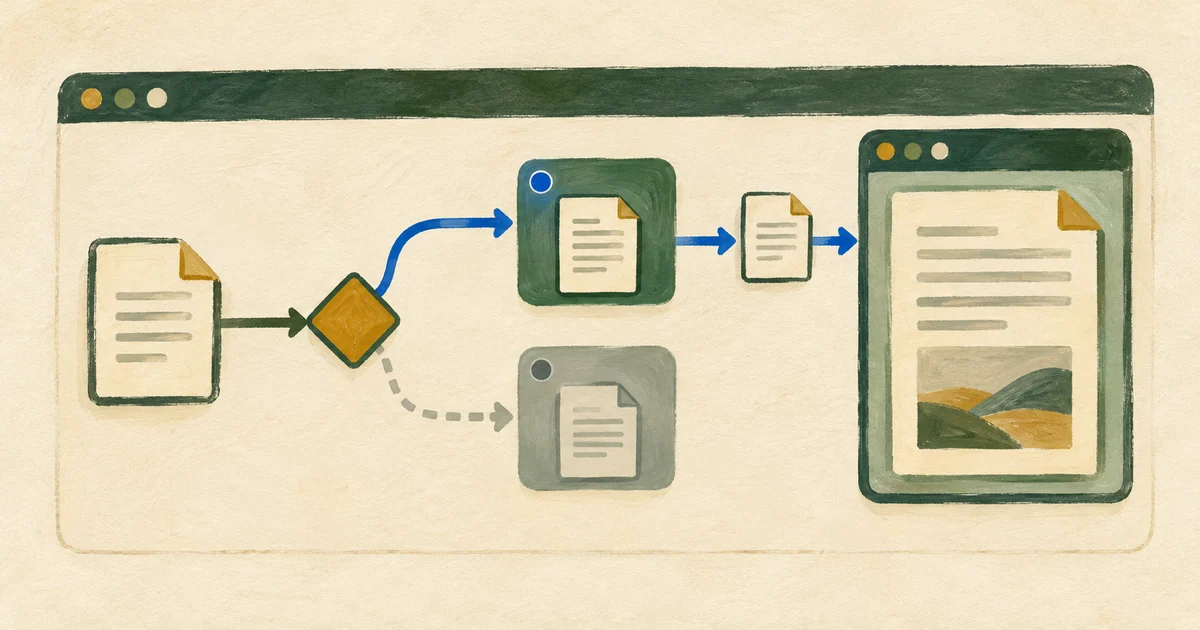
マルチモデルオーケストレーション:コスト、レイテンシ、品質で振り分ける
タスクごとにモデルを使い分けると、コストやレイテンシを抑えられる場合があります。ただし、複雑な仕組みに見合う効果があるかは、実際のワークロードに即した評価でしか判断できません。設計パターン、測定方法、障害時の挙動を解説します。
中級者 12 分の読書
推論コストを最適化する:プロンプトキャッシング、ルーティング、出力制御
トレースに基づく推論コストモデルを構築し、実測で最大の費用要因を最適化し、各変更がタスク品質を維持していることを示します。
上級者 11 分の読書
自社運用とマネージド推論:監査可能な損益分岐点モデル
どの程度の規模になれば、自社運用がAPI利用より有利になるのでしょうか。実際のコスト計算と運用上の現実を踏まえ、自社運用に向くチームとマネージド推論を使い続けるべきチームの違いを解説します。
上級者このトピックの他の記事
 6 分の読書
無料版と有料版のChatGPT:アップグレードで実際に得られるもの
無料版ChatGPT、ChatGPT Plus、ChatGPT Proを専門用語なしで比較します。アップグレードで何が変わり、本当に必要かどうかを見極める方法を解説します。
AI初心者 19 分
RAGは終わるのか?Anthropicの新しいプロンプトキャッシュ
Prompt Engineering. AnthropicのプロンプトキャッシュとGeminiのコンテキストキャッシュを、ユースケースごとの具体的なレイテンシーとコストの削減効果(長文ドキュメントのチャット、few-shot、複数ターン)を示しながら解説します。キャッシュ書き込み時の追加料金とキャッシュ読み取り時の割引を分けて考える説明は、記事がキャッシュの採算性を論じる際に前提としている内容そのものです。
上級者 56 分
Build Hour:プロンプトキャッシュ
OpenAI. OpenAI自身によるプロンプトキャッシュのBuild Hourです。1024トークンのしきい値、プレフィックスを安定させる要件、リアルタイム処理における音声キャッシュの大幅な割引(正確な割引率は最新の料金ページを確認してください)、長い入力が最初のトークンを得るまでの時間に与える影響を扱います。本番環境のプロンプトで確実にキャッシュを利用するための工数を見積もる際に役立ちます。
上級者 19 分
すべてのAIモデルを解説
Tina Huang. 現在のモデルをフラッグシップ、軽量、中間、特化型という階層に分け、各階層が実際に得意とする用途を具体的に紹介しています。記事の前半にあたる「ルーティングの前に選択肢を知る」ための動画です。Huangはベンチマークの誇張に頼らず、記事と同じ視点からコストと能力のバランスを説明しています。
中級者 9 分
RouteLLM:GPT-4oの90%の品質を80%低いコストで実現
Matthew Berman. LMSYSのRouteLLM論文とコードを解説します。高性能モデルと低性能モデルの組み合わせの前段に小さな分類器を置き、どちらを呼び出すか決定することで、わずかなコストで高性能モデルのおよそ95%の品質を達成します。視聴回数は通常の基準である100Kを下回りますが、「モデル比較だけでなく実際のモデルルーティングを見たい」というニッチな要望に対してYouTubeで最も分かりやすい解説であり、記事の品質とコストのトレードオフに直接対応しています。
中級者 32 分
vLLMとPagedAttentionによる高速なLLM推論配信
Anyscale. 動画はGPUメモリの60–80%が無駄になる例、PagedAttention、バッチ処理を説明します。品質をそろえた記事の費用モデルの参考にし、自分のワークロードで処理能力と稼働率を測定してください。
上級者