

Applications LLM en production
Concevez, déployez, observez et exploitez des applications LLM au-delà de la démonstration.
17 contenus (12 articles · 5 vidéos)
Commencez ici
Quelques bons contenus pour débuter avant de parcourir l’ensemble du flux.
 12 min de lecture
Conception de prompts en production : couches système, développeur et utilisateur
Un modèle de gouvernance pour séparer les instructions fiables, les données d'exécution et l'entrée utilisateur, puis versionner, évaluer, déployer et observer les prompts en fonction du risque.
Avancé 10 min de lecture
Modes de défaillance de l'IA en production : ce qui échoue après la démonstration
Les systèmes d'IA échouent généralement de manière prévisible : hallucinations, contexte obsolète, complaisance, injection de consignes, usage non sûr des outils, dérive de schéma et mécanismes de repli insuffisants. Voici un registre des modes de défaillance pour les équipes qui mettent de véritables processus en production.
AvancéPlus de contenus sur ce thème
 8 min de lecture
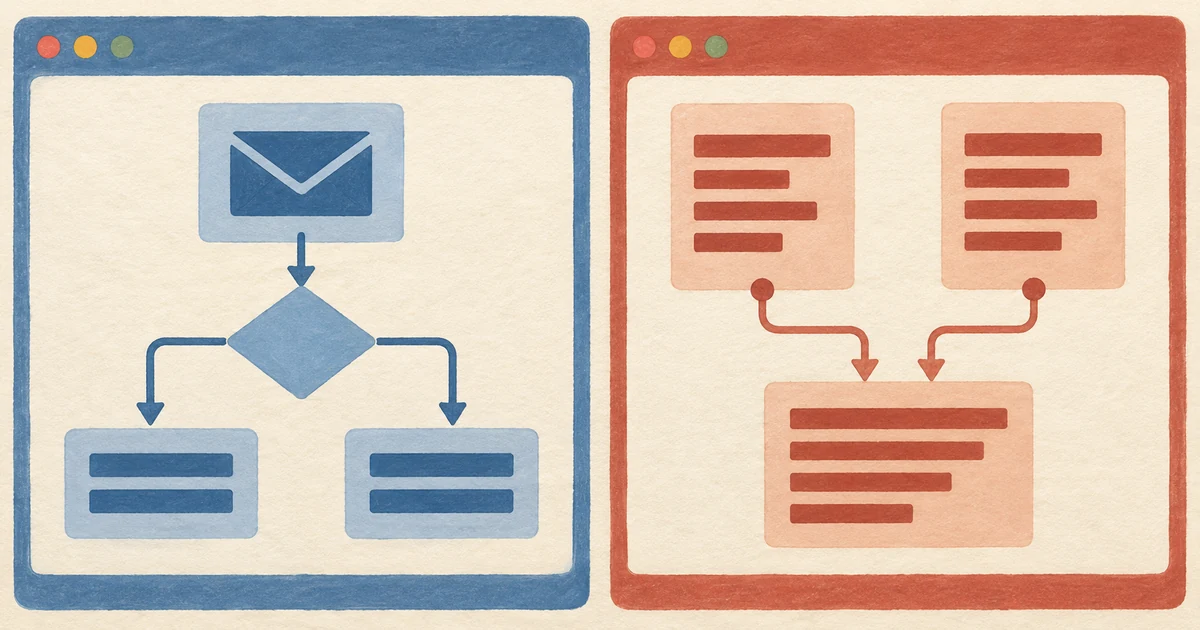
Hermes ou n8n : choisissez selon la tâche (et quand utiliser les deux)
Un cadre de décision pour Hermes Agent et n8n : la plomberie déterministe reste dans n8n, tandis qu’une étape de l’API Hermes authentifiée par jeton bearer ou un parcours webhook d’événements distinct prend en charge le travail d’agent délimité.
Intermédiaire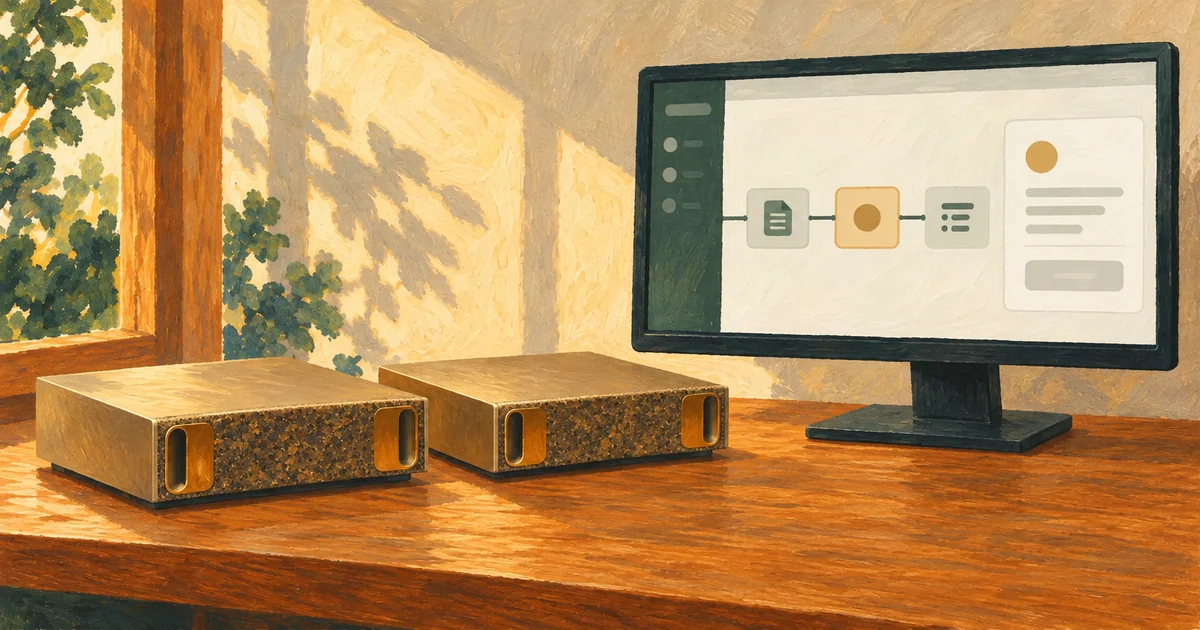 10 min de lecture
Architecture expérimentale : deux DGX Spark, DeepSeek-V4-Flash, n8n et Hermes
Comment évaluer une solution communautaire expérimentale qui exécute DeepSeek-V4-Flash sur deux DGX Spark, avec n8n pour les opérations déterministes et Hermes pour les tâches qui exigent du jugement.
Avancé 69 minutes
Le paysage des agents – enseignements tirés de leur mise en production
MLOps.community. Le vice-président chargé de l'IA chez Prosus et un ingénieur en IA expliquent ce qui a réellement échoué lors du déploiement d'agents dans les entreprises du portefeuille du groupe : tests d'intrusion ciblant l'injection de prompt avant le lancement, écriture dangereuse lorsqu'un agent Jira a mal interprété une abréviation humaine, contexte périmé compensé en obligeant les agents à expliciter leurs hypothèses, et mécanismes de repli consistant à fusionner ou supprimer des agents devenus une source de charge cognitive. C'est presque le registre des défaillances de l'article rejoué sous la forme d'un retour d'incident en direct.
Avancé 12 min de lecture
Optimiser les coûts d’inférence : cache des prompts, routage et contrôle des sorties
Élaborez un modèle des coûts d’inférence à partir des traces, optimisez les postes mesurés les plus importants et démontrez que chaque modification préserve la qualité de la tâche.
Avancé 13 min de lecture
Ajustement fin en 2026 : une expérience fondée sur les preuves autour de LoRA et QLoRA
Décidez si l’ajustement fin efficace en paramètres est justifié, gouvernez les données, figez une expérience reproductible, comparez les résultats sur les données de test et ceux liés à la sécurité, puis effectuez un benchmark du déploiement avant la mise en production.
Avancé 12 min de lecture
Concevoir des outils MCP que les LLM utilisent réellement correctement
La plupart des outils MCP que nous rencontrons sont techniquement corrects, mais pratiquement inutiles. Les LLM les ignorent, les utilisent mal ou les appellent sans discernement. Voici les principes permettant de concevoir des outils qu’ils adoptent naturellement, avec des exemples d’erreurs courantes et leurs corrections.
Avancé 12 min de lecture
Construire la mémoire pour les agents à longue durée de vie
Les agents à longue durée de vie nécessitent une conception de persistance maîtrisée : provenance, confirmation, isolation par locataire, tests de récupération, conservation, correction et suppression vérifiable.
Avancé 10 min de lecture
Orchestration multi-modèles : routage par coût, latence et qualité
Acheminer différentes tâches vers différents modèles peut réduire les coûts ou la latence, mais seule une évaluation adaptée à la charge de travail permet de savoir si la complexité supplémentaire en vaut la peine. Les schémas, les mesures et les modes de défaillance.
Intermédiaire 12 min de lecture
Observabilité des applications LLM : traçage, coûts, latence et dérive de la qualité
Étendez l’observabilité standard par des traces multi-étapes, un coût attribuable, les versions de prompt et de modèle, des signaux de qualité évalués, des contrôles de confidentialité et des alertes dérivées de la charge.
Avancé 14 min de lecture
Injection de prompt et sécurité des LLM : modèles de menaces et défense en profondeur
L'injection de prompt est une catégorie permanente de risque pour la sécurité des LLM, et non une erreur de rédaction de prompt. Un guide de production consacré aux modèles de menaces, aux frontières des données, aux autorisations des outils, aux tests de régression, à la surveillance et à la réponse aux incidents.
Avancé 12 min de lecture
Choisir entre le prompting, le RAG et le fine-tuning (et quand les combiner)
Le prompting, le RAG et le fine-tuning sont les trois principaux leviers permettant d’adapter un LLM à votre problème. Chacun convient à certaines situations et non à d’autres. Voici un cadre de décision, leurs coûts réels et les architectures de production où leur combinaison excelle.
Avancé 9 minutes
LangSmith en 10 minutes
LangChain. Le cofondateur de LangChain propose une visite guidée d’une trace LLM, d’un projet et d’un jeu de données — coût des tokens, latence, taux d’erreur, agrégation des retours et exploration du span d’une seule étape de récupération. C’est l’équivalent visuel le plus proche de ce que décrit l’article lorsqu’il affirme que « chaque appel est un span » et explique pourquoi les traces structurées sont supérieures aux simples journaux produits par des instructions d’affichage.
Avancé 154 minutes
Instrumentation et évaluation des LLM
Hamel Husain. Hamel Husain, Eugene Yan, Brian Bischof, Harrison Chase et Shreya Shankar travaillent sur le traçage, l’analyse des journaux, les LLM utilisés comme juges et le flux d’examen de véritables données de production. Consacrez à cette vidéo la même attention qu’à un long podcast : c’est sur YouTube l’analyse la plus approfondie de la thèse « examinez vos traces » défendue dans l’article.
Avancé 77 minutes
Ingénierie de prompts en IA : une plongée approfondie
Anthropic. Quatre spécialistes des prompts chez Anthropic — issus de la recherche, de l’alignement, de l’IA appliquée et des relations avec les développeurs — décrivent longuement leur travail quotidien : comment ils révisent des prompts sous pression, comment ils abordent l’« honnêteté » des instructions et dans quels cas les structures XML sont utiles ou non. Le modèle en couches de l’article correspond directement à leur façon de décrire le travail ; c’est le meilleur moyen d’entendre ce modèle mental formulé à voix haute.
Avancé 25 minutes
Initiation aux prompts | Code avec Claude
Anthropic. L’équipe Applied AI d’Anthropic construit en direct un prompt consacré à des demandes d’indemnisation. Elle part d’une instruction vague et l’améliore jusqu’à obtenir un résultat qu’un développeur pourrait réellement livrer, en montrant les révisions des couches système et développeur décrites dans l’article. Regardez cette vidéo avant de relire la liste de contrôle de l’article sur les exemples, la structure des sorties et le traitement des refus.
Avancé