

Aplicaciones LLM en producción
Diseña, lanza, supervisa y opera aplicaciones LLM una vez superada la fase de demostración.
17 contenidos (12 artículos · 5 vídeos)
Comienza aquí
Una selección inicial antes de explorar todo el contenido.
 12 min de lectura
Diseñar prompts para producción: capas del sistema, del desarrollador y del usuario
Un patrón de gobernanza para separar las instrucciones fiables, los datos en tiempo de ejecución y la entrada del usuario, y después versionar, evaluar, desplegar y observar los prompts según el riesgo.
Avanzado 10 min de lectura
Modos de fallo de IA en producción: qué falla después de la demostración
Los sistemas de IA suelen fallar de formas predecibles: alucinaciones, contexto obsoleto, complacencia, inyección de prompts, uso inseguro de herramientas, deriva de esquemas y gestión deficiente de fallos. Este registro de modos de fallo está dirigido a equipos que despliegan flujos de trabajo reales.
AvanzadoMás sobre este tema
 8 min de lectura
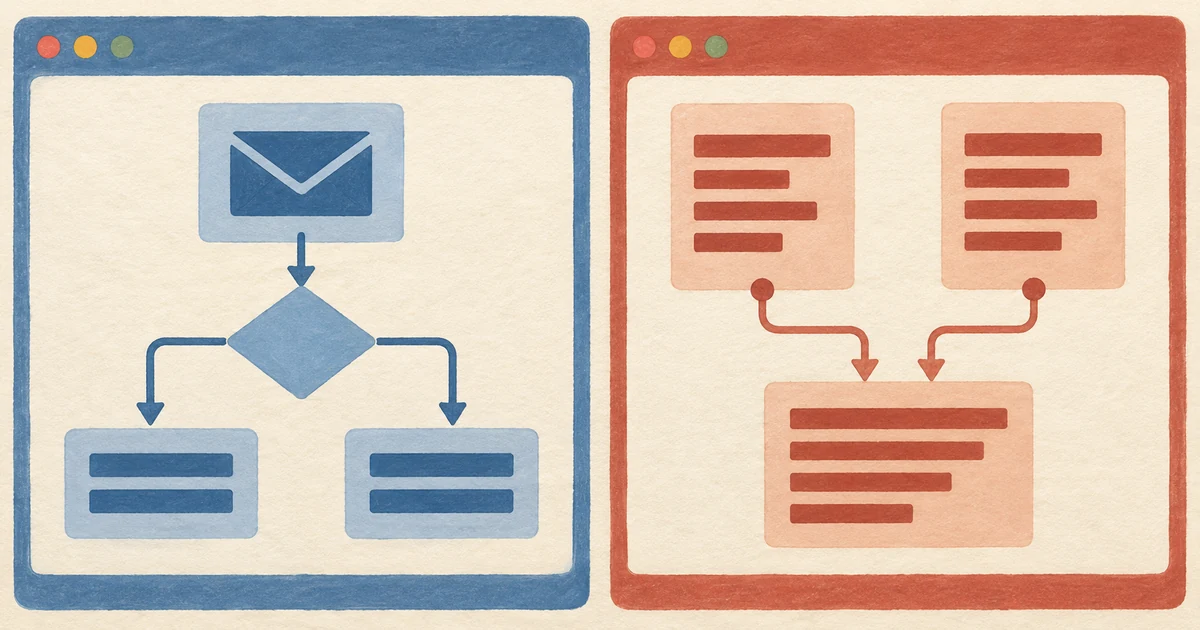
Hermes vs n8n: elige según el trabajo (y cuándo usar ambos)
Un marco de decisión para elegir entre Hermes Agent y n8n: la integración determinista se queda en n8n, mientras que una etapa de la API de Hermes autenticada mediante bearer o una ruta separada de webhooks para eventos se ocupa del trabajo acotado del agente.
Intermedio 10 min de lectura
Pila experimental con dos DGX Spark, DeepSeek-V4-Flash, n8n y Hermes
Cómo evaluar una ruta experimental de la comunidad con dos DGX Spark para DeepSeek-V4-Flash, con n8n en el borde determinista y Hermes en la ruta de juicio.
Avanzado 69 minutos
El panorama de los agentes: lecciones aprendidas al llevar agentes a producción
MLOps.community. El vicepresidente de IA de Prosus y un ingeniero de IA explican qué falló realmente cuando desplegaron agentes en las empresas de la cartera del grupo: pruebas de penetración de inyección de prompts antes del lanzamiento; una escritura insegura cuando un agente de Jira no interpretó correctamente la taquigrafía humana; contexto obsoleto gestionado haciendo que los agentes expusieran sus supuestos; y mecanismos alternativos que fusionaban o retiraban agentes cuando estos empezaban a añadir carga cognitiva. Es como ver el registro de modos de fallo del artículo reproducido en una autopsia en directo.
Avanzado 12 min de lectura
Optimización de costes en inferencia: almacenamiento en caché de prompts, enrutamiento y control de salida
Construye un modelo de costes de inferencia basado en trazas, optimiza los mayores contribuyentes medidos y demuestra que cada cambio preserva la calidad de la tarea.
Avanzado 13 min de lectura
Ajuste fino en 2026: un experimento de LoRA y QLoRA basado en evidencia
Decide si el ajuste eficiente en parámetros está justificado, gobierna los datos, fija un experimento reproducible, compara resultados en conjuntos retenidos y pruebas de seguridad, y realiza benchmarks del servicio antes del despliegue.
Avanzado 12 min de lectura
Cómo diseñar herramientas MCP que los LLM utilicen correctamente
La mayoría de las herramientas MCP que vemos son técnicamente correctas, pero en la práctica no sirven. Los LLM las ignoran, las utilizan mal o las invocan de formas poco útiles. Estos son los principios para diseñar herramientas que adopten de manera natural, con ejemplos de errores habituales y sus soluciones.
Avanzado 12 min de lectura
Cómo crear memoria para agentes de larga duración
Los agentes de larga duración necesitan un diseño de persistencia propio: procedencia, confirmación, aislamiento por inquilino, pruebas de recuperación, conservación, corrección y eliminación verificable.
Avanzado 10 min de lectura
Orquestación de múltiples modelos: enrutamiento por coste, latencia y calidad
Enrutar diferentes tareas a distintos modelos puede reducir el coste o la latencia, pero solo una evaluación específica de la carga de trabajo puede demostrar si la complejidad añadida vale la pena. Los patrones, las mediciones y los modos de fallo.
Intermedio 12 min de lectura
Observabilidad para aplicaciones con LLM: trazas, costes, latencia y deriva de calidad
Amplía la observabilidad habitual con trazas multietapa, costes atribuibles, versiones de prompt y modelo, señales de calidad evaluada, controles de privacidad y alertas derivadas de la carga de trabajo.
Avanzado 14 min de lectura
Inyección de prompts y seguridad de los LLM: modelos de amenazas y defensa en profundidad
La inyección de prompts es una categoría permanente de riesgo para la seguridad de los LLM, no un error de redacción de prompts. Esta guía para producción aborda modelos de amenazas, límites de datos, permisos de herramientas, pruebas de regresión, monitorización y respuesta a incidentes.
Avanzado 12 min de lectura
Elegir entre prompting, RAG y fine-tuning (y cuándo combinarlos)
El prompting, RAG y el fine-tuning son las tres grandes palancas para adaptar los LLM a un problema. Cada una resulta adecuada en situaciones diferentes. Este marco ayuda a elegir, explica sus costes reales y muestra los patrones de producción en los que conviene combinarlas.
Avanzado 9 minutos
LangSmith en 10 minutos
LangChain. El cofundador de LangChain recorre una traza, un proyecto y un conjunto de datos de LLM: coste en tokens, latencia, tasa de errores, agregación de comentarios y análisis detallado del span correspondiente a un único paso de recuperación. Es el equivalente visual más cercano a lo que describe el artículo cuando afirma que «cada llamada es un span» y explica por qué las trazas estructuradas superan a los registros mediante print.
Avanzado 154 minutos
Instrumentación y evaluación de LLM
Hamel Husain. Hamel Husain, Eugene Yan, Brian Bischof, Harrison Chase y Shreya Shankar trabajan con trazas, análisis de registros, LLM como juez y el proceso de revisión de datos reales de producción. Dedícale el tiempo que dedicarías a un pódcast extenso: es la mejor explicación en profundidad de YouTube sobre la tesis «observa tus trazas» del artículo.
Avanzado 77 minutos
Ingeniería de prompts de IA: un análisis profundo
Anthropic. Cuatro especialistas en prompts de Anthropic —investigación, alineación, IA aplicada y relaciones con desarrolladores— explican en detalle su trabajo cotidiano: cómo editan prompts bajo presión, cómo entienden la «honestidad» en las instrucciones y cuándo ayudan las estructuras XML o cuándo no. El modelo por capas del artículo encaja directamente con su descripción del trabajo; es la mejor forma de escuchar ese modelo mental expresado en voz alta.
Avanzado 25 minutos
Fundamentos del prompting | Programar con Claude
Anthropic. Es una sesión de creación en directo en la que el equipo de IA aplicada de Anthropic trabaja con un prompt para reclamaciones de seguros: parte de una instrucción imprecisa e itera hasta obtener algo que un desarrollador llevaría realmente a producción. De este modo muestra las revisiones de las capas del sistema y del desarrollador descritas por el artículo. Conviene verlo antes de releer la lista de comprobación sobre ejemplos, estructura de salida y gestión de rechazos.
Avanzado