

RAG und Wissenssysteme
Persönliches RAG, Retrieval im Produktivbetrieb, Chunking, Berechtigungen, Ingestion und Quellengrenzen.
13 Beiträge (7 Artikel · 6 Videos)
Hier beginnen
Einige gute Beiträge für den Einstieg, bevor Sie die vollständige Übersicht durchsuchen.
 10 Min. Lesezeit
Ein persönliches RAG erstellen: mit eigenen Dokumenten chatten
Einen begrenzten dokumentengestützten Assistenten aufbauen und bewerten. Gehostete Notebooks, Projektarbeitsbereiche und konfigurierbares Retrieval vergleichen, ohne Herkunft oder Berechtigungen zu schwächen.
Mittelstufe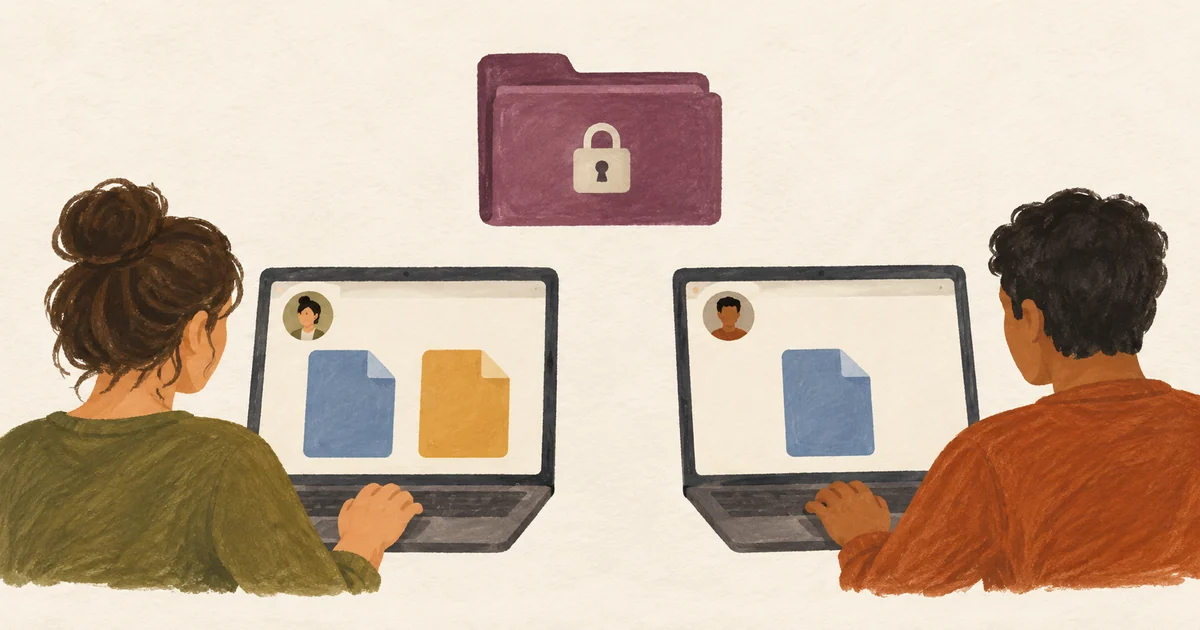 10 Min. Lesezeit
RAG für Unternehmenswissen: Berechtigungen, Datenlecks und Quellengrenzen
Ein Assistent für Unternehmenswissen ist nur sicher, wenn sein Retrieval Berechtigungen respektiert. So gestalten Sie RAG-Quellengrenzen, ACL-Filterung, Dokumentverantwortung, Protokollierung, den Umgang mit veralteten Quellen und sicheres Verweigerungsverhalten.
FortgeschrittenWeitere in diesem Thema
 9 Min. Lesezeit
Ein persönliches Wissenssystem zum Wiederfinden statt Horten
Ein klar begrenztes System vom Erfassen bis zum Wiederfinden mit festgelegten Einsatzfällen, Abruftests, Prüfterminen, Löschregeln und Warnungen zu sensiblen Notizen, Daten anderer Personen und Konten bei Anbietern.
Mittelstufe 20 Minuten
Berechtigungen und Zugriffskontrolle für RAG – ein ausführliches Tutorial
Paragon. Das Video erläutert das Berechtigungsproblem produktiver RAG-Systeme und vergleicht Werkzeugaufrufe, Namespaces, ACL-Tabellen und beziehungsbasierte Berechtigungen. Damit stützt es direkt die Kernregel des Artikels: Retrieval darf nur Quellen zurückgeben, die der aktuelle Nutzer sehen darf, und die Berechtigungen der Quellsysteme dürfen nicht nachträglich ergänzt werden.
Fortgeschritten 7 Minuten
Besseres RAG und leistungsfähigere KI-Agenten mit Docling
IBM Technology. Das Video erklärt die Aufnahmeseite von RAG und Agenten: PDFs und andere Dateien werden so vorbereitet, dass Dokumentstruktur, Tabellen und Layout für das nachgelagerte Retrieval erhalten bleiben. Das stützt die Warnung des Artikels, dass Qualität und Sicherheit von RAG bereits vor dem Embedding beginnen, besonders beim Parsen komplexer Geschäftsdokumente.
Fortgeschritten 11 Min. Lesezeit
Sichere Dokumentenaufnahme für RAG: PDFs, OCR, Metadaten und Aufbewahrung
Die Qualität von RAG beginnt vor dem Retrieval. Ein Leitfaden zur sicheren Aufnahme von PDFs, OCR-Text, Metadaten, Berechtigungen und aktuellen Quellen sowie zu Löschung, Malware-Risiken und betrieblicher Verantwortung.
Fortgeschritten 11 Min. Lesezeit
Einen KI-Agenten für den Kundensupport entwerfen: Triage, Wissen, Aktionen und Eskalation
Ein an der Warteschlange bewertetes Referenzdesign für Support-Triage, Retrieval, Antwortentwürfe, kontrollierte Aktionen und menschliche Eskalation mit den Richtlinien- und Messgrenzen für einen sicheren Pilotbetrieb.
Mittelstufe 11 Min. Lesezeit
Ihren ersten KI-Agenten in n8n erstellen: ein Lead-Triage-Workflow von Anfang bis Ende
Ein anhand der Dokumentation geprüftes Design für die Lead-Triage in n8n: Eingaben validieren, Agent-Tools einschränken, strukturierte Ausgaben validieren, einen atomaren Vorschlag speichern und jede kundensichtbare Aktion durch eine Freigabe absichern.
Mittelstufe 12 Min. Lesezeit
Prompting, RAG oder Fine-Tuning wählen — und wann Sie sie kombinieren sollten
Prompting, RAG und Fine-Tuning sind die drei großen Hebel, um große Sprachmodelle an Ihr Problem anzupassen. Jeder eignet sich für bestimmte Probleme und für andere nicht. Ein Entscheidungsrahmen, die realistischen Kosten jedes Ansatzes und erfolgreiche Kombinationsmuster für den Produktivbetrieb.
Fortgeschritten 11 Minuten
Wie Sie NotebookLM für Anfänger im Jahr 2024 verwenden (NotebookLM-Tutorial)
TheAIGRID. Dieser ältere funktionsorientierte Rundgang zeigt gemischte Uploads, Fokus auf eine Quelle, Briefing-Dokumente und Audio Overviews in der damaligen Oberfläche. Er hilft, Workflow-Bausteine zu erkennen, bestätigt aber weder die aktuelle Gemini-Notebook-Oberfläche noch die heutige Funktionsverfügbarkeit.
Mittelstufe 26 Minuten
So verwenden Sie NotebookLM (Googles KI-„Tool zum Verstehen“)
Tiago Forte. Tiago Forte, Autor von _Building a Second Brain_, demonstriert das damals NotebookLM genannte Produkt mit Notizen, PDFs und Ausschnitten. Das nützliche Muster besteht darin, einen begrenzten Quellenbestand auszuwählen, Dokumentfragen zu stellen, verlinkte Passagen zu prüfen und die entstandenen Artefakte in einen bestehenden Wissensworkflow einzuordnen.
Mittelstufe 9 Minuten
RAG vs. Fine-Tuning
IBM Technology. Ein fokussierterer Vergleich der beiden Ansätze, die Teams am häufigsten verwechseln. Das Video vertieft Datenaktualität, Quellenzuordnung und den Geschwindigkeitsvorteil von Fine-Tuning zur Inferenzzeit. Es ist besonders nützlich, wenn Sie gegen ein unnötiges Fine-Tuning-Projekt argumentieren möchten.
Fortgeschritten 13 Minuten
RAG vs. Fine-Tuning vs. Prompt-Engineering: KI-Modelle optimieren
IBM Technology. Eine klare Whiteboard-Darstellung aller drei Ansätze und ihrer jeweiligen Kosten: Retrieval-Latenz, Rechenaufwand für das Training und katastrophales Vergessen sowie die Grenzen reiner Prompt-Lösungen. Außerdem zeigt das Video, welche Kombinationen im Produktionseinsatz sinnvoll sind. Das abschließende Beispiel eines KI-Systems für den Rechtsbereich entspricht nahezu genau dem Argument des Artikels zur Kombination der Ansätze.
Fortgeschritten